Meta: GenRecs Tokenization steigert Anzeigen-Conversions um 0,35 Prozent mit semantischem Vokabular
Meta zufolge hat die neue GenRecs Tokenization, die Anzeigen, Produkte und Seiten statt mit eigenen IDs mit Tokens aus einem stabilen semantischen Vokabular abbildet, in Kombination mit dem Generative Ads Model (GEM) und dem Adaptive Ranking Model über alle Oberflächen hinweg ein Plus von 0,35 Prozent bei den Conversions erzielt. Das Unternehmen beschreibt den Ansatz als grundlegende Datenrepräsentation für Generative Recommenders (GenRecs) in seinen Anzeigensystemen.
- Metas GenRecs Tokenization bildet Anzeigen, Produkte, Seiten und Pixel statt mit eigenen IDs mit Tokens aus einem stabilen semantischen Vokabular ab.
- Zusammen mit GEM und dem Adaptive Ranking Model brachte sie laut internen Meta-Daten, gemessen im Februar 2026, ein Plus von 0,35 Prozent bei den Conversions.
- Der Tokenizer arbeitet in drei Stufen: kodieren, in Unterräume zerlegen und mit Codebooks quantisieren.
- Laut Meta profitieren vor allem Tail- und neue Anzeigen, da sie das Wissen des Modells über ähnliche Elemente übernehmen.
- Über acht Tokenizer-Versionen hinweg korrelierten intrinsische Qualitätsmaße laut Meta stark mit der Genauigkeit der CTR-Vorhersage.
Von Item-IDs zu semantischen Tokens
GenRecs steht für Generative Recommenders. Laut Meta verschiebt sich damit der Ansatz des Unternehmens: Statt jeden einzelnen Anzeigenkandidaten zu bewerten, kommt eine LLM-Architektur zum Einsatz, die gleichzeitig über Anzeigeninhalte und Nutzerpräferenzen nachdenkt. Ziel ist es, über das Abgleichen von Klickmustern hinauszugehen und die zugrunde liegenden Präferenzen der Nutzer zu verstehen.
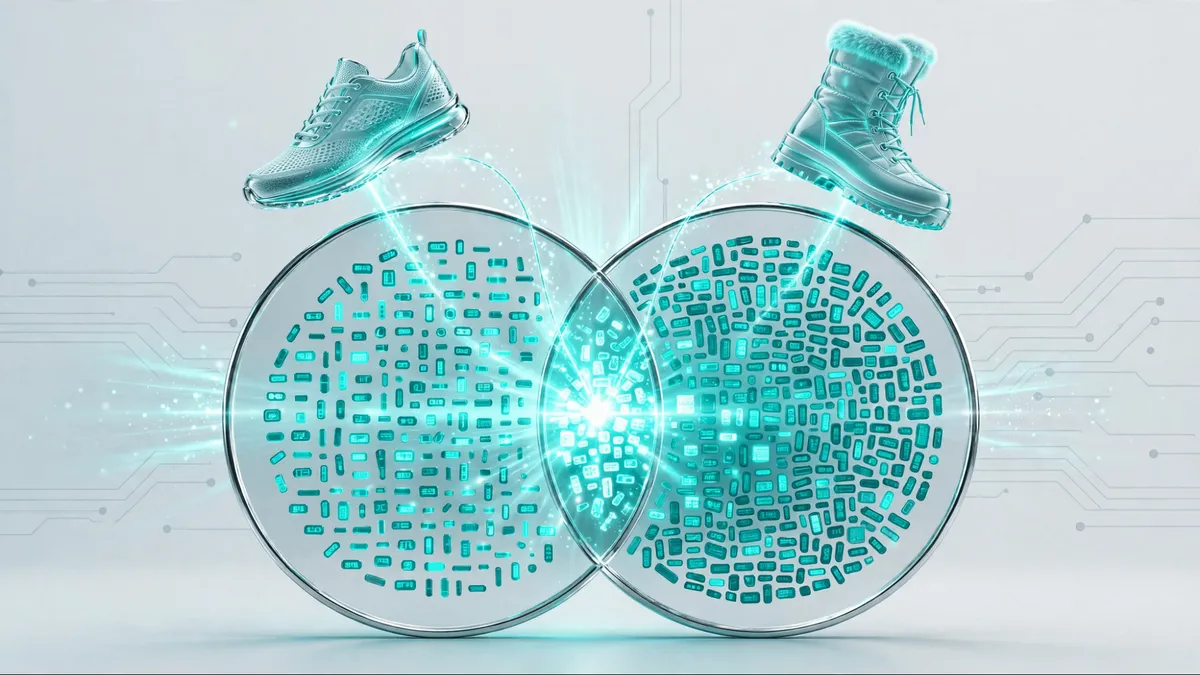
GenRecs Tokenization bildet dafür die Datenebene. Statt für jedes Element eine eigene ID zu führen, beschreibt das System jedes Element mit einer Reihe von Tokens aus einem kleinen semantischen Vokabular, ähnlich wie Sprachmodelle Konzepte aus Tokens zusammensetzen. Weil die Tokens beschreiben, was ein Element ist, kann das Modell ein Element ohne Interaktionshistorie mit Elementen in Beziehung setzen, die es bereits gut kennt. Meta nennt als Beispiel einen neu eingeführten Trailschuh, der übernimmt, was das Modell über diese Kategorie gelernt hat, statt mit einer leeren Repräsentation zu starten.
Meta zufolge ermöglicht der Ansatz GenRecs sowohl für Retrieval als auch für Ranking über alle Elementtypen im System hinweg, darunter Anzeigen, Produkte, Seiten und Pixel.
So funktioniert der Tokenizer
Vortrainierte multimodale Modelle lesen jede Anzeige, jedes Produkt und jede Seite, einschließlich Text und Bildern, und kodieren sie in ein Embedding, das Weltwissen enthält. Der Tokenizer verbindet dieses Inhaltssignal mit Repräsentationen, die aus dem Nutzerverhalten gegenüber den Elementen gelernt wurden, und quantisiert das Ergebnis zu einer kurzen Folge diskreter Tokens. Ähnliche Elemente teilen sich Tokens, so wie verwandte Wörter gemeinsame Wurzeln haben.
Meta beschreibt eine Pipeline in drei Stufen:
- Jedes Element wird in einen semantischen Embedding-Raum kodiert.
- Das Embedding wird in voneinander unabhängige Unterräume zerlegt.
- Jeder Unterraum wird per Quantisierung einem Eintrag in einem Codebook zugeordnet.
Für viele Anzeigenrepräsentationen nutzt GenRecs Tokenization nach Angaben des Unternehmens Präfix-N-Gramme, die einen gelernten Encoder, Residual-Dekomposition, gelernte Vektor-Codebooks und Token-Parametrisierung kombinieren.
Meta berichtet außerdem, dass sich die Qualität des Tokenizers anhand intrinsischer Maße beurteilen lasse: Cluster-Reinheit, Verteilungsbalance und Codebook-Auslastung. Über die acht getesteten Tokenizer-Versionen hinweg beobachtete das Unternehmen nach eigenen Angaben eine starke Korrelation zwischen diesen Kennzahlen und der nachgelagerten Ranking-Genauigkeit: Besser bewertete Versionen zeigten auch eine höhere Genauigkeit bei der CTR-Vorhersage für Anzeigenmodelle.
Kaltstart und Feedback-Schleife
Meta zufolge zeigt sich der Hauptnutzen bei Tail-Anzeigen, die weniger Impressionen sammeln. Die Tokenisierung erlaubt es Empfehlungsmodellen, über die gemeinsame Inhaltsstruktur zwischen ihnen zu generalisieren, die Kaltstart-Leistung zurückzugewinnen und Wissen zwischen Entitäten zu übertragen. Das Unternehmen nennt weitere Vorteile: schnelleres Lernen bei neuen Entitäten wie frischen Anzeigen und Nischenprodukten, die Übertragung von Erkenntnissen zwischen Kampagnen eines Werbetreibenden und eine direkte Schnittstelle zwischen vortrainierten Sprachmodellen und Anzeigeninhalten.
Das Unternehmen beschreibt zudem einen Flywheel-Effekt: Bessere Vorhersagen für Tail-Anzeigen liefern bessere Trainingsdaten, was wiederum die Vorhersagen für alle Anzeigen verbessert. Meta ergänzt, dass die Tokens im Produktivbetrieb von Ranking und Retrieval „die Skalierungskurve entlang von Sequenzlänge, Trainingsdaten und Modellarchitektur verbiegen“. Der Conversion-Zuwachs von 0,35 Prozent ist in einer Fußnote als interne Meta-Daten ausgewiesen, gemessen im Februar 2026.
Beim Retrieval erreicht laut Meta eine Two-Tower-Architektur auf Basis eines gemeinsamen LLM-Encoders eine Retrieval-Qualität auf dem Stand der Technik und bleibt dabei effizient ausspielbar. Die Leistung klassischer Two-Tower-Modelle erreicht sie mit einem Bruchteil der Trainingsdaten. Auf demselben Vokabular baut Meta nun ein Reasoning-fähiges Ranking aus.
Was für Werbetreibende und Metas Anzeigen-Stack als Nächstes kommt
Meta nennt drei Stoßrichtungen: die Kaltstart-Generalisierung vertiefen, indem die Tokenisierung auf alle Elemente ausgeweitet wird, die Tokenizer-Qualität als vorrangiges Ziel behandeln und LLM-native Architekturen effizient ausspielen. Zum letzten Punkt sagt das Unternehmen, eine vollständig verbalisierte Tokenisierung liefere zwar das reichhaltigste Bild einer Anzeige, erfordere aber Kontextfenster, die im Anzeigenmaßstab unpraktikabel seien. Deshalb kombiniere man verdichtete verbalisierte Tokens mit semantischen IDs, um die Reasoning-Qualität bei akzeptabler Latenz zu halten.
Da intrinsische Qualitätsmaße die nachgelagerten Ranking-Gewinne vorhersagen, kann Meta nach eigenen Angaben den Tokenizer iterieren, ohne auf einen vollständigen Modelltrainingszyklus zu warten. Mit Blick auf die weitere Zukunft prüft das Unternehmen, ob ein gemeinsamer Token-Raum für Text-, Bild-, Audio- und Videoinhalte von Anzeigen separat gelernte Embeddings ersetzen könnte.
Für Werbetreibende lautet das praktische Versprechen: besseres Matching bei neuen und volumenschwachen Anzeigen, wo laut Meta die Wirkung für Werbetreibende am größten ist. Das einzige quantifizierte Ergebnis in der Quelle ist der Conversion-Zuwachs von 0,35 Prozent, den Meta selbst ausweist.
Engineering at Meta: GenRecs Tokenization: Transforming Ads Recommendation at Meta with Stable Model Vocabulary