Meta veröffentlicht Muse Spark Open: Open-Weight-Modell mit 816 Milliarden Parametern für Coding-Agenten
Meta hat die Gewichte von Muse Spark Open veröffentlicht, einem omnimodalen Mixture-of-Experts-Modell mit 816B Parametern, das gemeinsam mit Muse Code für Workflows von Coding-Agenten trainiert wurde. Der Inferenzanbieter Baseten, der die Details publiziert hat, erklärt, das Modell sei ab Tag 0 über seine Model APIs und Dedicated Inference verfügbar.
- Meta hat die Gewichte von Muse Spark Open veröffentlicht, einem omnimodalen MoE-Modell mit 816B Parametern, 42,7B aktiven Parametern und einem Kontextfenster von 1M Token.
- Das Modell wurde gemeinsam mit Muse Code für Workflows von Coding-Agenten trainiert und akzeptiert Text, Bild, Video und Audio als Eingabe.
- Ein hybrides Design aus globaler und lokaler Attention senkt laut Baseten den KV-Cache-Speicherbedarf bei 128K Kontext um rund das 3,7-Fache.
- Baseten betreibt einen NVFP4-Checkpoint von rund 540 GB, der auf einen einzelnen 4×GB300-Knoten passt.
- Es ist ab sofort über die Baseten Model APIs und Dedicated Inference mit einem OpenAI-kompatiblen Endpunkt verfügbar.
Das bietet Muse Spark Open
Laut Baseten hat Muse Spark Open insgesamt 816B Parameter, von denen bei der Inferenz 42,7B aktiv sind, sowie ein Kontextfenster von 1M Token. Das Modell akzeptiert Text, Bild, Video und Audio als Eingabe und gibt Text aus. Baseten bezeichnet es als das bislang leistungsfähigste Open-Weights-Modell aus den USA.
Das Modell wurde gemeinsam mit Muse Code trainiert und ist gezielt für Workflows von Coding-Agenten ausgelegt. Es lässt sich auch mit Coding-Agenten von Drittanbietern wie OpenCode, Pi und Deep Agents Code nutzen.
Die omnimodale Eingabe ermöglicht laut Baseten Workflows, die reine Textmodelle nicht abdecken können, sofern der Agent Bild-, Video- oder Audioeingaben unterstützt:
- UI-Debugging per Screenshot: Der Agent vergleicht einen Screenshot einer gerenderten Seite mit einem Design-Mockup oder einem Fehlerbild und korrigiert den Layout-Code.
- Vom Video zum Testfall: Ein Entwickler zeichnet einen Fehler auf dem Bildschirm auf, der Agent extrahiert die Schritte und schreibt ein Reproduktionsskript oder einen End-to-End-Test.
- Sprachgesteuertes Pair Programming: Der Entwickler spricht und tippt gleichzeitig, wobei Audio direkt als Eingabe dient und nicht zuvor transkribiert wird.
Benchmarks und Einordnung
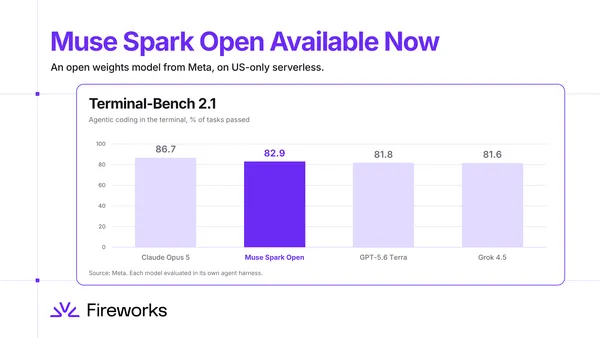
Nach den von Meta veröffentlichten Benchmark-Ergebnissen ist Muse Spark Open bei agentischem Coding und Wissensarbeit konkurrenzfähig zu Modellen anderer Frontier-Labore. Bei den Benchmarks für agentisches Coding wurde jedes Modell mit dem Coding-Agenten seines eigenen Labors getestet: Muse Spark mit Muse Code, Claude Opus 5 mit Claude Code und GPT-5.6 Terra mit Codex. Die Werte spiegeln daher jedes Modell in dem Tooling wider, für das es entwickelt wurde, und nicht in einer gemeinsamen Testumgebung.
Der Vergleich umfasst das jeweilige Flaggschiffmodell der Labore, klammert aber die darüberliegenden Spitzenmodelle aus, nämlich Claude Fable 5.1 und GPT-6 Astra.
Basetens eigene Einschätzung fällt vorsichtiger aus. In routinemäßigen Agentenschleifen, etwa beim Ausführen von Befehlen, Lesen der Ausgabe und Beheben von Fehlern, soll sich Muse Spark Open ähnlich anfühlen wie die führenden geschlossenen Modelle. Bei umfangreichen Änderungen über mehrere Dateien und viele Schritte hinweg müssten Nutzer damit rechnen, dass es mehr Anleitung oder mehr Wiederholungen braucht als Claude Opus 5 oder GPT-5.6 Terra. Gegenüber Grok 4.5 und Gemini 3.6 Flash schlägt es sich dagegen gut. Wenn ein Agent seine Arbeit dokumentieren muss, schneidet es besser ab als jedes andere Modell in der Grafik mit Ausnahme von Opus 5.
Architektur für lange Agentensitzungen
Coding-Agenten lesen Kontext, denken nach, generieren und lesen Ergebnisse in einer engen Schleife erneut ein und lassen mitunter parallel Subagenten im Hintergrund laufen. Das erfordert hohen Durchsatz und eine effiziente Speichernutzung über lange Kontexte. Muse Spark Open begegnet dem mit zwei Designentscheidungen.
Die erste ist ein komprimierter Mixture-of-Experts-Block. Ein gemeinsamer Pooler komprimiert den Eingabevektor, bevor er die Experten erreicht, und ein gemeinsamer Unpooler projiziert deren kombinierte Ausgabe zurück auf die ursprüngliche Dimension. Der Router, der für jedes Token die Experten auswählt, liest weiterhin den Vektor in voller Breite. Laut Baseten halbiert das die Parameter jedes Experten, verkleinert das Gesamtmodell gegenüber einem unkomprimierten Design um rund 800B Parameter, schafft GPU-Speicher für größere KV-Caches und mehr parallele Sequenzen und verringert den Datenverkehr zwischen den GPUs in der MoE-Schicht.
Die zweite ist ein hybrider Attention-Plan. Von den 62 Schichten des Modells sind 46 lokale Attention-Schichten mit einem Gleitfenster von 2048 Token und Rotary Position Embeddings, und 16 sind globale Attention-Schichten, die die gesamte Sequenz ohne Positionskodierung sehen. Lokale Schichten halten nur die jüngsten 2048 Token in ihrem KV-Cache, während der volle Kontext in den globalen Schichten erhalten bleibt. Laut Baseten senkt das den KV-Cache-Speicherbedarf bei 128K Token Kontext um rund das 3,7-Fache, von 31 GiB auf 8,4 GiB pro Sequenz, und die Einsparung wächst mit der Kontextlänge.
Betrieb und Verfügbarkeit
Baseten betreibt einen NVFP4-Checkpoint, der für Blackwell optimiert ist. Die Expertengewichte werden in 4 Bit gespeichert, während für die Attention-Gewichte und die Experten in der ersten und letzten Schicht volles bf16 erhalten bleibt. Dadurch sinkt die Gewichtsgröße von rund 1,6 TB auf 540 GB, sodass das gesamte Modell auf einen einzelnen 4×GB300-Knoten passt und ein Multi-Node-Interconnect für Gewichte und KV-Cache entfällt. Der frei gewordene Speicher geht in den KV-Cache, was mehr gleichzeitige Agentensitzungen pro Knoten erlaubt.
Muse Spark Open ist ab sofort über die Baseten Model APIs verfügbar. Der Endpunkt ist OpenAI-kompatibel, sodass Entwickler einen bestehenden Coding-Agenten darauf umstellen können, ohne ihre Umgebung zu ändern. Tool Calling, Reasoning-Ausgabe und das volle Kontextfenster von 1M Token werden unterstützt. Für Teams, die Agenten in großem Maßstab betreiben, bietet Baseten zudem Dedicated-Inference-Deployments mit reservierter Kapazität an.
Was das für Entwickler bedeutet
Für Teams, die Coding-Agenten mit offenen Gewichten betreiben wollen, bietet die Veröffentlichung ein großes Modell mit multimodaler Eingabe und langem Kontextfenster, dazu einen OpenAI-kompatiblen Endpunkt, der den Aufwand für einen Test senkt. Die Benchmark-Zahlen stammen von Meta, und Basetens eigene Einschätzung deutet darauf hin, dass das Modell bei komplexen Aufgaben über mehrere Dateien hinweg mehr Wiederholungen benötigen könnte als die führenden geschlossenen Modelle. Teams sollten es mit ihren eigenen Workloads testen.
Baseten: Muse Spark Open, an open-weight model for coding agents