Microsofts Agent Lightning v1.0 trainiert KI-Agenten mit ihren echten Harnesses
Microsoft Research Asia hat Agent Lightning v1.0 als Open Source veröffentlicht. Das neu aufgebaute Reinforcement-Learning-Framework umfasst rund 3.500 Codezeilen und erlaubt es, dass dieselbe Harness, die im Einsatz läuft, direkt am Training des Agenten teilnimmt. Laut Microsoft stieg Qwen3.5-9B in einem durchgängigen Beispiel mit einem Coding-Agenten auf SWE-bench Verified von 41,8 auf 56,4 Prozent Pass@1.
- Microsoft Research Asia hat Agent Lightning v1.0 als Open Source veröffentlicht, ein neu aufgebautes Framework mit rund 3.500 Codezeilen.
- Harnessed Agentic RL lässt die produktive Agent-Harness über einen LLM-Proxy direkt am Training teilnehmen, ohne den Agenten neu zu implementieren.
- Agenten laufen als Standard-Kubernetes-Jobs, ohne Abhängigkeit von kostenpflichtigen kommerziellen Sandbox-Diensten.
- Collocated Async RL erreichte laut Microsoft etwa die doppelte End-to-End-Geschwindigkeit gegenüber synchronem RL bei weniger GPUs als herkömmliches asynchrones RL.
- Qwen3.5-9B stieg auf SWE-bench Verified von 41,8 auf 56,4 Prozent Pass@1, trainiert mit etwa 6.000 Samples.
Den Agenten trainieren, der tatsächlich zum Einsatz kommt
Reinforcement Learning (RL) ist ein Ansatz, bei dem KI-Systeme durch Versuch und Irrtum lernen und dabei über Belohnungen und Strafen gesteuert werden. Microsoft Research zufolge müssen Entwickler bei den meisten RL-Systemen für Agenten den Agenten im Trainings-Framework neu implementieren. Das ist aufwendig, und der trainierte Agent entspricht dann nicht ganz dem Agenten, der später im Einsatz ist.
Frühe RL-Systeme wie verl, AReaL und slime wurden unter der Annahme gebaut, dass das Trainings-Framework die Interaktionsschleife mit der Umgebung steuert. Echte Harnesses seien darüber hinausgewachsen, argumentieren die Forschenden. Coding-Agenten wie mini-SWE-agent, OpenHands, OpenCode, Claude Code und Codex bringen jeweils eigenes Kontextmanagement, eigene Tool-Protokolle, Ausführungslogik und Abhängigkeiten mit. Sie fürs Training nachzubauen, ist teuer, und die nachgebaute Version kann sich anders verhalten als die produktive.
Agent Lightning setzt einen LLM-Proxy zwischen Agent und Modell. Der Agent läuft wie gewohnt weiter: Der Endpunkt, der zuvor die Modell-API aufrief, wird einfach auf Agent Lightning umgeleitet, und das Trainings-Framework kann die Modellaufrufe beobachten und aufzeichnen. In v1.0 definieren die Forschenden dies formal als Harnessed Agentic RL: Welche Harness auch immer im Einsatz ist, sie nimmt auch am Training teil.
Architektur: drei Komponenten in 3.500 Zeilen
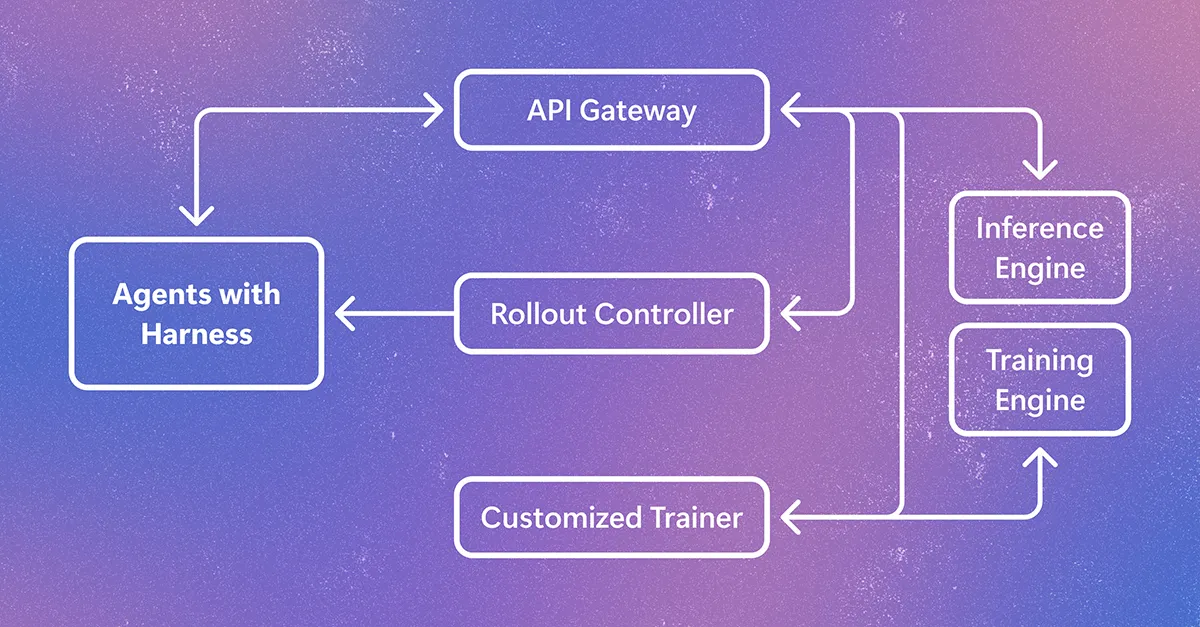
Einfachheit war laut Microsoft das erste Designprinzip. Das Framework besteht aus drei Kernkomponenten:
- API Gateway: speichert Rollouts, Modelle und Ereignisse und dient als OpenAI-kompatibler LLM-Proxy. Es ordnet jeden Modellaufruf seinem Rollout zu und zeichnet Prompts, Antworten und die fürs Training nötigen Log-Wahrscheinlichkeiten auf.
- Rollout Controller: startet und verwaltet die Ausführung der Agenten, entweder als lokale Prozesse oder als Standard-Kubernetes-Jobs, und hält die Ausführung vom Trainer getrennt.
- Customized Trainer: baut auf verl auf, erzeugt Rollouts, wartet auf deren Abschluss, sammelt Samples und stellt die finalen Trainings-Samples über einen Sample-Adapter zusammen.
Bei einer bestehenden Harness genügt es nach Angaben der Forschenden in der Regel, den Modell-Endpunkt auf den Agent-Lightning-Proxy zu richten, um sie ans RL-Training anzubinden.
Das Team nennt außerdem vier Herausforderungen, die entstehen, wenn die Harness und nicht der Trainer die Schleife steuert. Das Trainingssystem sieht nur Paare aus LLM-Anfragen und -Antworten, sodass ein Rollout in eine variable Anzahl von Samples zerfallen kann. Das betrifft Retokenisierung und das Zusammenführen von Samples, die Berechnung des Advantage, die Normalisierung des Loss und die Planung des Trainings-Backends. Wenn Text erneut durch ein Chat-Template und den Tokenizer läuft, können sich Token-Grenzen verschieben. Rollouts mit mehr Samples können zudem stärker gewichtet werden, sofern Baselines, Advantages und Loss nicht auf Rollout-Ebene behandelt werden.
Collocated Async RL und Kubernetes-Unterstützung
Die Rollout-Dauer schwankt zwischen Agenten stark. Synchrones RL wartet auf den langsamsten Agenten eines Batches und lässt GPUs brachliegen, während vollständig asynchrones RL die Auslastung erhöht, aber getrennte GPU-Pools für Rollout und Training benötigt. Agent Lightning v1.0 führt Collocated Async RL ein, bei dem sich Rollout und Modell-Updates dieselben GPUs teilen. Sobald genügend Rollouts gesammelt sind, hält das API Gateway neue Anfragen an, wartet, bis laufende abgeschlossen sind, und setzt den Rollout nach dem Update fort. Die Harness bekommt diesen Übergang nicht mit. In Experimenten berichtet Microsoft von einer etwa doppelt so hohen End-to-End-Geschwindigkeit gegenüber synchronem RL bei geringerem GPU-Bedarf als beim herkömmlichen asynchronen RL.
Viele Agenten parallel zu betreiben, verbraucht erheblich CPU, Arbeitsspeicher und Rechenleistung. Andere Frameworks für Harnessed Agentic RL hosten Agenten laut den Forschenden oft in kommerziellen Sandbox-Diensten wie Modal Sandbox oder E2B, wo die Kosten mit der Skalierung schnell steigen. Agent Lightning v1.0 führt Agenten stattdessen als Standard-Kubernetes-Jobs auf selbst verwalteten Clustern, Cloud-Kubernetes oder lokaler Infrastruktur aus, ohne Abhängigkeit von kostenpflichtigen Sandbox-Diensten.
Ergebnis beim Coding-Agenten und was es bedeutet
Als vollständiges Beispiel baute Microsoft eine durchgängige Pipeline für einen Coding-Agenten auf Basis von Qwen3.5-9B. Sie steigerte Pass@1 auf SWE-bench Verified von 41,8 auf 56,4 Prozent, ein absoluter Zuwachs von 14,6 Prozentpunkten, und das mit nur etwa 6.000 Trainings-Samples aus einem quelloffenen Datensatz.
Für Teams, die Agenten trainieren, lautet das Versprechen: weniger Aufwand für Neuimplementierungen und ein Trainingsaufbau, der dem entspricht, was in der Produktion läuft. Weil das Framework klein ist, lasse es sich laut Microsoft gut verstehen, anpassen und erweitern. Der Kubernetes-Ansatz soll die Kosten großer Rollouts senken und die Pipeline zugleich quelloffen und reproduzierbar halten. Die genannten Zahlen sind Microsofts eigene Angaben.