Microsoft will Azure Maia ab 2027 im Multi-Gigawatt-Maßstab ausrollen
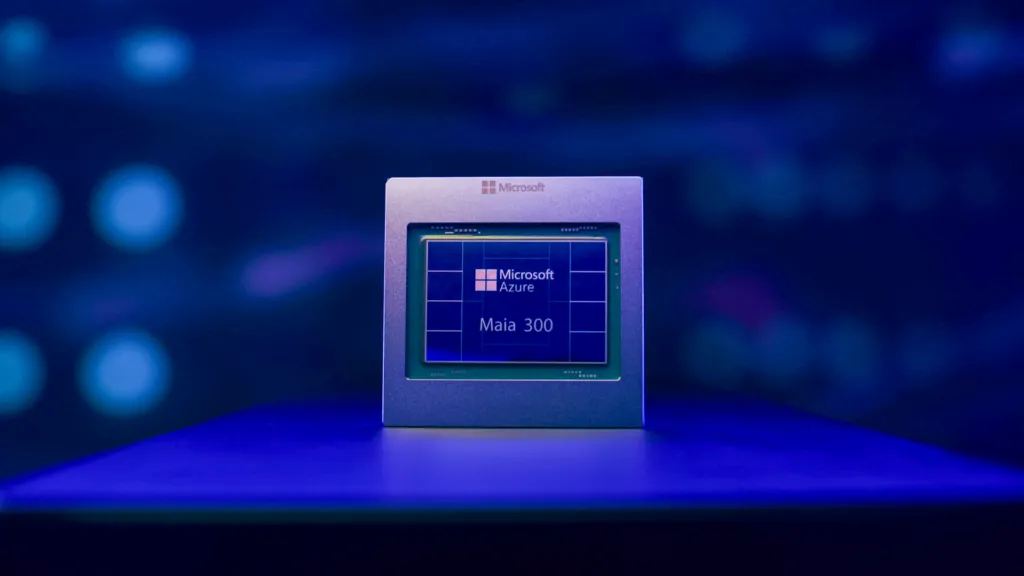
Microsoft will seine Chipfamilie Azure Maia ab 2027 in Multi-Gigawatt-Größenordnungen ausrollen und Maia damit zum wichtigsten Inferenzsystem für die eigenen Produkte und Dienste machen. Maia 200 verarbeitet laut Unternehmen bereits Produktions-Workloads, die dritte Generation Maia 300 geht im kommenden Jahr in den Produktiveinsatz.
- Microsoft will Azure Maia ab 2027 im Multi-Gigawatt-Maßstab ausrollen und zum wichtigsten Inferenzsystem für seine Produkte und Dienste machen.
- Maia 200 ist in Produktion und führt Copilot sowie Modelle von OpenAI, MAI und aus dem Open-Source-Bereich aus, GitHub Copilot und Microsoft Foundry sollen bis Jahresende folgen.
- Microsoft erwartet von Maia 300 40 % mehr Token pro Megawatt als bei führenden GPU-basierten Systemen.
- Ein Maia-300-Rack fasst 96 Beschleuniger bei 167 Kilowatt, mit 27,6 TB HBM und 1,7 PB/s aggregierter Bandbreite.
- Der Produktiveinsatz von Maia 300 beginnt 2027.
Maia 200 ist bereits in Produktion
Nach Angaben von Microsoft bedient Maia 200 inzwischen Produktions-Workloads, darunter Microsoft Copilot, und unterstützt das MAI-Team bei der Entwicklung von Modellen der nächsten Generation. GitHub Copilot und Microsoft Foundry sollen bis Jahresende folgen. Über diese Workloads hinweg führt Maia 200 Modelle von OpenAI, Microsofts eigene MAI-Modelle sowie führende Open-Source-Modellfamilien aus.
Maia 200 wird nach Unternehmensangaben in den USA, in Europa und in Australien eingesetzt. Microsoft gibt an, dass der Chip bei integrierten KI-Funktionen in Microsoft Teams, Copilot und Cowork bis zu 1,7-mal mehr Token pro Watt liefert als führende GPU-Infrastruktur.
Laut Microsoft arbeiten Software- und Hardwareteams früh zusammen, weil die Entwicklung von Silizium Jahre dauert. Ziel sei es, Modellarchitekturen und Skalierung vorauszuahnen und daraus mehr Speicherkapazität, höhere Bandbreite und mehr Beschleuniger zu machen, die als ein System zusammenarbeiten. Die Erfahrungen mit Maia 200 seien direkt in das Design von Maia 300 eingeflossen, so das Unternehmen.
Maia 300: Design mit Fokus auf Inferenz
Microsoft beschreibt Maia 300 als vollständiges intelligentes System für neuere KI-Workloads: Reasoning mit langem Kontext, latenzkritische Dialoganwendungen und anhaltende, mehrstufige agentische Aufgaben. Es ist die dritte Generation des Azure-Maia-Programms und nutzt eine Inference-first-Architektur für Workloads mit langem Kontext, hohem Speicherbedarf und starkem Decode-Anteil.
Microsoft erwartet, dass Maia 300 40 % mehr Token pro Megawatt liefert als führende GPU-basierte Systeme. In einer vollständigen Konfiguration mit 96 Beschleunigern bietet es laut Unternehmen bis zum 7-Fachen des Token-Durchsatzes von Maia 200 auf Rack-Ebene.
Die wichtigsten technischen Details laut Microsoft:
- Speicher: Acht HBM4-Stacks bieten 18,0 TB/s Spitzenspeicherbandbreite bei einer TDP von 950 Watt. On-Die-SRAM dient als softwaregesteuerter Zwischenspeicher, um den HBM zu entlasten.
- Chiplets: Ein Multi-Chiplet-Design trennt Rechen-, Speichercontroller- und I/O-Funktionen. Die Rechen-Chiplets werden im N2P-Prozess von TSMC gefertigt.
- Niedrige Präzision: Die Unterstützung fortschrittlicher Formate mit niedriger Präzision, darunter ein erweitertes MXFP4, senkt den Speicher- und Bandbreitenbedarf für Berechnungen und die KV-Cache-Ablage und ermöglicht größere Kontextfenster im gleichen Leistungsrahmen.
- Dataflow: Eine softwaredefinierte Dataflow-Architektur und KI-gestützte Kernel-Optimierung sollen Datenbewegungen verringern, die laut Microsoft in großen Inferenzsystemen zunehmend zum Engpass werden.
- Netzwerk: Ein eigener KI-Transport auf Basis von Ethernet-Infrastruktur soll von einem einzelnen Rack bis zu Rechenzentrumsmaßstab skalieren.
Maia-300-Rack-Systeme vereinen 96 Beschleuniger in einem Leistungsrahmen von 167 Kilowatt, mit 27,6 TB HBM-Kapazität und 1,7 PB/s aggregierter HBM-Bandbreite. Diese Dichte erlaubt es Microsoft nach eigenen Angaben, pro Rack mehr gleichzeitige KI-Interaktionen und größere Workloads zu bedienen.
Geplante Dienste und wie es weitergeht
Laut Microsoft sollen beide Generationen zusammen mehrstufige agentische Arbeit unterstützen, mit der GitHub Programmiererlebnisse effizienter bereitstellen kann, sowie Modellbereitstellung im Cloud-Maßstab für Microsoft Foundry über verschiedene Architekturen und Einsatzumgebungen hinweg. Außerdem sind sie für Inferenz und Datengenerierung für das MAI-Team gedacht und für latenzkritische Interaktionen, mit denen Dragon Copilot Arbeitsabläufe skalieren und den Verwaltungsaufwand von Klinikpersonal verringern soll.
Das Unternehmen verknüpft Maia mit der sogenannten Frontier Transformation, einer Strategie, die vom Silizium über Systeme bis zu Agenten auf einer offenen, heterogenen und modellvielfältigen Plattform optimiert. Maia sei ein grundlegender Baustein des Ansatzes, den Zugang zu erweitern und Kunden zu helfen, mehr Wert aus KI zu ziehen.
Für Kunden liegt der erklärte Nutzen in der Effizienz: mehr KI-Leistung pro Energieeinheit und bessere Wirtschaftlichkeit beim Ausbau von KI-Diensten. Die Zahlen sind Microsofts eigene Angaben und Vergleiche mit nicht genannten führenden GPU-Systemen. Der Produktiveinsatz von Maia 300 beginnt 2027, und Microsoft hat ein technisches Papier mit Architekturdetails veröffentlicht. Weitere Details zur Strategie will das Unternehmen auf der Microsoft Ignite 2026 in San Francisco und online vorstellen.
Microsoft: Microsoft to expand Azure Maia system to multi-gigawatt deployments