Microsofts StudentSim simuliert einzelne Lernende, um KI-Tutoren zu trainieren
Microsoft Research hat StudentSim vorgestellt, ein System, das personalisierte Simulatoren einzelner Lernender erstellt, damit sich KI-Tutoren bewerten und trainieren lassen, bevor sie mit echten Schülerinnen und Schülern getestet werden. Laut Microsoft handelt es sich um ein Forschungssystem und nicht um ein Produkt; im Unterricht ist es nicht im Einsatz.
- Microsoft Researchs StudentSim erstellt für jede Person einen personalisierten Simulator aus anonymisierten, öffentlich verfügbaren Lerndaten.
- Es ist ein Forschungssystem und kein Produkt, wird nicht im Unterricht eingesetzt und soll Lehrkräfte nicht ersetzen.
- StudentSimEval deckt Schach, Schreiben in Englisch als Zweitsprache und Mathematik ab und bewertet Verhaltenstreue und Reaktionsfähigkeit auf Anleitung.
- Im Schach erreichte StudentSim 0,5150 und 0,9067, GPT-5.4 kam auf 0,2316 und 0,7186.
- Ein mit StudentSim-Belohnungen trainierter Tutor erreichte 90,5 Prozent Genauigkeit, gegenüber 75,7 Prozent ohne RL und 71,6 Prozent mit GPT-5.4-Belohnung.
Warum die Tutorenforschung simulierte Lernende braucht
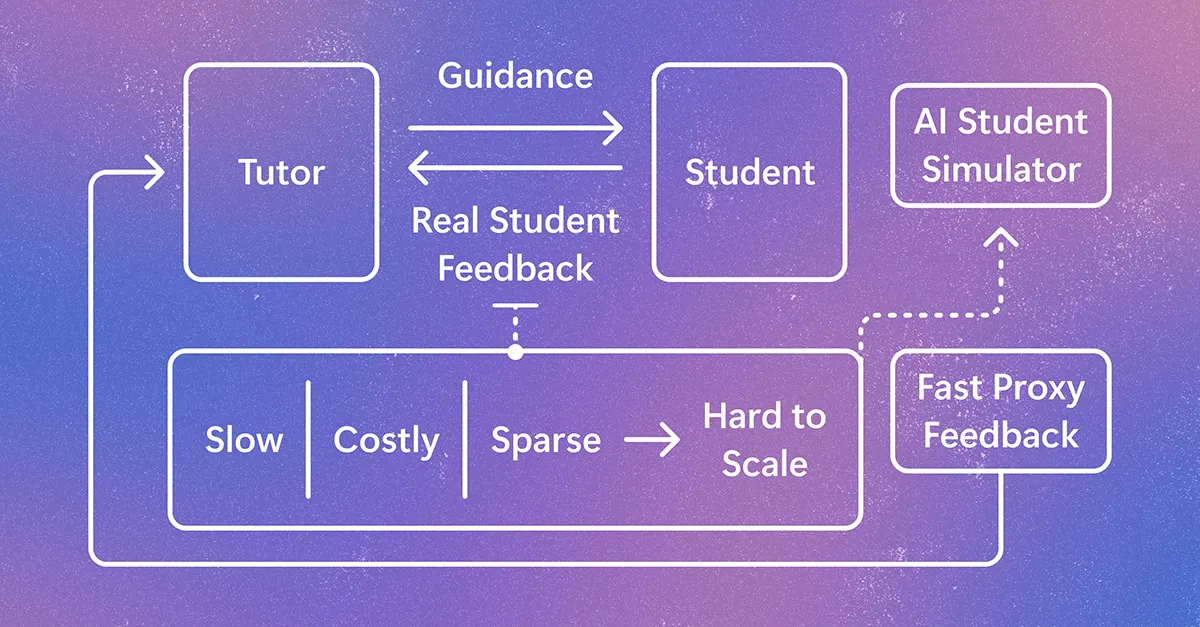
Microsoft Research zufolge benötigen KI-Tutoring-Tools Feedback von Lernenden, um besser zu werden. Es über Studien mit Menschen einzuholen, sei jedoch langsam, teuer und schwer zu skalieren. Die Qualität des Unterrichts lasse sich, so die Forschenden, nicht allein an der Antwort des Tutors beurteilen. Entscheidend sei, was geschieht, nachdem die Hilfestellung bei den Lernenden angekommen ist: ob sie den ursprünglichen Fehler korrigiert haben, ob ein Hinweis ihnen geholfen hat, selbst zur Antwort zu gelangen, oder ob er zu viel verraten hat, und ob andere Lernende andere Unterstützung benötigen würden.
StudentSim bildet ab, wie einzelne Lernende Fragen beantworten und wie sich ihre Antworten nach der Anleitung durch einen Tutor verändern. Das Ziel ist laut Microsoft, Feedback von Lernenden bereits während der schnellen Modelliteration verfügbar zu machen. Das Unternehmen betont, es gehe nicht darum, Lehrkräfte oder das Lernen im Klassenzimmer zu ersetzen.
Die Arbeit führt außerdem StudentSimEval ein, einen Benchmark samt Evaluationsprotokoll für Schach, Schreiben in Englisch als Zweitsprache und Mathematik. Microsoft gibt an, ausschließlich öffentlich verfügbare Lerndatensätze zu verwenden, die für Forschungszwecke freigegeben wurden, mit anonymisierten Datensätzen und ohne personenbezogene Angaben in irgendeiner Phase.
Zwei Maßstäbe: Verhalten und Reaktionsfähigkeit
Ein naheliegender Ansatz besteht darin, ein großes Sprachmodell per Prompt eine Lernendenrolle spielen zu lassen, etwa als Grundschüler mit Schwierigkeiten in Mathe. Das schwierigere Problem sei, so die Forschenden, die tatsächliche Leistungsgrenze der Lernenden einzuhalten. Ein Modell könne wie ein junger Schüler klingen und dabei auf Wissen weit jenseits dieses Niveaus zurückgreifen, wodurch ein Tutor wirksamer erscheine, als er ist. Klassische Modelle zur Wissensverfolgung (Knowledge Tracing) und Verhaltensvorhersage stützen sich zwar auf reale Datensätze, doch viele seien nicht dafür konzipiert, Anleitungen eines Tutors in natürlicher Sprache als Eingabe zu verarbeiten.
In Anlehnung an Wygotskis Zone der nächsten Entwicklung, also die Lücke zwischen selbstständiger Leistung und Leistung mit Unterstützung, definiert StudentSim zwei Ziele:
- Verhaltenstreue: ob ein Simulator bei zurückgehaltenen Aufgaben die aufgezeichneten Antworten eines bestimmten Lernenden trifft.
- Reaktionsfähigkeit auf Anleitung: ob der Simulator seine Antwort anpasst, nachdem er die Anleitung des Tutors gelesen hat.
Microsoft beschreibt beide als einander ergänzend. Ein Simulator, der nur vergangenes Verhalten nachbildet, könne zwar gut vorhersagen, zeige aber nicht, ob der Unterricht geholfen hat, während einer, der dem Tutor stets folgt, die wahrscheinlichen Fehler eines bestimmten Lernenden womöglich nicht abbildet.
Zweistufiges Training und Benchmark-Ergebnisse
Weil die Datensätze einzelner Lernender nur spärlich vorhanden sind, bestünde bei einem eigenen, von Grund auf trainierten Modell für jede Person die Gefahr der Überanpassung. StudentSim trainiert deshalb in zwei Stufen. In der ersten werden Daten vieler Lernender eines Fachgebiets zusammengeführt, um gängige Antwortformate, Fehler und Arten der Überarbeitung nach einer Anleitung zu lernen. In der zweiten wird das Modell auf die eigenen Daten einer einzelnen Person spezialisiert.
Im Schach sagt der Simulator den nächsten Zug eines Spielers voraus und wie er ihn nach einem Coaching womöglich überarbeitet. Beim Schreiben in Englisch als Zweitsprache erzeugt er Aufsätze mit den Fehlermustern einer Lernenden oder eines Lernenden und sagt Korrekturen nach dem Feedback einer Lehrkraft voraus. In Mathematik sagt er eine Multiple-Choice-Antwort voraus und ob die Person ihre Antwort nach einer Erklärung ändert. Alle Methoden werden anhand derselben Trainingsdaten pro Lernendem und derselben zurückgehaltenen Evaluationsdaten verglichen.
Microsoft berichtet, dass StudentSim in allen drei Bereichen führende Baselines übertrifft. Im Schach erreicht es eine Verhaltenstreue von 0,5150 und eine Reaktionsfähigkeit auf Anleitung von 0,9067. GPT-5.4 kommt auf 0,2316 und 0,7186, Maia2, ein schachspezifisches Modell zur Vorhersage menschlicher Züge, auf 0,4535 und 0,2721. Laut Microsoft kann GPT-5.4 auf Anleitung reagieren, trifft aber einen bestimmten Lernenden nicht zuverlässig, während Maia2 menschliche Züge genauer vorhersagt, aber keinen Weg für Anleitungen in natürlicher Sprache bietet.
Einen Schach-Tutor mit simuliertem Feedback trainieren
Die Forschenden testeten außerdem, ob ein Simulator ein Belohnungssignal für das Reinforcement Learning von Tutoren liefern kann. Der Tutor sieht eine Stellung und den früheren Fehlzug eines echten Lernenden und verfasst eine Anleitung. Der Simulator liest sie bei festen Parametern und erzeugt einen überarbeiteten Zug. Die Belohnung ist die Verbesserung der Zugqualität, gemessen mit der Schach-Engine Stockfish.
Verglichen wurden drei Bedingungen: ein per Supervised Fine-Tuning trainierter Tutor ohne Reinforcement Learning, ein Tutor, der mit GPT-5.4 als simuliertem Lernenden belohnt wurde, und ein Tutor, der mit StudentSim belohnt wurde. Alle nutzten dieselbe Tutor-Policy, denselben Ausgangspunkt und denselben Aufbau. Menschliche Schachexperten, die die Bedingung nicht kannten, bewerteten die Antworten. Laut Microsoft brachte die StudentSim-Belohnung den bestbewerteten Tutor in allen berichteten Dimensionen hervor, mit einer Genauigkeit von 90,5 Prozent gegenüber 75,7 Prozent bei der Baseline ohne RL und 71,6 Prozent bei der GPT-5.4-Bedingung. Auch bei der Qualität der Anleitung und der Personalisierung erzielte er höhere Werte.
Was das bedeutet
Microsoft bezeichnet das Ergebnis als Machbarkeitsnachweis dafür, dass Schülersimulatoren, die mit realen Lerndaten trainiert wurden, ein nützliches Feedbacksignal liefern können. Das Unternehmen versteht es als frühes Forschungssignal und nicht als Ersatz für Tests mit echten Lernenden. Für Entwickler von Tutoren deutet der Ansatz auf einen Weg hin, schneller zu iterieren, bevor aufwendige Studien mit Menschen durchgeführt werden.
Microsoft Research: Simulating student learning for better AI tutoring