Forscher der University of Washington stellen Mikro-Sprachmodelle vor, die klein genug für Smartwatches sind
Forscher der University of Washington haben "Mikro-Sprachmodelle" mit 8 bis 30 Millionen Parametern vorgestellt. Sie sind klein genug, um auf Geräten wie Smartwatches zu laufen und sofort zu antworten, während ein cloudbasiertes großes Sprachmodell nachzieht. Die Arbeit wurde am 27. Oktober auf der EMNLP 2026 präsentiert.
- UW-Forscher stellten Mikro-Sprachmodelle mit 8 bis 30 Millionen Parametern vor, präsentiert am 27. Oktober auf der EMNLP 2026.
- Das kleine Modell beginnt auf dem Gerät sofort mit der Antwort, ein Cloud-LLM vervollständigt sie nach 4 bis 8 Wörtern.
- Das Mikromodell machte in 4 bis 8 Prozent der Antworten Fehler, die das andere Modell nahtlos korrigierte.
- In einer Nutzerstudie bevorzugten 9 von 10 Teilnehmenden das gekoppelte System gegenüber einem reinen Cloud-Modell.
Warum kleine Geräte kleine Modelle brauchen
Der aktuelle KI-Boom wird von großen Sprachmodellen, sogenannten LLMs, getragen. Sie treiben Chatbots und KI-Agenten an und berechnen ihre Vorhersagen anhand riesiger Mengen von Variablen, den Parametern. Nach Angaben der UW haben aktuelle Spitzenmodelle schätzungsweise mehrere Billionen Parameter. Damit sind sie viel zu groß, um auf langsameren Smartphones oder kleinen Geräten wie Smartwatches zu laufen.
Solche Geräte sind in der Regel auf die Cloud angewiesen, was zu einer Verzögerung führt, bevor die Nutzerin oder der Nutzer eine Antwort erhält. Die Mikro-Sprachmodelle des UW-Teams sollen diese Lücke schließen.
So funktioniert das gekoppelte System
Die Mikro-Sprachmodelle arbeiten mit 8 bis 30 Millionen Parametern, was laut den Forschern klein genug für Geräte mit begrenzter Rechenleistung ist. Im Beispiel der UW stellt ein Nutzer seiner Smartwatch eine Frage, und das Mikro-Sprachmodell beginnt sofort zu antworten. Nach 4 bis 8 Wörtern vervollständigt das LLM die Antwort.
Das kleine Modell liegt nicht immer richtig. Laut den Forschern machte es in 4 bis 8 Prozent der Antworten Fehler, doch das andere Modell korrigierte diese nahtlos, bevor es weiterschrieb.
Nutzerstudie und Forschungsteam
In einer Nutzerstudie bevorzugten 9 von 10 Teilnehmenden das gekoppelte System gegenüber den verzögerten Antworten eines reinen Cloud-Modells. Zu den Koautoren der UW zählen Wen Cheng, Tuochao Chen, Luke Zettlemoyer und Shyam Gollakota. Eine vollständige Liste der Koautoren und der Förderung findet sich in der Veröffentlichung. Das Team ist unter [email protected] erreichbar und betreibt außerdem eine Website.
Weitere UW-Forschung aus der Oktober-Übersicht
Die Arbeit war Teil der Forschungshighlights der Universität im Oktober, die auch mehrere andere Studien umfassten:
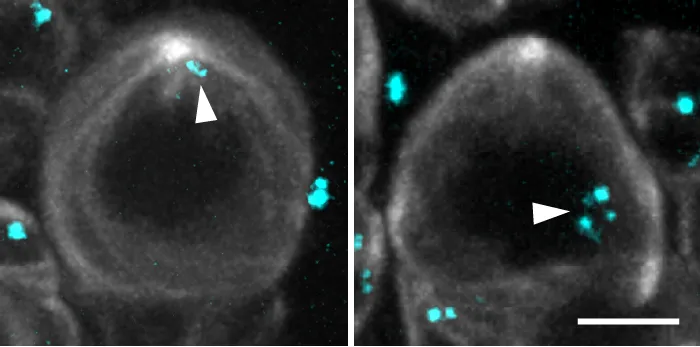
- DNA-Organisation in Stammzellen: In einer am 14. Oktober im Journal of Cell Biology veröffentlichten Arbeit beschrieben UW-Forscher, wie Proteine außerhalb des Zellkerns mit Proteinen im Inneren zusammenwirken, um Zentromere in Stammzellen im Gehirn von Fruchtfliegen zu positionieren.
- Migrantische Fischer: Ein Bericht des UW Harry Bridges Center for Labor Studies ergab, dass Ausnahmeregelungen im US-Recht es migrantischen Fischern erlauben, ohne Genehmigung oder Visum zu arbeiten, wodurch sie anfällig für Zwangsarbeit und Ausbeutung sind.
- Grabende Garnelen: Eine Studie in Estuarine, Coastal and Shelf Science stellte fest, dass sich Garnelenbetten in der Willapa Bay jedes Jahr um bis zu 100 Fuß verschieben.
Was das bedeutet
Die Quelle stellt Mikro-Sprachmodelle als Möglichkeit dar, die Wartezeit zu beseitigen, die Nutzer erleben, wenn ein kleines Gerät ein LLM über die Cloud erreichen muss. Die Ergebnisse der Nutzerstudie legen nahe, dass Menschen einen sofortigen Start einer verzögerten, aber vollständigen Antwort eines reinen Cloud-Modells vorziehen. Zur kommerziellen Verfügbarkeit oder dazu, welche Geräte den Ansatz übernehmen könnten, macht die Quelle keine Angaben.