MITs CheMeleon sagt Moleküleigenschaften mit wenigen Daten voraus
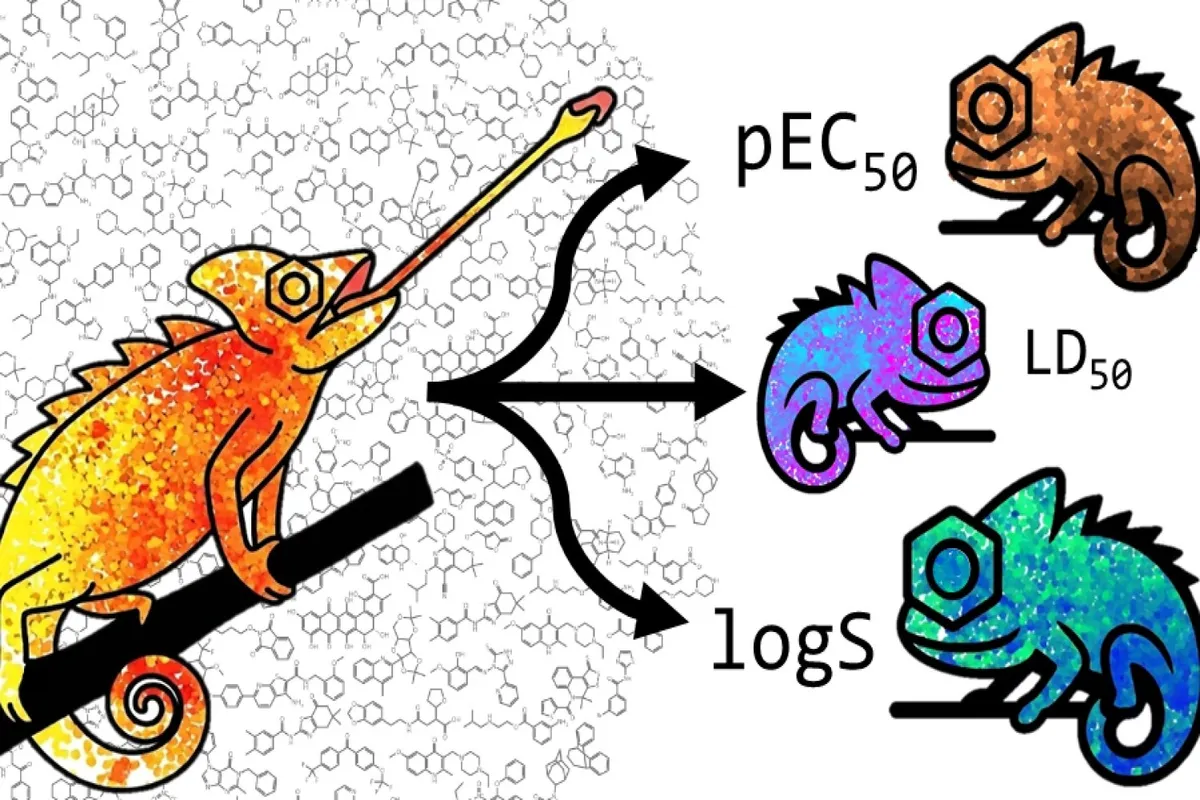
Forschende am MIT haben CheMeleon entwickelt, ein Machine-Learning-Modell, das Moleküleigenschaften vorhersagen soll, wenn nur wenige Daten verfügbar sind. Das Open-Source-System könnte Forschenden helfen, bei der Entwicklung von Medikamenten und anderen Materialien weniger Moleküle synthetisieren und testen zu müssen.
- CheMeleon lernt anhand von etwa einer Million Molekülen aus PubChem.
- Für das Vortraining nutzt es etwa 1.600 Moleküldeskriptoren.
- Das Modell kann für Eigenschaften wie Wirksamkeit, Toxizität und Löslichkeit feinjustiert werden.
- Nach Angaben des MIT-Teams lag es in 58 Testfällen vor anderen Methoden.
- CheMeleon ist über das Open-Source-Paket ChemProp verfügbar.
Ein Basismodell für die Chemie
CheMeleon lernt zunächst allgemeine Muster in der Chemie anhand von etwa einer Million Molekülen aus PubChem, einer frei verfügbaren Datenbank für chemische Informationen, die von den U.S. National Institutes of Health betrieben wird. Statt eine einzelne spezifische Eigenschaft zu erlernen, wird das Modell darauf trainiert, einen Katalog mit etwa 1.600 Moleküldeskriptoren vorherzusagen. Dazu gehören Merkmale wie das Molekulargewicht und die Anzahl der Sauerstoffatome in einem Molekül.
Das MIT-Team erklärt, dass CheMeleon durch dieses Vortraining Beziehungen zwischen Molekülstruktur und Verhalten erlernen kann, bevor es an eine bestimmte Aufgabe angepasst wird. Forschende können das Modell anschließend feinjustieren, um Eigenschaften wie Wirksamkeit, Toxizität, Löslichkeit, Viskosität, Bioaktivität oder die Reaktivität mit einem Protein oder Enzym vorherzusagen.
Für Forschung mit wenigen Daten entwickelt
In vielen Projekten zur Entdeckung chemischer Wirkstoffe fehlen umfangreiche Daten. Das gilt insbesondere, wenn Forschende ein neu entdecktes zelluläres Ziel oder eine andere Eigenschaft untersuchen, die bislang kaum erforscht wurde. CheMeleon soll dieses Problem lösen, indem es mit dem Wissen aus dem Datensatz mit einer Million Molekülen startet, statt jede neue Aufgabe von Grund auf zu erlernen.
„Wir betrachten die Fachliteratur überhaupt nicht. Wir berechnen einfach eine Reihe von Moleküldeskriptoren wie das Molekulargewicht oder die Anzahl der Sauerstoffatome und andere“, sagte Akshat Shirish Zalte, ein MIT-Doktorand und Autor der Studie, gegenüber MIT News. Die Forschenden verglichen CheMeleon in 58 Testfällen mit anderen Basismodellen und klassischen Modellen, die auf von Experten entwickelten Prinzipien beruhen. „Wir sehen, dass unser Modell an der Spitze liegt“, sagte Zalte.
Nach Angaben von William Green „reduziert das Modell die Zahl der Moleküle, die experimentell getestet werden müssen, um die Eigenschaften neuer Moleküle präzise vorherzusagen, drastisch“. Die Synthese und Prüfung vieler Moleküle sei langsam und teuer, sagte er.
Open-Source-Modell wird bereits von Unternehmen eingesetzt
CheMeleon wurde mit ChemProp entwickelt, einem Open-Source-Paket für maschinelles Lernen, das von Greens Gruppe am MIT entwickelt und gepflegt wird. Jede und jeder kann CheMeleon über ChemProp herunterladen und für eigene Zwecke feinjustieren.
Wie MIT News berichtet, setzen bereits mehrere Pharmaunternehmen das Modell ein. Bei einem OpenADMET-Wettbewerb zur Vorhersage der Eigenschaften bislang nicht synthetisierter Moleküle nutzten laut Green neun der 20 besten Beiträge CheMeleon. Die Forschungsergebnisse zum Modell wurden in der Ausgabe vom 14. September des Journal of Chemical Information and Modeling veröffentlicht. Die Studie stammt von Forschenden des MIT und der BASF SE in Deutschland.
Für die Wirkstoffsuche und die Materialforschung bietet der Ansatz eine Möglichkeit, die Zahl der Kandidatenmoleküle zu verringern, bevor kostspielige Laborarbeiten beginnen. Die Quelle behauptet nicht, dass CheMeleon chemisches Verhalten perfekt vorhersagen kann, sondern stellt das Modell als Werkzeug für frühe Entscheidungen bei knappen experimentellen Daten vor.
MIT News: How to predict the behavior of molecules from scant data