MIT-Historiker: KI-Halluzinationen gehen auf gezielt eingebauten Zufall zurück
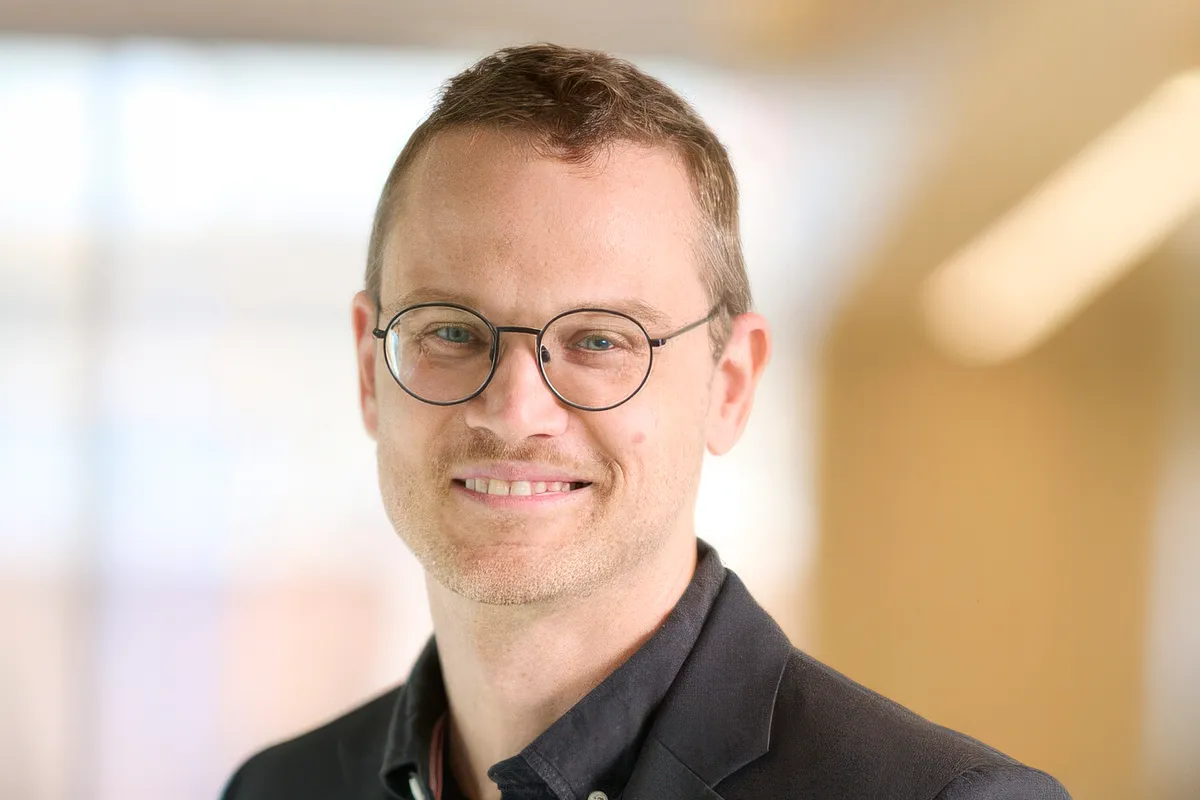
Generative KI-Modelle gehen auf Ideen aus der Mitte des 20. Jahrhunderts zurück, wonach eine denkende Maschine ein gewisses Maß an Irrationalität braucht. Das argumentiert der MIT-Historiker Benjamin Lindquist. In einem neuen Aufsatz in der Fachzeitschrift Past and Present führt er KI-Halluzinationen auf frühe Ingenieure zurück, die gezielt Zufall in ansonsten deterministische Algorithmen einbauten.
- Benjamin Lindquist vom MIT argumentiert in Past and Present, dass frühe KI-Ingenieure gezielt Zufall einbauten, um menschliche Kreativität nachzuahmen.
- Er führt die Ursprünge von KI-Halluzinationen auf diese frühe Forschung zurück.
- Frühe Befürworter neuronaler Netze schätzten unerwartete Antworten, das Gegenteil dessen, was Nutzer heute von ChatGPT oder Claude erwarten.
- Lindquist zufolge hat die Unterdrückung von Halluzinationen ihren Preis, da überraschende Schlussfolgerungen und Fehler zusammenhängen.
Zufall als Weg zur Kreativität
Benjamin Lindquist ist Assistant Professor in der History Section des MIT. Er hat eine gemeinsame Professur mit dem MIT Schwarzman College of Computing und dem Department of Electrical Engineering and Computer Science (EECS) inne und ist Principal Investigator im Laboratory for Information and Decision Systems. Sein Aufsatz trägt den Titel "The Irrational Computer: Randomness and Unreason in the History of Artificial Intelligence".
Laut Lindquist haben viele Persönlichkeiten aus Wissenschaft und Kunst seit Langem die Theorie vertreten, dass der Zufall bei Entdeckungen und Kreativität eine wichtige Rolle spielt. Frühe Computeringenieure setzten Kreativität mit unerwarteten logischen Sprüngen gleich, ja sogar mit einem traumähnlichen Zustand, der es einem Menschen erlaubt, Dinge aus einer neuen Perspektive zu betrachten. Um ein solches Denken nachzuahmen, bauten KI-Pioniere gezielt Zufall in Algorithmen ein, die eigentlich dafür gedacht waren, Probleme deterministisch zu lösen.
Er verweist auf John Pierce, einen bekannten Elektroingenieur der Bell Labs, der in den frühen 1950er-Jahren argumentierte, Mathematik sei für die Kunst wertvoll, weil sie Ordnung aufheben könne. Auf berechnete Weise könne Mathematik einen Schuss Unerwartetes hinzufügen, Klischees vermeiden helfen und Unregelmäßigkeit einführen, die zu neuen Einsichten führen könnte.
Neuronale Netze und zwei Lager
Ein beliebter Weg, Unregelmäßigkeit in berechenbare Computer zu bringen, waren künstliche neuronale Netze. Lindquist zufolge wurden viele frühe Netze von Psychologen gebaut, die hofften, ein Modell des Gehirns würde es Forschenden erlauben zu beobachten, was im Inneren geschieht, auch wie Gehirne produktive Fehler machen. Die Forschenden glaubten, diese Systeme könnten die Blackbox des Geistes öffnen und "all das chaotische Zeug zeigen, das wirklich vor sich ging".
Ein anderes Lager vertrat die Auffassung, kreatives Denken sei einfach normales Denken, nur besser ausgeführt. Bei der Debatte ging es laut Lindquist darum, worauf menschlicher Erfindungsgeist im Kern hinausläuft und wie er sich in Maschinenform nachbauen lässt.
Er weist auf einen scharfen Kontrast zu heute hin. Systeme wie ChatGPT oder Claude schätzt man heute, weil ihre Antworten größtenteils korrekt sind. Frühe Befürworter schätzten neuronale Netze aus dem entgegengesetzten Grund: Sie wollten ein System, das gelegentlich Antworten gibt, die von den Erwartungen abweichen, sogar seltsame oder bizarre. Da die frühen Systeme auf Labore beschränkt waren, hatten falsche Ausgaben keine Folgen in der realen Welt. Heute, so Lindquist, gebe es rechtliche und finanzielle Gründe, aus denen OpenAI oder Anthropic keinen Chatbot wollen, der unerwartete oder kreative Antworten liefert, und die Fremdartigkeit werde "abgeschliffen". Diese Eigenschaft könnte im Kern der Systeme noch immer stecken, werde aber weitgehend unterdrückt.
Wie neuronale Netze dominant wurden
Lange Zeit, erklärt Lindquist, war die "symbolische KI" der vorherrschende Ansatz. Sie geht davon aus, dass die Welt auf Regeln beruht und dass Forschende Wissen als Fakten und Aussagen rekonstruieren und in einen Computer einspeisen sollten. Neuronale Netze gewannen in den 1950er-Jahren an Zugkraft, gerieten aber früh in Ungnade. Frank Rosenblatt, ein Psychologe und wichtige frühe Figur, machte große Versprechungen darüber, was solche Systeme leisten könnten. Er starb 1971 durch einen Unfall an seinem 43. Geburtstag, und da war der Wechsel hin zur symbolischen KI bereits im Gange.
Neuronale Netze verschwanden nie ganz. In den 1980er-Jahren hatten sie sich stärker in die Kognitionswissenschaft verlagert. Um leistungsfähiger zu werden, brauchten sie viele Daten und enorme Rechenleistung, die erst mit dem Internetzeitalter verfügbar wurden. Um 2012 begannen neuronale Netze laut Lindquist, eine statistische Form des maschinellen Lernens zu übertreffen, und sie wuchsen von da an weiter.
Eine mahnende Lehre über Zielkonflikte
Aus dieser Geschichte zieht Lindquist eine mahnende Lehre. Entwickler könnten darauf hinarbeiten, Halluzinationen zu unterdrücken und die KI auf ein bestimmtes Verhalten zu trimmen, doch das habe andere Folgen. Seiner Ansicht nach besteht ein Zusammenhang zwischen den überraschenden, kreativen Schlussfolgerungen, die eine KI liefern kann, und Fehlern oder Halluzinationen.
Er geht davon aus, dass beim Bau von Maschinen, die menschliches Verhalten nachahmen, unvermeidliche Zielkonflikte zwischen Kreativität und Vorhersagbarkeit bestehen. Vielleicht sei es unmöglich, sich vollständig an einem der beiden Enden des Spektrums zu bewegen, sagt er. Wenn Ingenieure aber konsequent auf ein Ziel hinarbeiten, opferten sie oft unbeabsichtigt etwas anderes.
MIT News: Q&A: How AI came to model the “messy” human mind