NVIDIA zeigt, wie sich Nemotron 3.5 ASR für saudi-arabische Dialekte feinabstimmen lässt
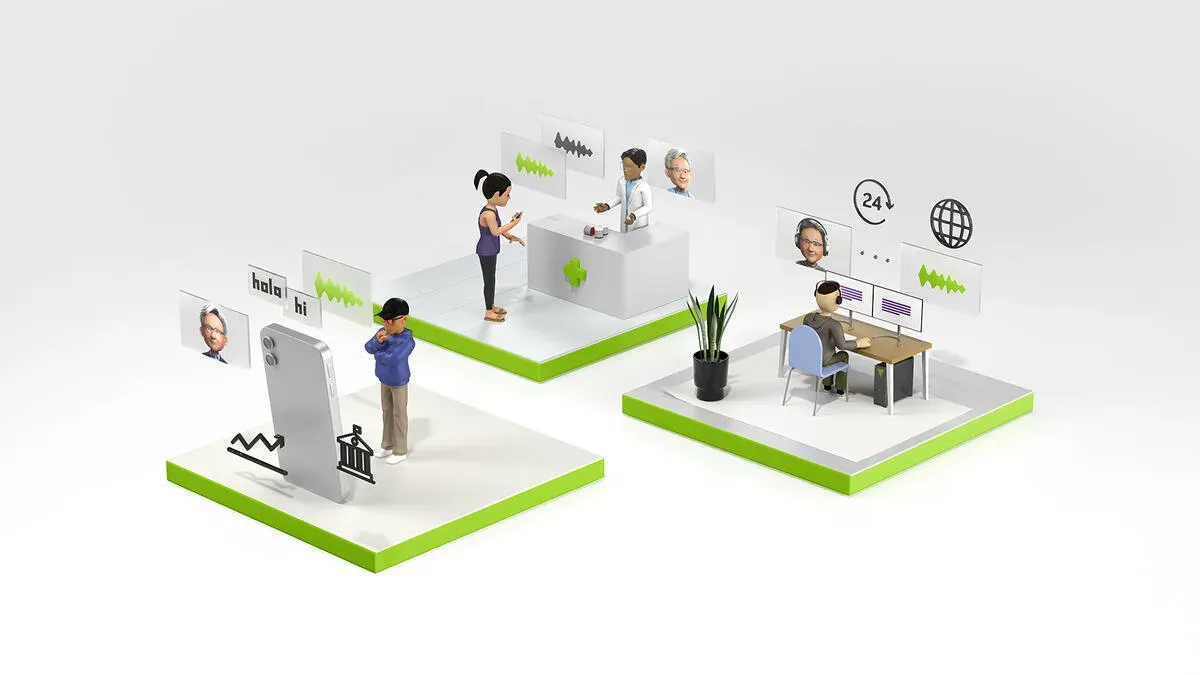
NVIDIA hat ein Rezept zur Feinabstimmung veröffentlicht, mit dem sich das Modell Nemotron 3.5 ASR an die saudi-arabischen Dialekte Najdi und Hijazi anpassen lässt. Laut NVIDIA sank die Wortfehlerrate auf dem Ziel-Testsplit von 55,05 auf 29,96 Prozent, ohne andere Sprachen zu beeinträchtigen.
- Das Fine-Tuning von Nemotron 3.5 ASR auf 133,7 Stunden Najdi- und Hijazi-Sprache senkte die WER laut NVIDIA von 55,05 auf 29,96 Prozent.
- Die englische WER verbesserte sich dank Replay-Mixing mit FLEURS-Daten von 11,04 auf 10,42 Prozent, andere arabische Dialekte verschlechterten sich nicht.
- Das Aktualisieren aller 24 Encoder-Schichten lieferte die beste Genauigkeit, erfordert aber 230,4 Millionen trainierbare Parameter.
- Ein größerer Attention-Kontext und Beam-8-MALSD-Decoding senkten die WER um 2,71 Prozentpunkte, kosten aber etwa 800 ms Latenz.
- NVIDIA Nemotron 3 Diarization ergänzt eine sprecherbezogene Transkription für bis zu acht Sprecher.
Warum Dialekte mehrsprachige Spracherkennung ins Straucheln bringen
NVIDIA Nemotron 3.5 ASR unterstützt mehrsprachige Streaming-Transkription in 40 Sprach-Locales, darunter Arabisch. Dennoch sind regionale Dialekte und lokale Aufnahmebedingungen laut NVIDIA in den Daten des Vortrainings oft unterrepräsentiert. Ein Modell, das bei breiten Benchmarks gut abschneidet, kann im Praxiseinsatz deshalb trotzdem schwächeln.
Als Beispiel dient in dem Beitrag das Saudi-Arabische. Ein Modell kommt womöglich mit Modernem Hocharabisch oder Englisch zurecht, hat aber Probleme mit Najdi- und Hijazi-Sprache. Wird ausschließlich auf den Zieldialekt feinabgestimmt, kann sich das Modell dort verbessern, bei anderen Sprachen aber schlechter werden. Dieses Problem heißt Catastrophic Forgetting, also katastrophales Vergessen.
Der Workflow: Datenaufbereitung, Replay und teilweises Entsperren
Das Rezept nutzt das NVIDIA-NeMo-Framework und stützt sich auf mehrere Techniken:
- Minimale Datenaufbereitung: Sie entfernt unbrauchbare Labels und offensichtliche Alignment-Fehler, ohne knappe, schwierige Sprachdaten auszusortieren.
- Replay-Mixing: Eine kleine Menge bereits gelernter Daten (der Beitrag verwendet FLEURS) wird eingestreut, um das Vergessen zu verringern.
- Teilweises Entsperren des Encoders: Es begrenzt, wie viele Parameter sich ändern. Das ist günstiger und schneller als ein vollständiges Fine-Tuning, kostet aber etwas Genauigkeit.
- Length Bucketing: Es verringert das Padding und macht das Training für Streaming-Encoder praktikabel.
Die Zieldaten stammen aus dem Datensatz SADA 2022, gefiltert auf Najdi und Hijazi. Prüfungen von Clip-Dauer, Zeichenrate und Markierungen für unverständliche Sprache ließen 103.559 von 125.490 Äußerungen übrig, das entspricht 133,7 Stunden (82,5 Prozent des Ausgangsbestands). NVIDIA betont, es gehe darum, strukturell fehlerhafte Beispiele zu entfernen, nicht schwierige Akzente oder verrauschte Sprache. Zudem weist das Unternehmen darauf hin, dass ein UTMOS-Standardschwellenwert von 3,0 fast alles aussortiert hätte. Das Team habe daher die Verteilungen der Scores geprüft und in NeMo Curator korpusspezifische Grenzwerte gesetzt.
Ergebnisse und Zielkonflikte
Laut NVIDIA senkte das Fine-Tuning auf den 133,7 Stunden die Wortfehlerrate (WER) auf dem Ziel-Testsplit von 55,05 auf 29,96 Prozent. Die englische WER verbesserte sich von 11,04 auf 10,42 Prozent, andere arabische Dialekte verschlechterten sich nicht.
Wurden alle 24 Encoder-Schichten aktualisiert, ergaben sich die niedrigsten Fehlerraten, allerdings mit 230,4 Millionen trainierbaren Parametern. Das Einfrieren von Schichten senkt den Rechenbedarf, wenn Daten oder Speicher knapp sind.
Zwei Änderungen auf der Inferenzseite brachten ohne erneutes Training weitere Verbesserungen. Ein größerer Attention-Kontext mit 13 Lookahead-Frames sowie Beam-8-MALSD-Decoding senkten die WER um 2,71 Prozentpunkte. Laut NVIDIA kommen dadurch rund 800 ms Latenz hinzu, was eher für Batch-Transkription als für Live-Einsatz taugt.
Der Beitrag beschreibt außerdem NVIDIA Nemotron 3 Diarization. Das Modell erweitert die Pipeline um eine sprecherbezogene Transkription für bis zu acht Sprecher, indem es Sprechergrenzen mit den ASR-Zeitstempeln abgleicht.
Was das für Entwickler bedeutet
NVIDIA richtet den Workflow an Teams, die genug annotierte Sprachdaten haben, um ein Modell zu spezialisieren, aber nicht genug, um eines von Grund auf zu trainieren. Beispiele sind die Anpassung an Dialekte, domänenspezifische Transkription oder Einsätze, bei denen bestehende Sprachen erhalten bleiben müssen. Für das Basisexperiment kamen zwei NVIDIA RTX PRO 6000 Blackwell Workstation Edition GPUs über 12.000 Schritte zum Einsatz.
Das Unternehmen benennt die Grenzen klar. Die Techniken seien keine universellen Standardeinstellungen, Replay schütze nur, was seine Daten abbilden, und beim teilweisen Entsperren sei bei geänderter Datenmischung eine neue Abstimmung nötig. Der Workflow sei zudem kein Beleg für jeden arabischen Dialekt oder jede Einsatzumgebung. NVIDIA verweist auf ein ASR-Fine-Tuning-Notebook, einen Nemotron-ASR-Fine-Tuning-Skill und einen Hugging-Face-Blog zum Hinzufügen von Diarization.
NVIDIA Developer: Fine-Tuning NVIDIA Nemotron for Saudi Arabic Dialects, with a Path to Other Languages