Neo4j Document Intelligence in AuraDB steht vor der allgemeinen Verfügbarkeit
Neo4j hat die bevorstehende allgemeine Verfügbarkeit von Document Intelligence in AuraDB angekündigt. Die Funktion erstellt ohne Code einen Wissensgraphen aus vorhandenen Dokumenten und wird in den Tarifen Free, Professional und Business Critical angeboten.
- Neo4j bringt Document Intelligence in AuraDB in den Tarifen Free, Professional und Business Critical zur allgemeinen Verfügbarkeit.
- Die Funktion erstellt ohne Code einen Wissensgraphen aus Text-, PDF- und Word-Dateien.
- Mit GA kommen Jobs mit Hunderten Dokumenten, die Interpretation von Bildern und Tabellen sowie die Entitätsauflösung gegen bestehende AuraDB-Daten hinzu.
- Ein interaktiver Assistent hilft beim Verfeinern des Graphmodells, das sich auch auf einer Arbeitsfläche bearbeiten lässt.
- Als Nächstes sind API-, Kommandozeilen- und Model-Context-Protocol-Zugriff geplant.
Von Dokumenten zum vernetzten Graphen
Laut Neo4j arbeitet Document Intelligence mit reinen Textdateien, PDFs und Microsoft-Word-Dateien. Nutzer beschreiben, was extrahiert werden soll, und verfeinern das vorgeschlagene Graphmodell anschließend auf einer Arbeitsfläche oder mit einem integrierten Assistenten. Ziel sei es, Dokumente, die bisher ungenutzt und nicht abfragbar herumlagen, durchsuchbar und praktisch nutzbar zu machen.
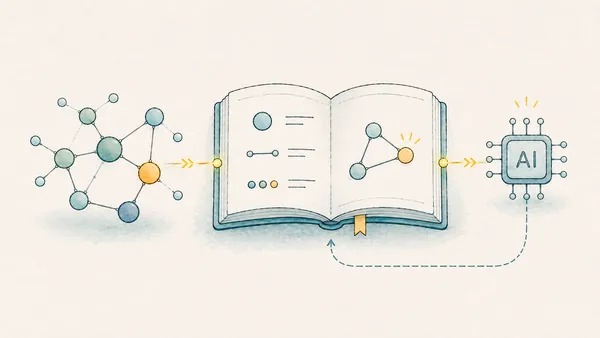
Das Unternehmen argumentiert, dass Dokumente den Kontext vieler geschäftlicher Entscheidungen enthalten: Verträge beschreiben Pflichten, Berichte halten Risiken fest, Richtliniendokumente erklären, wie ein Unternehmen arbeitet. Eine Frage zu einem Lieferanten kann etwa von einem Vertrag, einer anderswo vermerkten Ausnahme und den Produkten abhängen, die der Lieferant bereitstellt. Ein Wissensgraph macht diese Beziehungen explizit, sodass eine Anwendung ihnen über Dokumente hinweg und bis in bestehende Geschäftsdaten folgen kann. Neo4j zufolge liefert der entstehende Graph Anwendungen und KI-Agenten zudem ein klareres Signal als Rohtext und hilft ihnen, verwandten Kontext mit weniger Tokens abzurufen.
Was sich mit der GA-Version ändert
Document Intelligence wurde zunächst als Vorschau eingeführt und brachte Dokumentverarbeitung, Graphmodellierung und Extraktion in die Aura-Konsole. Die GA-Version ergänzt laut Neo4j mehrere Fähigkeiten:
- Größere Sammlungen: Hunderte Dokumente pro Job, ausgeführt als verwaltete Hintergrundjobs, deren Status in der Aura-Konsole angezeigt wird. Wiederholungsversuche machen längere Jobs robuster.
- Reichhaltigere Inhalte: Das Tool kann neben Text auch Bilder und Tabellen interpretieren, sodass deren Inhalt in die Graphextraktion einfließen kann.
- Bestehende Graphen: Es kann ein vorhandenes Graphmodell erweitern, extrahierte Entitäten mit bereits in AuraDB vorhandenen Datensätzen abgleichen und diesen neue Fakten und Beziehungen hinzufügen.
Als Beispiel nennt Neo4j Verträge, die einem Lieferantengraphen, der Unternehmen bereits mit den von ihnen gelieferten Produkten verknüpft, Pflichten hinzufügen können.
Die Entitätsauflösung entscheidet, wann verschiedene Erwähnungen dieselbe reale Entität meinen. Innerhalb jedes Jobs normalisiert das System Entitäten, grenzt die vergleichenswerten Paare ein, bewertet die verbleibenden Kandidaten und führt jene zusammen, die über einem Ähnlichkeitsschwellenwert liegen. Anschließend vergleicht es die Ergebnisse mit den Knoten, die bereits in AuraDB vorhanden sind.
Der Assistent und das zweistufige Verfahren
Der interaktive Assistent kann aus einer Stichprobe der Dokumente ein Graphmodell erzeugen und schrittweise verfeinern, Importe starten und den Jobstatus melden. Während der laufenden Sitzung behält er den Kontext des Gesprächs. Die Stichprobe über die gesamte Sammlung soll dafür sorgen, dass das Modell wiederkehrende Entitäten und Beziehungen abbildet und nicht nur den Inhalt eines einzelnen Dokuments. Nutzer können ihn bitten, eine Beziehung zu ändern, in den Stichproben gefundene Informationen zu ergänzen oder zu prüfen, ob das Modell ihre geschäftlichen Fragen beantworten kann. Gespräch und direkte Bearbeitung wirken auf dasselbe Graphmodell.
Der Prozess verläuft in zwei Stufen. Zunächst zieht das System eine Stichprobe aus der Sammlung und schlägt ein Graphmodell zur Prüfung vor. Sobald das Modell steht, verarbeitet es die gesamte Sammlung, extrahiert Entitäten und Beziehungen, löst wiederholte Erwähnungen auf und schreibt das Ergebnis nach AuraDB.
Das Ergebnis ist ein einziger Graph mit verbundenen Entitäts- und lexikalischen Ebenen. Die lexikalische Ebene enthält Dokument- und Chunk-Knoten, wobei die Embeddings für die Ähnlichkeitssuche an den Chunks gespeichert sind. Extrahierte Entitäten verweisen auf die Chunks, in denen sie gefunden wurden, sodass Anwendungen Beziehungen durchlaufen und die Quellpassagen hinter einem Ergebnis abrufen können.
Wie es weitergeht
Neo4j erklärt, Document Intelligence über die Aura-Konsole hinaus zu erweitern, und zwar um API-, Kommandozeilen- und Model-Context-Protocol-Zugriff für Pipelines und Agenten. Außerdem prüft das Unternehmen Graphmodelle, die von einer Geschäftsbeschreibung ausgehen, klareres Feedback zu Jobs samt Abbruchmöglichkeit, mehr Kontrolle über die Entitätsauflösung, erneute Importe aus aktualisierten Quellen und visuelle Testwerkzeuge. Breitere Einsatzoptionen für Unternehmen, darunter Kunden-Cloud-Umgebungen und selbst verwaltetes Neo4j, stehen auf der Roadmap.
Für Teams, die AuraDB bereits nutzen, ist die Funktion in der Aura-Konsole über alle drei Tarife verfügbar. Für unterstützte Quellen und Details zum Workflow verweist Neo4j auf seine Dokumentation. Feedback lässt sich über die Feedback-Schaltfläche in der Konsole senden.