Neo4j bringt Graph-Embeddings per Einzeiler in Aura Graph Analytics
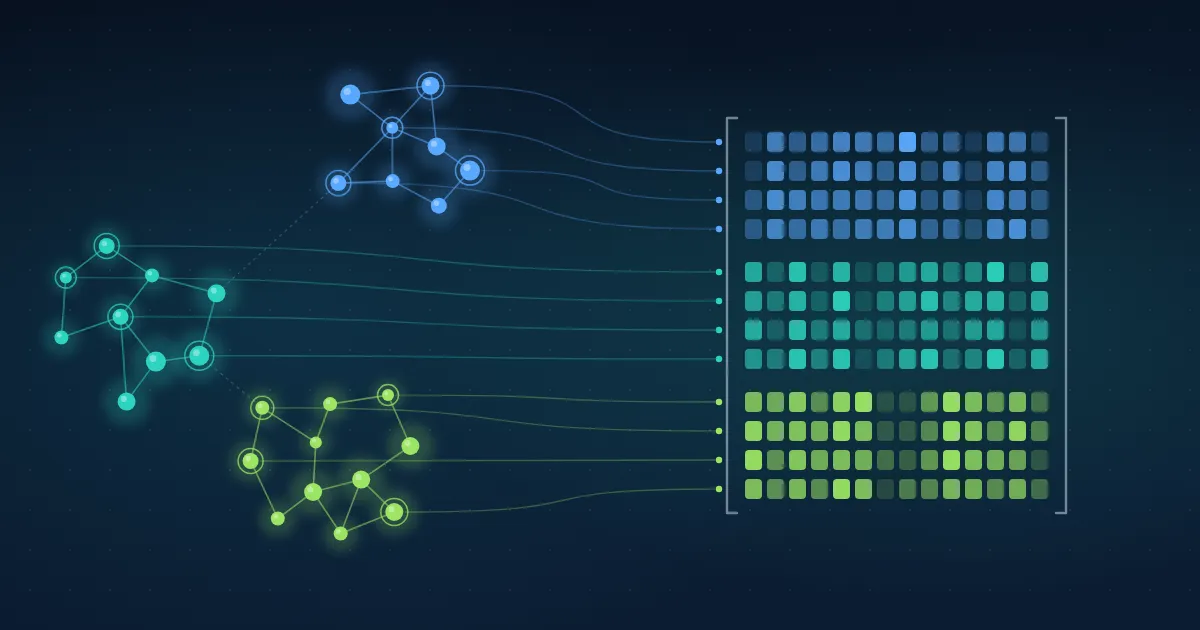
Neo4j hat im GDS Python Client eine Embeddings-API als Preview veröffentlicht, die mit einem einzigen Aufruf Graph-Embeddings für jeden Knoten erzeugt: gds.embedding.create(G). Laut Unternehmen ist sie für Aura Graph Analytics gedacht und macht es überflüssig, vor dem ersten Ergebnis Modelle auszuwählen oder Konfigurationen abzustimmen.
- Neo4j hat eine Embeddings-API als Preview im GDS Python Client ab Version 2.2 veröffentlicht, ausgelegt auf Aura Graph Analytics.
- gds.embedding.create(G) erzeugt für jeden Knoten ein Embedding mit FastRP und von Neo4j gewählten Standardwerten.
- gds.embedding.train baut aus Knoteneigenschaften und bekannten Klassen einen GraphSAGE-Encoder für maßgeschneiderte Embeddings.
- Aura Graph Analytics ist in der Stufe AuraDB Free verfügbar; beide Endpunkte sind in der Preview und können sich ändern.
- Neo4j plant weitere Funktionen und eine Version für die Cypher-API.
Ein Aufruf statt Konfigurationsberg
Graph-Embeddings verdichten einen Knoten und die Struktur um ihn herum zu einem Vektor, sodass Knoten mit ähnlichem Umfeld ähnliche Vektoren erhalten. Neo4j zufolge waren Embeddings in den vergangenen Jahren der am schnellsten wachsende Anwendungsfall von Neo4j Graph Data Science (GDS), der Bibliothek des Unternehmens für Graphanalysen und maschinelles Lernen.
Das Unternehmen argumentiert, die Erstellung sei bisher Aufgabe von Data Scientists gewesen, die entscheiden mussten, welches Modell zu einem Graphen passt, welche Konfiguration zu einem Anwendungsfall und was jeder Parameter bewirkt. Neo4j stellt dem Text-Embeddings gegenüber, bei denen ein Aufruf mit wenigen Codezeilen Vektoren liefert, und meint, Graphen verdienten dieselbe Behandlung.
Die neue API ist als Preview im GDS Python Client ab Version 2.2 verfügbar. Der Aufruf versieht jeden Knoten eines Graphen, der in eine Aura-Graph-Analytics-Session geladen wurde, mit einem Embedding. Im Hintergrund läuft FastRP, das Neo4j als schnellen und hochgradig skalierbaren Algorithmus beschreibt, mit vom Unternehmen gewählten Standardwerten, die nach eigener Aussage in den meisten Fällen gut funktionieren.
Standardwerte, Stellschrauben und der Umgang mit den Daten
Wer mehr Kontrolle will, kann die Größe des Embeddings und weitere FastRP-Einstellungen festlegen, die Eigenschaft benennen, in der die Embeddings gespeichert werden, nur bestimmte Knotenlabels oder Beziehungstypen einbetten und einen random_seed für reproduzierbare Ergebnisse setzen.
Die Embeddings werden dem In-Memory-Graphen als neue Knoteneigenschaft hinzugefügt, standardmäßig mit dem Namen embedding, sofern kein anderer gewählt wird. In die Datenbank wird nichts geschrieben. Von dort aus lassen sich die Vektoren in pandas streamen, an einen anderen Algorithmus derselben Session übergeben, etwa kNN zum Finden ähnlicher Knoten oder k-Means zum Clustern, oder in die Datenbank zurückschreiben, sofern die Session an eine angebunden ist.
Der Aufruf schlägt fehl, wenn der Graph bereits eine Eigenschaft mit demselben Namen enthält, sodass bestehende Embeddings nicht versehentlich überschrieben werden. Neo4j empfiehlt, beim Experimentieren jedem Satz von Embeddings einen eigenen Eigenschaftsnamen zu geben. In Produktions- oder zeitgesteuerten Pipelines können Nutzer die Eigenschaft zuvor mit fail_if_missing=False entfernen, was den Schritt auch dann sicher macht, wenn die Eigenschaft noch nicht existiert.
Embeddings auf eigenen Eigenschaften und Klassen trainieren
Das Standard-Embedding erfasst nur, wo ein Knoten in der Gesamtform des Graphen sitzt. Auf den Knoten gespeicherte Eigenschaften spielen keine Rolle. Für Fälle, in denen diese Eigenschaften oder bereits klassifizierte Knoten wichtig sind, bietet Neo4j gds.embedding.train an, das ein GraphSAGE-Modell trainiert, das aus Knoteneigenschaften und bekannten Klassen lernt.
Nutzer verweisen den Aufruf auf die Eigenschaft mit den bekannten Klassen (target_label und target_property), auf die Eigenschaften, aus denen gelernt werden soll (feature_properties), und auf einen Modellnamen. Laut Neo4j bringt ein kleiner Klassifikator, der auf den bekannten Klassen trainiert wird, dem Encoder bei, welche Muster wichtig sind. Encoder und Klassifikator lassen sich ebenso abstimmen wie die Zahl der Epochen und die Batchgröße.
Der gespeicherte Encoder wird dann über das Argument graph_encoder an create übergeben, womit der Workflow wieder auf einen einzigen Aufruf schrumpft. Neo4j warnt, dass das Modell seine Trainingsbeispiele bereits gesehen hat, die Ergebnisse also an Knoten beurteilt werden sollten, auf denen es nicht trainiert wurde. Das trainierte Modell ist ein reguläres Aura-Graph-Analytics-Modell und kann mit gds.model.store im Modellkatalog des Projekts für eine spätere Session abgelegt werden.
Verfügbarkeit und Ausblick
Aura Graph Analytics ist in der Stufe AuraDB Free verfügbar, die API lässt sich also kostenlos ausprobieren. Die Daten müssen nicht in Neo4j liegen: Knoten und Beziehungen aus einem Data Warehouse, aus Databricks oder aus einer CSV-Datei lassen sich in pandas-DataFrames laden, und gds.graph.construct macht daraus in einer Standalone-Session einen Graphen. Die Dokumentation enthält einen Quickstart, der auf Cora läuft, einem kleinen Zitationsgraphen, der mit dem GDS Python Client ausgeliefert wird.
Beide Endpunkte befinden sich in der Preview und können sich daher ändern. Die API ist nur in Aura Graph Analytics mit GDS Python Client ab Version 2.2 verfügbar. Neo4j kündigt an, weitere Funktionen zur Erzeugung und Nutzung von Embeddings hinzuzufügen und die API auch in die Cypher-API zu bringen. Feedback erbittet das Unternehmen im Neo4j Community Forum.
Als Einsatzmöglichkeiten nennt Neo4j etwa das Markieren von Konten, die bekannten Betrügern ähneln, Produktempfehlungen auf Basis ähnlicher Kunden, Kundensegmentierung und das Einspeisen der Vektoren in Standardmodelle zur Vorhersage von Kundenabwanderung. Für KI-Agenten auf Basis von Knowledge Graphs könne zudem die Kombination aus Text- und Graph-Embeddings verwandte Entitäten finden, die allein über Text unentdeckt blieben.
Neo4j: Graph Embeddings, One Line of Code Away