NVIDIA meldet bis zu 4,45-fach schnellere FLUX-3-Bildgenerierung
NVIDIA zufolge kann die TensorRT-LLM-VisualGen-Laufzeit die Generierung von FLUX 3 Image Klein für Image-to-Image-Workloads auf einer einzelnen Blackwell-GPU um bis zu 4,45-fach beschleunigen. Die Ergebnisse stammen aus einem Tutorial zu Quantisierung, Attention, Caching und der Ausführung auf mehreren GPUs.
- NVIDIA meldete eine bis zu 4,45-fach schnellere FLUX-3-Image-to-Image-Generierung.
- NVFP4 ermöglichte eine bis zu 1,62-fach schnellere Text-to-Image-Generierung als BF16.
- VC-Attention FP8 erreichte beim Base-Modell eine Beschleunigung um den Faktor 1,18.
- Acht B200-GPUs senkten die mediane Text-to-Image-Latenz des Base-Modells auf 3,00 Sekunden.
- Das Tutorial enthält YAML-Konfigurationen und Anleitungen für die Bereitstellung.
Blackwell-Optimierungen zielen auf die FLUX-3-Latenz
In einem Beitrag vom Nov 06, 2026 beschreibt NVIDIA Bereitstellungs- und Optimierungstechniken für FLUX 3 Image Klein, ein Modell zur Bildgenerierung und -bearbeitung von Black Forest Labs. Das Modell wurde auf NVIDIA GB200 NVL72 trainiert und ist für NVIDIA-GPUs optimiert.
FLUX 3 Image Klein kombiniert Qwen3-VL-4B-Instruct für die Textkonditionierung, einen Diffusion Transformer zur Verfeinerung von Bild-Latents sowie einen Autoencoder, der Latents in Bilder dekodiert und Referenzeingaben für die Image-to-Image-Generierung kodiert. Das Modell ist als Base- und als Distilled-Checkpoint verfügbar, die unterschiedliche Anforderungen an Latenz und Detailtreue erfüllen.
NVIDIA meldete für den Base-Checkpoint bei 2048×2048 durch kombinierte Optimierungen eine bis zu 3,46-fach schnellere Text-to-Image-Generierung und eine bis zu 4,45-fach schnellere Image-to-Image-Generierung. Als Vergleich diente eine nicht kompilierte BF16-Inferenz auf einer NVIDIA B200 GPU.
Quantisierung und Attention reduzieren den Hauptengpass
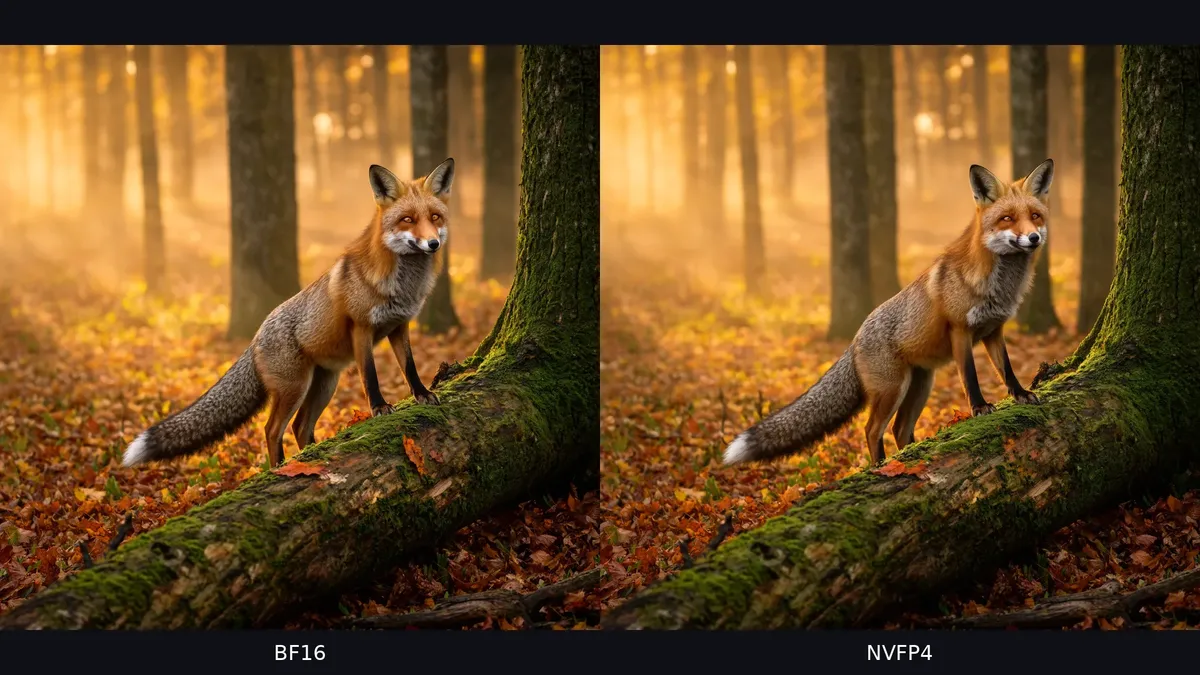
TensorRT LLM VisualGen unterstützt Varianten mit BF16, FP8 und NVFP4. In den Tests von NVIDIA auf einer Blackwell-GPU lieferte NVFP4 eine bis zu 1,62-fach schnellere Text-to-Image-Generierung und eine bis zu 1,58-fach schnellere Image-to-Image-Generierung als BF16.
Das Tutorial identifiziert das Denoising als wichtigste Latenzquelle auf der B200. Bei 2048×2048 entfielen in den gemeldeten Tests 96,8 % der Base-Text-to-Image-Pipeline und 97,8 % der Base-Image-to-Image-Pipeline auf das Denoising. Das Base-Modell nutzte 50 Denoising-Schritte und einen Classifier-Free-Guidance-Wert von 3,5, während das Distilled-Modell 16 Schritte ohne Classifier-Free Guidance verwendete.
VisualGen nutzt optimierte GEMM-Kernels, zusammengefasste Operationen, quantisierte Attention und Sparse Attention, um diesen Aufwand zu senken. NVIDIA meldete, dass VC-Attention FP8 die Generierung beim Base-Modell um den Faktor 1,18 und beim Distilled-Modell um den Faktor 1,16 beschleunigte, bei LPIPS-Werten von 0,086 und 0,151. LPIPS misst wahrnehmungsbezogene Unterschiede zur jeweiligen Baseline, wobei niedrigere Werte eine größere Ähnlichkeit anzeigen.
Skalierung über mehrere GPUs und Zugriff auf das Tutorial
Der Beitrag beschreibt außerdem Sol-Attention, Cache-DiT-Step-Caching und die Ausführung auf mehreren GPUs. Mit Sol-Attention bei τ=1,0 und 12 anfänglichen dichten Schritten meldete NVIDIA für das Base-Modell ein um den Faktor 1,30 schnelleres Denoising einschließlich Dekodierung. Die Verwendung von 16 dichten Schritten priorisierte die Detailtreue und lieferte eine um den Faktor 1,24 höhere Geschwindigkeit. Cache-DiT erreichte beim Base-Modell bei 2048×2048 eine Beschleunigung um den Faktor 1,94 bei einem LPIPS-Wert von 0,033.
Durch Classifier-Free Guidance und Ulysses-Parallelisierung über acht B200-GPUs sank die mediane Text-to-Image-Latenz beim Base-Modell von 14,90 auf 3,00 Sekunden und beim Distilled-Modell von 2,73 auf 1,08 Sekunden. Die entsprechenden Beschleunigungen beim Denoising betrugen 6,01-fach und 4,44-fach.
Entwickler können das FLUX-3-Beispiel von NVIDIA mit den bereitgestellten YAML-Konfigurationen ausführen, die VisualGen-Laufzeit und Optimierungswerkzeuge erkunden sowie Ergebnisse teilen oder Fehler im TensorRT-LLM-GitHub melden. Das Tutorial richtet sich an Designtools, Bildbearbeitungsprogramme und visuelle Produktions-Workflows, bei denen die Latenz hochauflösender Inferenz eine wichtige Rolle spielt.
NVIDIA Developer: Speed Up Image Generation with FLUX 3 Image Klein on NVIDIA Blackwell GPUs