NVIDIA CUDA 13.4 bringt GPU-Sharing mit durchgesetzten Speichergrenzen in Kubernetes
Mit CUDA 13.4 kann NVIDIA für jeden Workload, der sich eine GPU teilt, eine Speichergrenze durchsetzen. Ein neuer Open-Source-Operator für Kubernetes namens gpu-fractioning macht diese Funktion für Cluster nutzbar. KAI Scheduler v0.18.0 ist der erste Scheduler, der den Operator integriert.
- CUDA 13.4 erzwingt Speichergrenzen pro Workload, transparent für Anwendungen, mit einem neuen Time-Sharing-Modus neben sm-sharing.
- Der Open-Source-Operator gpu-fractioning betreibt MPS auf jedem GPU-Knoten, wendet Speicherlimits und Rechenmodi an und misst die Nutzung pro Anteil.
- KAI Scheduler v0.18.0 ist der erste integrierte Scheduler, über seinen NvFractions-Modus, der per Helm-Flag aktiviert wird.
- Workloads können exakten Speicher oder einen GPU-Anteil anfordern, mit optionalen Burst-Limits und der Wahl zwischen Time-Slicing und sm-sharing.
- Laut NVIDIA kann jeder Kubernetes-Scheduler, der die erforderlichen Pod-Annotationen schreibt, den Operator nutzen.
Warum GPU-Sharing wichtig ist
Laut NVIDIA benötigen viele KI-Workloads nur einen Bruchteil einer GPU, und wer jedem davon ein ganzes Gerät zuweist, lässt mitunter Kapazität ungenutzt. Durch die gemeinsame Nutzung von GPUs können Plattformteams mit der vorhandenen Infrastruktur mehr Workloads bedienen.
NVIDIA-GPUs unterstützen bereits mehrere Verfahren zur gemeinsamen Nutzung. Multi-Instance GPU (MIG) teilt eine GPU in hardwareisolierte Instanzen auf, die für die Anwendung transparent sind. Beim Time-Slicing wechseln sich mehrere Prozesse ab, ohne dass der Speicher begrenzt wird. Der Multi-Process Service (MPS) lässt Prozesse in getrennten Adressräumen gleichzeitig laufen, ein Modus namens sm-sharing.
CUDA 13.4 ergänzt eine für die Anwendung transparente Speichergrenze sowie einen neuen Time-Sharing-Modus. Der bereits vorhandene Rechenmodus sm-sharing aus MPS bleibt weiterhin verfügbar.
Was CUDA 13.4 durchsetzt
NVIDIA nennt für die Version vier Funktionen:
- Eine exakte Speichermenge: Ein Workload fordert eine Speichergröße an, und CUDA hält ihn bei diesem Wert. Eine Allokation darüber hinaus schlägt fehl, so als läge sie auf einer kleineren GPU.
- Ein Bereich: Ein Workload erhält ein garantiertes Minimum sowie ein Maximum, in das er hineinwachsen kann, wenn Speicher frei ist.
- Ein Rechenmodus: Jeder Workload kann statt des standardmäßigen Time-Sharing-Modus sm-sharing wählen.
- Ein transparentes Speicherlimit: Jeder Workload sieht nur einen Teil des GPU-Speichers.
CUDA liefert die Durchsetzung, doch ein Kubernetes-Cluster kann sie nicht von allein nutzen. Auf jedem GPU-Knoten muss etwas laufen, das die Daemons überwacht, von denen diese Funktionen abhängen, die Speicherlimits und den Rechenmodus jedes Pod-Containers anwendet, bevor der Prozess startet, und das meldet, was jeder Anteil tatsächlich verbraucht, statt was die gesamte GPU verbraucht.
Der GPU Fractioning Operator
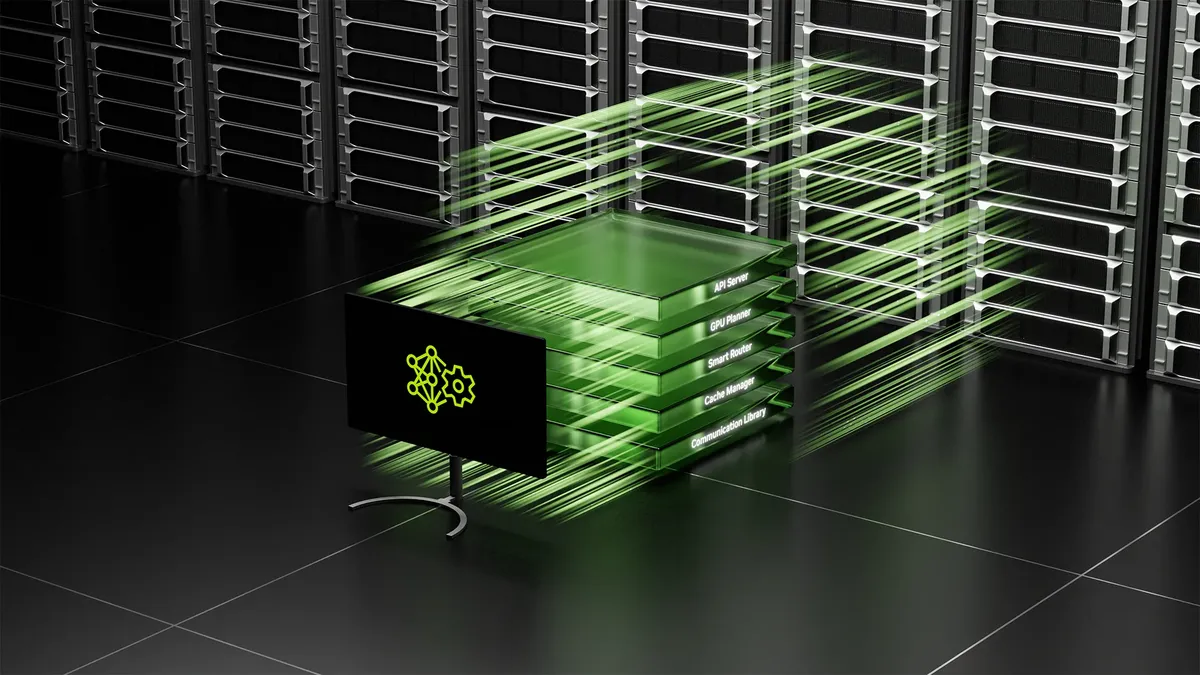
Der gpu-fractioning-Operator wird unter der KAI-Scheduler-Organisation auf GitHub gehostet. Er läuft neben dem NVIDIA GPU Operator, der den Treiber und die Einrichtung der Container-Runtime bereitstellt. Er richtet MPS auf jedem GPU-Knoten ein und betreibt es, wendet die Speicherlimits und den Rechenmodus jedes Workloads an und misst die Speicher- und Rechennutzung pro Anteil statt pro GPU.
Der Operator liest Pod-Annotationen pro Container, die der Scheduler schreibt. Dazu gehören eine garantierte Speicheranforderung, ein maximales Speicherlimit, der Rechenmodus (standardmäßig Time-Slicing, alternativ sm-sharing) und die dem Container zugewiesenen GPUs. Laut NVIDIA kann jeder Kubernetes-Scheduler, der diese Annotationen schreiben kann, GPU-Anteile mit CUDA durchsetzen. Der Scheduler muss weiterhin eine GPU mit ausreichend freiem Speicher auswählen und darf auf einer GPU nie verschiedene Rechenmodi mischen.
Integration in den KAI Scheduler
Ab v0.18.0 verfügt der KAI Scheduler über einen GPU-Sharing-Modus namens NvFractions. Der Scheduler bestimmt, welchen Ausschnitt welcher GPU jeder Workload erhält, und schreibt die Annotationen, während gpu-fractioning sie auf dem Knoten durchsetzt. Die übrigen Sharing-Modi von KAI bleiben verfügbar, Administratoren wählen pro Cluster einen aus. NvFractions wird bei der Installation mit dem Helm-Flag --set global.nvFractions.set=true aktiviert, das gpu-fractioning zugleich als Abhängigkeit installiert.
Workloads können Speicher als absolute Größe in gängigen Kubernetes-Einheiten anfordern oder als Anteil einer GPU über die bestehende Annotation gpu-fraction, zum Beispiel 0.5. Ein optionales Limit erlaubt es einem Workload, über seine Anforderung hinaus zu wachsen. Fehlt es, entspricht das Limit der Anforderung, und der Workload ist exakt auf das Angeforderte begrenzt. Ein Anteilslimit muss größer als gpu-fraction und kleiner als 1 sein. Die Annotation gpu-fraction-num-devices verteilt eine Anforderung auf mehrere GPUs, wobei die Anforderung für jedes Gerät gilt. Eine Anforderung von 40Gi mit vier Geräten erhält 40Gi auf jeder von vier GPUs.
Beim Rechnen arbeitet Time-Slicing seriell: Die Workloads wechseln sich auf der gesamten GPU ab, jeder läuft in einer eigenen Fehlerdomäne, und dies ist der Standard. SM-Sharing teilt die Streaming-Multiprozessoren auf Workloads auf, die gleichzeitig laufen und sich eine einzige Fehlerdomäne teilen. Eine geteilte GPU läuft jeweils in einem Rechenmodus, weshalb der KAI Scheduler nie beide Arten auf derselben GPU platziert. Er verfolgt das pro GPU, sodass ein Knoten beide Modi auf verschiedenen GPUs beherbergen kann.
Was das für Plattformteams bedeutet
Für Teams, die gemeinsam genutzte GPU-Cluster auf Kubernetes betreiben, bietet die Änderung eine Möglichkeit, den Speicher jedes Workloads zu begrenzen, ohne auf MIG-Hardwarepartitionen angewiesen zu sein. NVIDIA verweist für Installation und Konfiguration auf das Repository des GPU Fractioning Operators, außerdem auf Administrator- und Nutzerhandbücher sowie auf einen Slack-Kanal und zweiwöchentliche Community-Treffen.
NVIDIA Developer: Memory-Enforced GPU Sharing in Kubernetes with NVIDIA CUDA 13.4