NVIDIA DSX MaxLPS steigert Durchsatz von KI-Fabriken um 49,2 Prozent bei gleichem Strombudget
Mit der Software DSX MaxLPS lassen sich laut NVIDIA bis zu 40 Prozent mehr GPUs im selben genehmigten Strombudget betreiben. In einer gemeinsamen Evaluierung mit Nscale stieg der Gesamtdurchsatz um 49,2 Prozent, während der Durchsatz pro Instanz praktisch unverändert blieb.
- Laut NVIDIA ermöglicht DSX MaxLPS bis zu 40 % mehr GPUs im selben genehmigten Strombudget.
- In einem gemeinsamen Test mit Nscale ersetzten 192 GPUs 140 GPUs im gleichen Budget von 264,4 kW.
- Der Gesamtdurchsatz stieg um 49,2 %, der Durchsatz pro bereitgestelltem Watt von 4,10 auf 6,12 Tokens/s/W.
- Median- und P75-Latenz blieben innerhalb von 5 % der Baseline, die P99-Zeit bis zum ersten Token stieg jedoch um 17 %.
- NVIDIA empfiehlt vor dem Produktiveinsatz ein fünfstufiges Validierungsverfahren.
Warum statische Planung Strom ungenutzt lässt
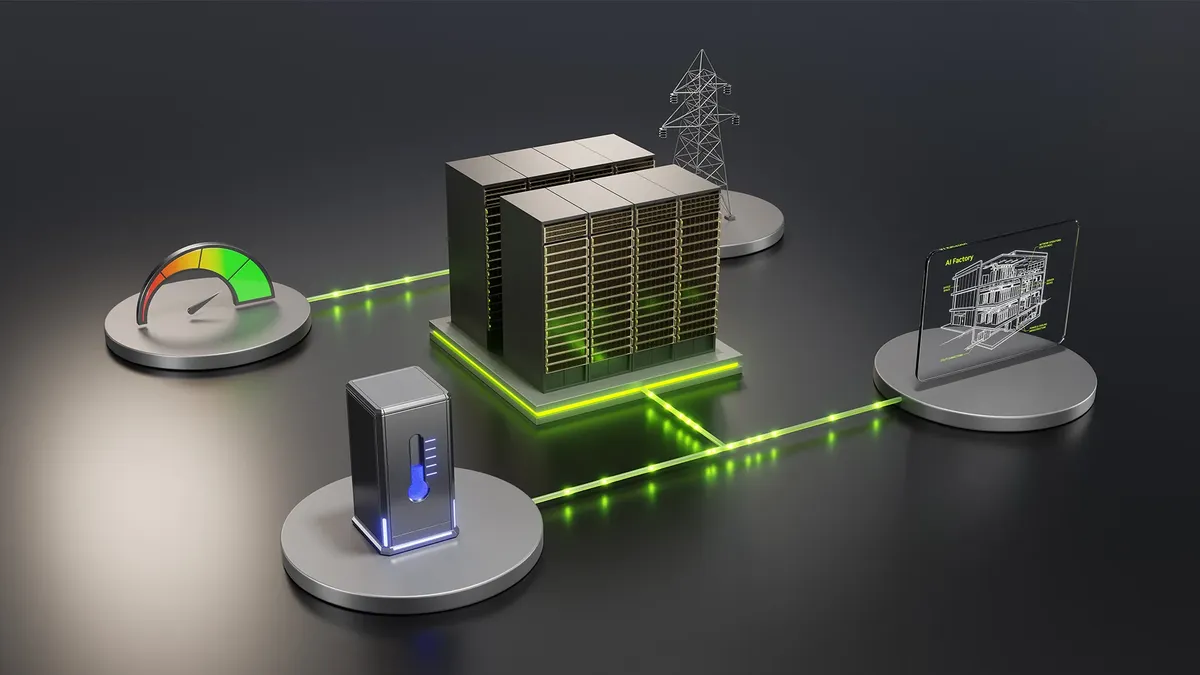
KI-Fabriken arbeiten innerhalb einer Hierarchie elektrischer Grenzen: Netzanschluss, Umspannwerke, Stromverteilung, Racks, Nodes und GPUs. Bei der statischen Leistungsplanung wird üblicherweise so viel Strom reserviert, dass jeder Node gleichzeitig seine spezifizierte Spitzenleistung erreichen kann. NVIDIA bezeichnet diesen Ansatz als konservativ und weist darauf hin, dass KI-Workloads selten konstant Strom ziehen.
Training durchläuft Phasen aus Berechnung, Kommunikation, Synchronisation und Checkpointing. Inferenz wechselt zwischen Prefill, Decode, speichergebundener Arbeit, Netzwerkaktivität und Leerlaufphasen. Diese Schwankungen erzeugen eine Lücke zwischen reservierter Spitzenleistung und tatsächlichem Verbrauch. Bei statischen Reservierungen pro Node lässt sich ungenutzte Kapazität aus einer Reservierung nicht auf einen anderen Node übertragen. So kann die Anlage unter ihrem Limit bleiben, während zusätzliche GPU-Kapazität ungenutzt offline bleibt.
DSX MaxLPS überwacht den tatsächlichen Stromverbrauch und verteilt verfügbare Leistung auf die beteiligten Ressourcen um, wobei das Gesamtbudget und die Richtliniengrenzen des Betreibers erhalten bleiben. NVIDIA betont, dass es sich um eine koordinierte Zuteilung handelt und nicht um eine Erhöhung der Stromversorgung des Standorts.
So funktioniert der Regelkreis
DSX MaxLPS kombiniert Chip-, System-, Thermik- und Softwaretechnologien, um die Leistung innerhalb der Beschränkungen von Fläche, Strom und Gebäudehülle (Land, Power and Shell, LPS) zu maximieren. Die Dynamic Power Software bildet die Steuerungsebene. NVIDIA beschreibt fünf technische Elemente:
- Topologie und Ressourcengruppen: Betreiber bilden die Infrastruktur ab und ordnen Nodes einer verwalteten Gruppe mit einem gemeinsamen Strombudget zu.
- Telemetrie: Leistungsdaten von GPU, Node, Rack und Gruppe werden in Intervallen erfasst, die ausreichen, um Spielraum und sich anbahnende Leistungsspitzen zu erkennen.
- Richtlinien: Vom Betreiber definierte Regeln legen Node-Limits, Gruppenlimits, Zuteilungsprioritäten, Reserveanforderungen und das Verhalten bei Wartungs- oder Notfallereignissen fest.
- Zuteilung und Steuerung: Wenn manche Ressourcen weniger als ihre Zuteilung ziehen, passt die Software die GPU-Leistungslimits an, damit andere die Kapazität nutzen können.
- Validierung und Durchsetzung: Die gemessene Leistung wird mit dem genehmigten Gruppenbudget verglichen, und die Zuteilungen werden angepasst, sobald der Verbrauch sich einem Limit nähert.
Testaufbau und Ergebnisse bei Nscale
Die Evaluierung lief mit Kimi K2.5 in FP4 auf NVIDIA GB300 NVL72-Systemen mit NVIDIA Blackwell Ultra GPUs im Rechenzentrum von Nscale auf dem Verne-Campus in Keflavík, Island, das laut NVIDIA vollständig mit erneuerbarer Energie betrieben wird. Nscale setzte die Software ein und erfasste die Telemetrie, NVIDIA führte die Workloads aus. Der Stack umfasste NVIDIA Dynamo und NVIDIA TensorRT LLM, mit einer Eingabesequenzlänge von 8K und einer Ausgabesequenzlänge von 1K.
Die statische Baseline nutzte 35 Nodes mit je vier GPUs, also 140 GPUs, und betrieb zwei Instanzen für hohen Durchsatz mit je 52 GPUs sowie eine Instanz für niedrige Latenz mit 36 GPUs. Die DSX-MaxLPS-Konfiguration verwendete 48 Nodes mit je vier GPUs, also 192 GPUs, und ergänzte eine dritte Hochdurchsatz-Instanz mit 52 GPUs. Beide arbeiteten mit demselben bereitgestellten Strombudget von 264,4 kW. Jeder verteilte Workload war auf ein einzelnes Rack beschränkt, um Leistungsunterschiede zwischen Racks auszuschließen.
- Der Gesamtdurchsatz stieg von 1.084.503 Tokens/s auf 1.618.443 Tokens/s, ein Plus von 49,2 %.
- Der Durchsatz pro bereitgestelltem Watt stieg von 4,10 auf 6,12 Tokens/s/W.
- Die Hochdurchsatz-Ausgabe pro Instanz stieg von 59.153 auf 59.220 Tokens/s, ein Plus von 0,1 %. Die Ausgabe pro Instanz mit niedriger Latenz blieb bei 2.265 Tokens/s.
- Die insgesamt gemessene Leistung stieg von 166,2 kW auf 198,9 kW, die Auslastung des Strombudgets von 62,9 % auf 75,2 %.
Median- und P75-Latenz blieben innerhalb von 5 % der Baseline. Die P99-Zeit bis zum ersten Token (Time to First Token) stieg jedoch um 17 % gegenüber einer Baseline von 15,7 Sekunden. NVIDIA sieht darin einen Beleg dafür, dass die Tail-Latenz neben Kapazität und Durchsatz bewertet werden sollte.
Fünfstufige Validierung für Betreiber
NVIDIA skizziert für Betreiber ein wiederholbares Vorgehen vor dem Einsatz im großen Maßstab: die verwaltete Grenze definieren, eine repräsentative Baseline erstellen, Richtlinien vorsichtig einführen, Kapazität schrittweise mit Tests in jeder Stufe ausbauen und Betriebsgrenzen für die Produktion erst festlegen, wenn alle Ziele erreicht sind.
Die Ergebnisse deuten darauf hin, dass sich der Spielraum zwischen reservierter und tatsächlicher Leistung in zusätzliche GPU-Kapazität umwandeln lässt, ohne den Durchsatz bestehender Instanzen zu senken. Der Anstieg der P99-Zeit bis zum ersten Token um 17 % zeigt, dass der Gewinn mit einem Kompromiss am Rand der Verteilung einhergeht. Betreiber mit strengen Latenzzielen müssten ihn daher an den eigenen Workloads prüfen. Für weitere Details verweist NVIDIA auf sein DSX-MaxLPS-Framework und die Dokumentation der Dynamic Power Software.
NVIDIA Developer: How NVIDIA DSX MaxLPS Maximizes AI Factory Throughput and Efficiency