NVIDIA beschreibt Indic-Pretraining mit 2,8 Billionen Tokens und offene Pipeline zur Datengenerierung
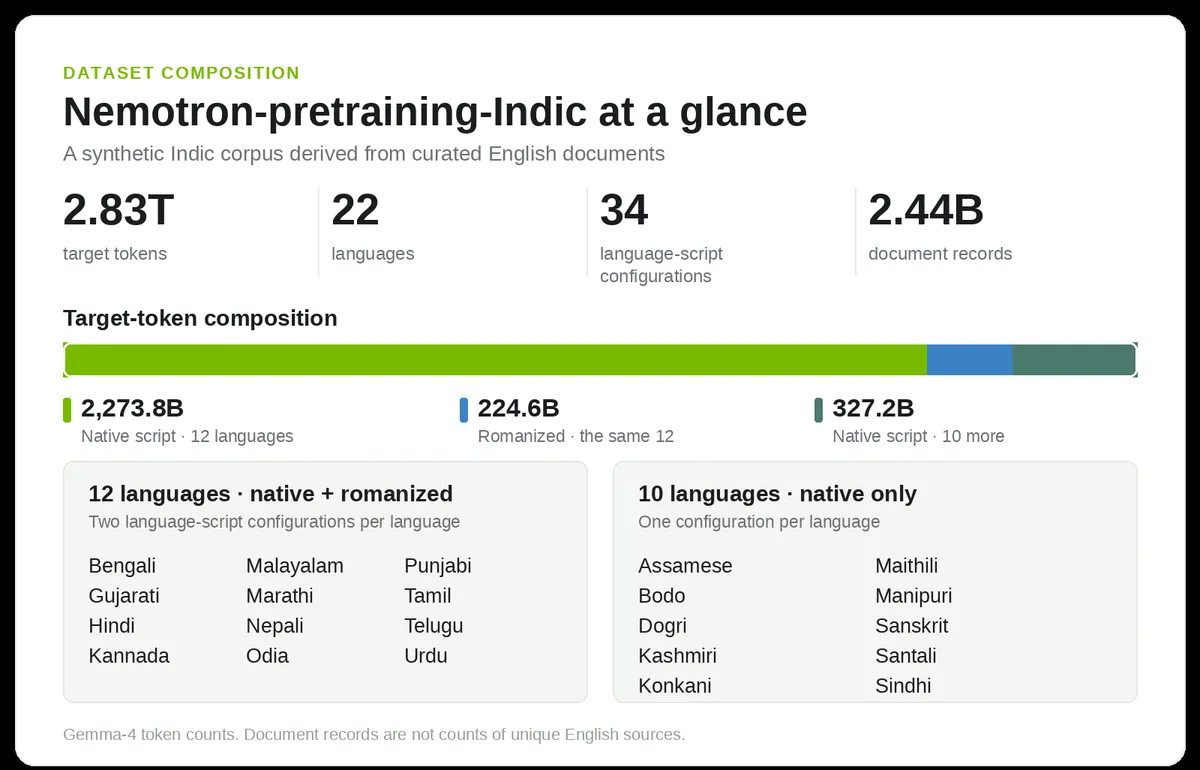
NVIDIA hat im Hugging-Face-Blog einen Beitrag mit dem Titel „Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline“ veröffentlicht. Er verweist auf ein groß angelegtes Vorhaben, Trainingsdaten für indische Sprachen aufzubauen. Der Beitrag verlinkt zugehörige Modelle, Datensätze und Collections aus der Nemotron-Familie.
- Der Hugging-Face-Beitrag von NVIDIA trägt den Titel „Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline“.
- Der Beitrag verweist auf 4 Modelle, 4 Datensätze und 2 Collections.
- Eine verlinkte Collection enthält umfangreiche Pretraining-Datensätze, die in der Nemotron-Modellfamilie verwendet werden.
- Der vorliegende Text enthält nicht den Artikelkörper, daher sind Methoden, Sprachen und Lizenzierung nicht bestätigt.
Worum es in dem Beitrag geht
Der Titel des Beitrags nennt zwei Dinge: ein Pretraining für indische Sprachen, das 2,8 Billionen Tokens erreicht, und eine offene Pipeline zur Datengenerierung. Der Beitrag erscheint im nvidia-Bereich des Hugging-Face-Blogs; die jüngsten anderen Beiträge des Autors drehen sich um NVIDIA-Tools und -Modelle.
Für diesen Bericht lagen nur der Titel der Seite und umliegende Listen vor, nicht aber der Haupttext des Artikels. Angaben dazu, welche Sprachen abgedeckt sind, wie die Tokens erzeugt wurden, welche Modelle damit trainiert wurden und wie die Pipeline funktioniert, sind daher nicht bestätigt.
Verlinkte Modelle, Datensätze und Collections
Auf der Seite ist zu sehen, dass der Beitrag auf 4 Modelle, 4 Datensätze und 2 Collections verweist. Unter den gelisteten Modellen finden sich ein Übersetzungsmodell mit 8B Parametern, ein Image-Text-to-Text-Modell mit 31B, ein Textgenerierungsmodell mit 124B und ein weiteres Image-Text-to-Text-Modell mit 66B. Wie jedes dieser Modelle mit der Indic-Arbeit zusammenhängt, geht aus den Listen nicht hervor.
In den Listen sind zwei Collections genannt. Die eine wird als „Large scale pre-training datasets used in the Nemotron family of models“ beschrieben und umfasst 16 Einträge. Die andere trägt die Beschreibung „Datasets for building helpful, multi-turn, instruction-following conversational models across single and multi-turn settings“ und umfasst 19 Einträge. Beide liegen auf Hugging Face, was darauf hindeutet, dass die Daten externen Entwicklern zugänglich sein sollen. Lizenzbedingungen nennt der vorliegende Text jedoch nicht.
Weitere Beiträge desselben Autors
Die Seite führt außerdem zwei weitere aktuelle Beiträge desselben Autors auf. Der eine heißt „Fine-Tune ASR for Your Domain with NVIDIA Speech Agent Skills“ und ist auf den 13. Oktober 2026 datiert. Der andere trägt den Titel „One Model Family, Two Gold-Level Results: Fine-Tuning Nemotron for IOI and IMO“ und stammt vom 7. Oktober 2026. Zusammen zeigen sie eine Reihe von Nemotron-bezogenen Veröffentlichungen auf Hugging Face im Oktober.
Was das bedeutet
Nach dem Titel allein zu urteilen, zielt die Veröffentlichung auf die Datenseite der Entwicklung von Sprachmodellen für indische Sprachen. Ein angegebener Umfang von 2,8 Billionen Tokens und eine offene Pipeline könnten Entwicklern die Möglichkeit geben, eigene Datensätze aufzubauen oder zu erweitern. Wie nützlich das tatsächlich ist, hängt von Details ab, die der vorliegende Text nicht liefert, darunter Sprachabdeckung, Datenqualität und Lizenzierung. Wer die Arbeit bewerten möchte, sollte den vollständigen Beitrag und die verlinkten Datensatzseiten auf Hugging Face heranziehen.