NVIDIA Nemotron 3.5 Super VL bringt multimodales Reasoning in Unternehmens-Agenten
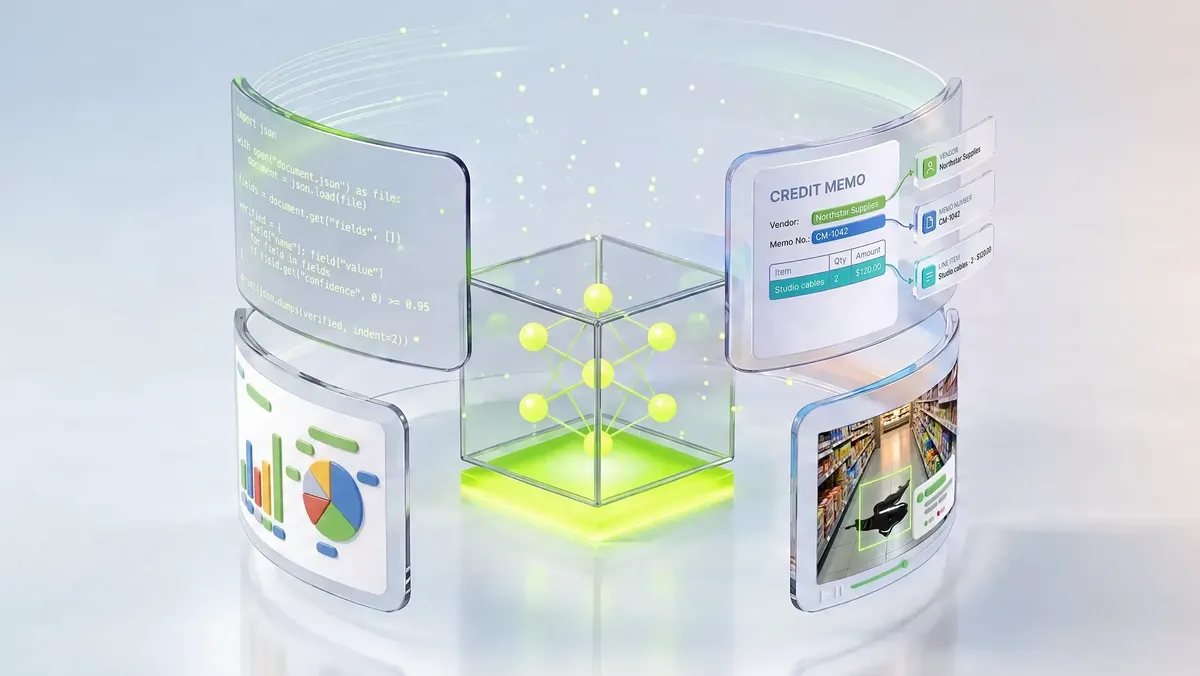
NVIDIA hat Nemotron 3.5 Super VL vorgestellt, ein offenes, anpassbares multimodales Modell für spezialisierte agentische Workflows. Laut NVIDIA setzt es auf eine Mixture-of-Experts-Architektur mit 120 Milliarden Parametern, von denen pro Token 12 Milliarden aktiv sind, und verarbeitet Text, Bilder, Dokumente und Videos in einem einzigen Modell.
- Nemotron 3.5 Super VL ist ein offenes multimodales Modell mit insgesamt 120 Milliarden Parametern, von denen 12 Milliarden pro Token aktiv sind.
- NVIDIA nennt bei agentischen Aufgaben auf einer einzelnen GPU bis zu 5-mal höheren Durchsatz als bei anderen offenen Modellen seiner Größenklasse.
- Beim Benchmark CharXiv erreichte das Modell 80,8 %, Nemotron 3 Nano Omni kam auf 63 %.
- Scale AI, Ramp und AI21 berichten oder erwarten nach dem Post-Training Verbesserungen bei Kosten, Latenz, Durchsatz und Genauigkeit.
- NVIDIA veröffentlicht offene Datensätze auf Hugging Face, darunter 45 Vision-Language-Datensätze, für Fine-Tuning und RL.
Ein Modell für Text- und visuelle Agentenaufgaben
NVIDIA zufolge übernehmen Unternehmensagenten zunehmend längere und komplexere Workflows. Eine einzelne Anfrage kann bedeuten, ein Dokument zu lesen, Informationen über mehrere Quellen hinweg zu prüfen, Unternehmensrichtlinien zu befolgen und mehrere Tools aufzurufen. Nemotron 3.5 Super VL ist auf genau solche Aufgaben ausgerichtet.
Das Modell vereint Reasoning, Befolgen von Anweisungen und Tool-Nutzung mit dem Verständnis von Text, Bildern, Dokumenten und Videos. Nach Angaben von NVIDIA können Teams dadurch Text- und visuelle Aufgaben bewältigen, ohne getrennte Text- und Vision-Language-Modelle einzusetzen oder den Aufgabenkontext zwischen ihnen weiterzureichen.
Auf einer einzelnen GPU liefert das Modell laut Unternehmen bei agentischen Aufgaben bis zu 5-mal höheren Durchsatz als andere offene Modelle seiner Größenklasse. NVIDIA nennt zudem mehr als 600 TPS bei den agentischen Aufgaben des Artificial Analysis Intelligence Index am Baseten-Endpunkt.
NVIDIA nennt mehrere Zielanwendungen:
- Coding: Code testen und validieren, Fehler analysieren und Korrekturen empfehlen.
- Web-Recherche: Websites durchsuchen, Informationen verknüpfen und Antworten verifizieren.
- Dokumentenintelligenz: Informationen aus Tabellen, Diagrammen und Seitenlayouts extrahieren, um Zusammenfassungen und Berichte zu erstellen.
- Cybersicherheit: Schwachstellen erkennen und Bedrohungen priorisieren.
- Videoverständnis: Informationen für Suche, Inhaltsprüfung und Vorfallanalyse extrahieren.
In einem System aus mehreren Modellen positioniert NVIDIA Nemotron 3.5 Super VL für spezialisierte, mehrstufige Aufgaben. Kleinere Modelle wie Nemotron 3.5 Lightning übernehmen Textaufgaben mit hohem Volumen, während Frontier-Modelle wie Nemotron 3 Ultra komplexe Planung und Orchestrierung verantworten.
Anpassung und Ergebnisse früher Anwender
Entwickler können das Modell mit NVIDIA NeMo anhand eigener Daten, Tools, Richtlinien und Workflows nachtrainieren. NeMo AutoModel unterstützt Supervised Fine-Tuning (SFT) und Low-Rank Adaptation (LoRA), während Reinforcement Learning eingesetzt wird, um die Leistung in agentischen Umgebungen zu verbessern, die organisationsspezifische Workflows abbilden. NVIDIA verweist außerdem auf NeMo RL und NeMo Gym für RL und umgebungsbasierte Evaluierung.
Zusammen mit dem Modell veröffentlicht NVIDIA offene Datensätze auf Hugging Face. Dazu gehören agentische Tool-Use- und Konversationsdaten, Datensätze für Finanz-Reasoning und Tool-Calling, Daten zum Befolgen von Anweisungen und für Chats, Long-Context-Transduktions- und Übersetzungsdaten, Fairness-Daten sowie 45 Vision-Language-Datensätze. Organisationen können die offenen Gewichte anpassen und in unterstützten lokalen, Rechenzentrums- oder Cloud-Umgebungen betreiben.
NVIDIA nennt drei Beispiele für Post-Training:
- Scale AI hat das Modell für die automatisierte Verarbeitung von Lieferantengutschriften bei der Skydance Corporation nachtrainiert. Die Inferenzkosten für diese Aufgabe sinken laut NVIDIA um das 40-Fache, die Latenz um das 5-Fache.
- Ramp wandelt Belegbilder in strukturiertes JSON mit Händlerinformationen, Datumsangaben und Zahlungsdaten um. Das Unternehmen erwartet bis zu 50 % höheren Durchsatz und 10-mal geringere Latenz.
- AI21 hat das Modell für Bedrohungsanalyse und Schwachstellenanalyse beim KI-Sicherheitsunternehmen Alice nachtrainiert und die Genauigkeit um 40 % verbessert.
Visuelles Training und Benchmark-Ergebnisse
Das visuelle Training des Modells umfasst Diagramme, Tabellen, optische Zeichenerkennung (OCR), mehrseitige Dokumente und Videoverständnis. Eine zweistufige SFT-Pipeline trainiert die Sprach- und Vision-Komponenten und kombiniert dabei visuelle Evidenz mit Reasoning-, Chat- und Sicherheitsdaten, Long-Context-Daten und Agententrajektorien.
NVIDIA zufolge hat vielfältiges Trainingsmaterial, das mit NeMo Data Designer erzeugt wurde, dem Modell geholfen, komplexe Diagramme zu verstehen. Beim Benchmark CharXiv für Diagramm-Reasoning erzielte das Modell 80,8 %, verglichen mit 63 % bei Nemotron 3 Nano Omni. Mit Python-Code-Interpretation erreichte es 84 %. NVIDIA beschreibt das Modell zudem als eines der besten offenen Modelle im OCRBench-v2-Ranking.
Bei Agenten-Evaluierungen schneidet Nemotron 3.5 Super VL laut NVIDIA besser ab als Nemotron 3 Ultra, und zwar bei Hermes Bench und den Verhaltensevaluierungen von LangChain:
- Hermes Bench: 63,44 % für Nemotron 3.5 Super VL, gegenüber 56,33 % für Nemotron 3 Ultra.
- LangChain Evals: 87,05 % gegenüber 84,3 %.
Die Evaluierungen umfassen Hermes, LangChain, OpenClaw, OpenCode, Pi, Codex und Claude. Das Modell entstand mit Unterstützung von Organisationen der Nemotron Coalition: Datensätze von Perplexity halfen, das Mid-Training zu verbessern, und Umgebungen von Prime Intellect ermöglichten bessere Teacher-Modelle.
Inferenzeffizienz und Bedeutung für Teams
NVIDIA zufolge nutzt das Modell LiLiCorr Speculative Decoding, NVFP4-Quantisierung mit quantisierungsbewusster Destillation, Multi-Token-Prediction und Kontext-Wiederverwendung, um die Inferenzeffizienz auf Plattformen wie NVIDIA DGX Spark zu steigern. Das Unternehmen ergänzt, dass bei dauerhaft laufenden Agenten die Effizienz bestimmt, wie viel Arbeit ein Deployment erledigen kann, da Durchsatz, Token-Verbrauch, Tool-Aufrufe und die Zahl der Schritte bis zu einem korrekten Ergebnis die Dauer einer Aufgabe beeinflussen.
Für Organisationen, die Agenten entwickeln, bietet die Veröffentlichung ein Open-Weight-Modell, das sich auf Fachterminologie, Tool-Schnittstellen und Richtlinien abstimmen lässt, statt auf getrennte Text- und Vision-Modelle zu setzen. Die Angaben zu den Anwendern stammen aus NVIDIAs eigener Darstellung, und einige davon, etwa die Zahlen von Scale AI und Ramp, sind als erwartete oder künftige Ergebnisse für bestimmte Workloads formuliert. NVIDIA verweist auf den technischen Bericht zu Nemotron 3.5, ein Nutzungs-Cookbook auf GitHub und NVIDIA NIM für optimiertes Deployment.
NVIDIA Developer: NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning