NVIDIA Recovery automatisiert den Neustart fehlgeschlagener KI-Trainingsjobs
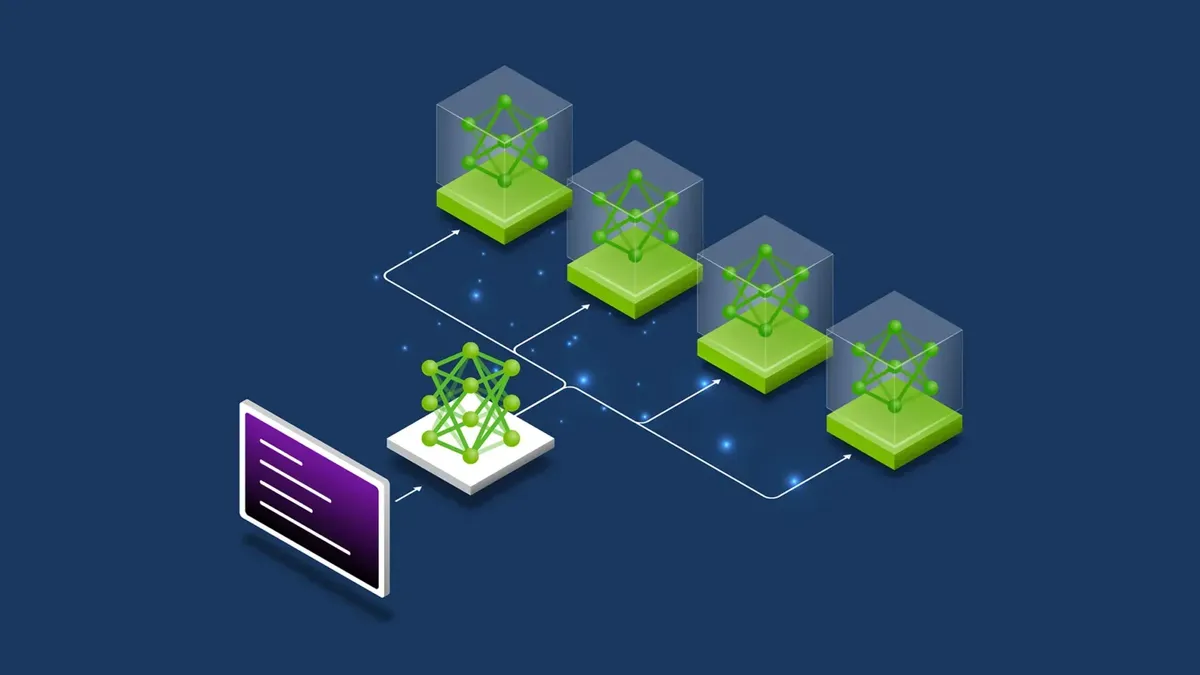
NVIDIA hat mit NVIDIA Recovery einen quelloffenen Dienst vorgestellt, der unterbrochene verteilte Trainingsjobs automatisch erkennt, die betroffenen Knoten isoliert und Workloads ab dem letzten Checkpoint auf gesunder Kapazität neu startet. Laut NVIDIA läuft er rund um die Uhr über alle Trainingsjobs eines Clusters hinweg und ist Teil von NVIDIA DSX OS.
- NVIDIA Recovery ist ein quelloffener Dienst auf Workload-Ebene in NVIDIA DSX OS, der die Wiederherstellung von Trainingsjobs über einen Cluster hinweg automatisiert.
- Er folgt einer vierstufigen Schleife: erkennen, zuordnen, isolieren sowie gemäß Richtlinie neu starten oder stoppen.
- Die Slurm-Integration nutzt einen Referenz-Advisor-Controller, der per Helm-Chart im Cluster oder im SSH-Modus bereitgestellt werden kann.
- Neue Deployments laufen standardmäßig im Monitor-Modus und veröffentlichen Empfehlungen, ohne Scheduler-Aktionen auszuführen.
- Auf einem Cluster verzeichnete NVIDIA vom 9. Juli bis 9. Oktober rund 8.550 Anomalie-Erkennungen, bei einer mittleren Erkennungslatenz von 69 Sekunden und einer Latenz bis zur Wiederherstellungsmaßnahme von 94 Sekunden.
Warum manuelle Wiederherstellung nicht skaliert
NVIDIA beschreibt das Problem anhand des Goodput, also des Anteils der Echtzeit, der tatsächlich in produktiven Trainingsfortschritt umgesetzt wird. Ein hängender Trainingsrang kann einen Timeout der NVIDIA Collective Communications Library (NCCL) auslösen, ein GPU-Knoten kann nicht mehr auf den Scheduler reagieren, oder ein Nachzügler kann einen ganzen Job ausbremsen. Jeder dieser Fälle ist für sich beherrschbar, doch der Aufwand für die Wiederherstellung summiert sich.
Bei manueller Behandlung sind Log-Analyse, Fehlerisolierung und ein Neustart ab einem gespeicherten Checkpoint nötig, während die betroffenen GPUs brachliegen. NVIDIA argumentiert, dass mit wachsender Zahl und Größe der Jobs überlappende Ausfälle den Engineering-Aufwand und die verschwendeten GPU-Stunden erhöhen, was die Rechenkosten steigert und die Trainingszeit verlängert.
Als Beispiel für die Größenordnung nennt das Unternehmen: Läuft jede GPU mit einer Wahrscheinlichkeit von 99,9 Prozent einen Tag lang störungsfrei, schließt ein Job auf 10.000 GPUs diesen Tag nur mit einer Wahrscheinlichkeit von etwa 0,005 Prozent ohne Unterbrechung ab. Zudem verweist NVIDIA auf eine elfmonatige Studie zu 24.000 A100-GPUs bei Meta: Hardwareausfälle unterbrachen dort weniger als 1 Prozent der Jobs, auf diese entfielen aber 19 Prozent der GPU-Laufzeit.
Die vierstufige Wiederherstellungsschleife
NVIDIA Recovery erkennt Unterbrechungen anhand von Anwendungs-Logs, GPU-Metriken und Scheduler-Signalen. Die Schleife gliedert sich in vier Stufen, wobei die Maßnahmen von der Unterbrechung und der konfigurierten Richtlinie abhängen:
- Erkennen: Ein Anomaly Detector kombiniert Anwendungs-Logs und Scheduler-Signale, um Abstürze, Hänger und Nachzügler zu identifizieren. Er erkennt Fehler in PyTorch und NCCL, CUDA-Fehler und Ausfallmuster bei Interconnects.
- Zuordnen: Der Dienst klassifiziert die Unterbrechung anhand der gesammelten Belege. Eine optionale Integration mit NVIDIA Attribution liefert eine tiefere Diagnose, um Hardwarefehler, Probleme in der Systemsoftware und Anwendungsfehler zu unterscheiden.
- Isolieren: Betroffene Knoten werden von der weiteren Nutzung ausgeschlossen.
- Neustarten oder stoppen: Workloads werden gemäß Richtlinie neu gestartet oder angehalten.
Fehlende Fortschrittssignale oder erkannte Muster für Kommunikationshänger deuten auf mögliche Hänger hin, während ein anhaltender Durchsatzrückgang gegenüber einer jüngeren Baseline auf mögliche Nachzügler hinweist.
Ein dauerhaftes Audit-Protokoll hält jedes Erkennungsmuster, jede ergriffene Maßnahme, den Zeitstempel, die Workload-Kennung und das Ergebnis der Zuordnung fest. Eine Recovery Console bietet ein Live-Dashboard für Betreiber, das verschiedene Scheduler-Typen abdeckt.
Einordnung im NVIDIA-Stack und bei Slurm
NVIDIA positioniert Recovery als eigene Ebene für die Workload-Wiederherstellung im DSX-OS-Stack. Die Überwachung und Isolierung von Knoten hängt von der Orchestrierung des Clusters ab. Kubernetes-Deployments nutzen NVSentinel, um GPU-Gesundheitsmetriken und XID-Ereignisse zu überwachen sowie fehlerhafte Knoten zu sperren (Cordon) und zu leeren (Drain). Viele Slurm-Standorte prüfen den Zustand der Knoten mit eigenen Prolog- und Epilog-Skripten. Innerhalb einzelner Jobs übernimmt die Bibliothek NVRx die Wiederherstellung und Hang-Erkennung.
NVIDIA Recovery arbeitet auf Cluster-Ebene und steuert Job-Neustarts, Platzierung und Knotenausschluss über Workloads hinweg. Die Ebenen funktionieren unabhängig voneinander ohne feste Abhängigkeiten, sodass Standorte Komponenten einzeln einführen oder eigene einbinden können. Laut NVIDIA lässt sich Recovery in Clustern, die bereits NVSentinel oder NVIDIA Health Validation nutzen, mit wenigen oder gar keinen Änderungen an bestehenden Health-Workflows integrieren. Für NVRx-Nutzer deckt es den workloadübergreifenden Lebenszyklus ab, den ein Neustart innerhalb des Jobs nicht erreicht.
Für Slurm nutzt die Integration einen Referenz-Advisor-Controller, der sich per Helm-Chart entweder im Cluster oder im SSH-Modus bereitstellen lässt. So bleibt der Recovery-Dienst unabhängig von den internen Abläufen des Schedulers.
Produktionszahlen und Einstieg
NVIDIA berichtet, dass die Überwachung auf einem Trainingscluster vom 9. Juli bis 9. Oktober knapp 200 Jobs pro Tag abdeckte und rund 8.550 Anomalie-Erkennungen verzeichnete. Die mittlere Erkennungslatenz lag bei 69 Sekunden, die mittlere Latenz bis zur Wiederherstellungsmaßnahme bei 94 Sekunden. Das Unternehmen weist darauf hin, dass die Latenz der Wiederherstellungsmaßnahme mit der automatisierten Aktion endet; wann produktives Training tatsächlich wieder läuft, bestimmen daher Scheduling und Wiederherstellung des Checkpoints.
Neue Deployments starten standardmäßig im Monitor-Modus. In diesem Modus veröffentlicht der Dienst Empfehlungen zur Wiederherstellung, ohne Aktionen im Scheduler auszuführen. So können Betreiber die Signalqualität prüfen, bevor sie die autonome Wiederherstellung aktivieren.
Quellcode und Issue-Tracker finden Nutzer laut NVIDIA im Repository dsx-ai-factory/NVIDIA-Recovery. Eine Quickstart-Anleitung ermöglicht das lokale Deployment ohne physische GPU, ein Leitfaden für Betreiber behandelt Slurm-Setups im Cluster und per SSH.
Was das für Betreiber bedeutet
Für Teams, die viele Trainingsjobs betreiben, lautet das Versprechen: weniger Abhängigkeit von einzelnen Ingenieuren und individuellen Wiederherstellungslösungen, wenn sich Unterbrechungen häufen. Der Monitor-Modus als Standard erlaubt es Betreibern, die Einschätzungen des Dienstes an den eigenen Clustern zu testen, bevor sie die Kontrolle abgeben. NVIDIA zufolge eignet sich der Ansatz sowohl für kleine als auch für große verteilte Läufe: Viele kleine Jobs vervielfachen den Betriebsaufwand, bei großen Jobs betrifft jede Unterbrechung mehr GPUs.
NVIDIA Developer: Keep Distributed Training Running with Automated Workload Recovery