NVIDIA und UW: RFD4-Proteina entwirft Proteinsequenzen und -strukturen gemeinsam
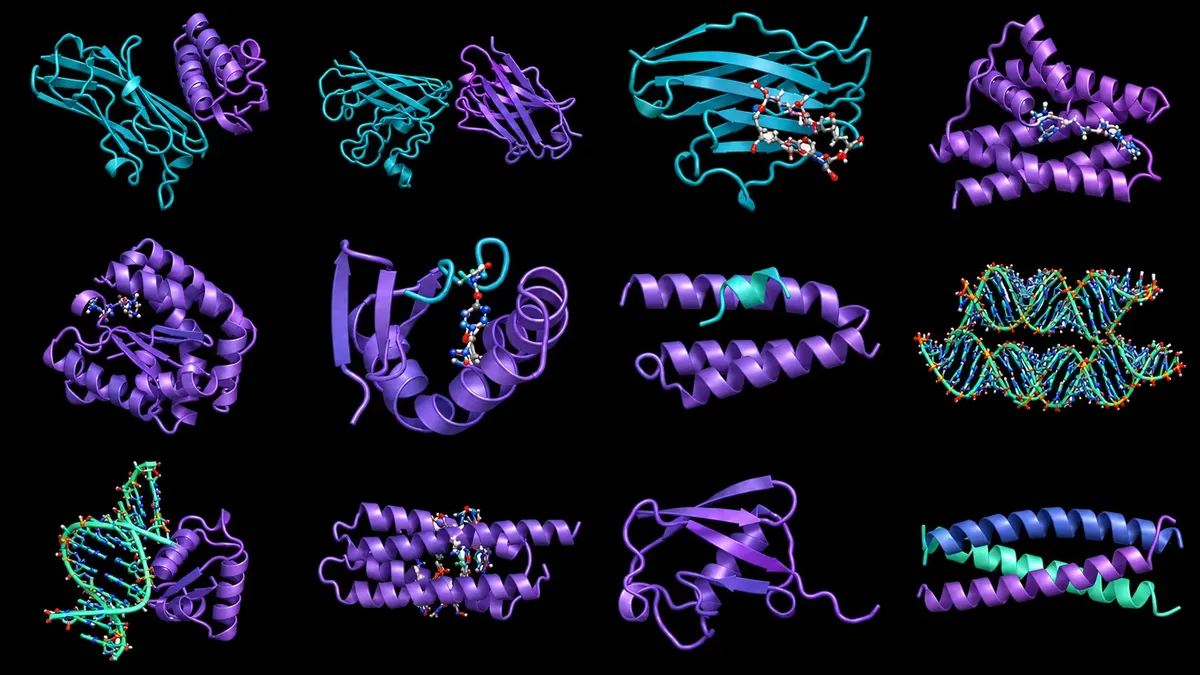
NVIDIA hat ein Tutorial zu RFD4-Proteina veröffentlicht, einem offenen BioNeMo-Modell, das Proteinsequenzen und All-Atom-Strukturen gemeinsam entwirft und per belohnungsgesteuerter Suche zur Inferenzzeit die Rechenleistung auf vielversprechende Kandidaten konzentriert. Laut NVIDIA generiert es bei 200 Residuen 3,8-mal schneller als RFD3 und benötigt 84 Prozent weniger Spitzenspeicher.
- RFD4-Proteina ist ein offenes BioNeMo-Modell von NVIDIA, das gemeinsam mit dem Institute for Protein Design der University of Washington entwickelt wurde.
- Es entwirft Proteinsequenzen und All-Atom-Strukturen gemeinsam und macht den separaten Inverse-Folding-Schritt überflüssig.
- Laut NVIDIA ist es bei 200 Residuen 3,8-mal schneller als RFD3 und braucht 84 Prozent weniger Spitzenspeicher.
- Das Sampling sinkt von etwa 400 Schritten in Proteina-Complexa auf 60.
- Verfügbar als offenes Modell auf GitHub und als NIM-Microservice mit HTTP-Schnittstelle.
Ein Suchproblem mit zu vielen Antworten
NVIDIA beschreibt Proteindesign als Suchproblem. Schon eine Sequenz aus acht Residuen erlaubt mehr als 25 Milliarden Aminosäurekombinationen, und bei 100 Residuen übersteigt die Zahl der Möglichkeiten die Zahl der Atome im beobachtbaren Universum. Da eine erschöpfende Suche unmöglich ist, hängt der Erfolg davon ab, zu wissen, wo man suchen muss.
RFD4-Proteina wurde gemeinsam mit dem Institute for Protein Design an der School of Medicine der University of Washington entwickelt. Das Modell navigiert in diesem Raum anhand von Mustern, die aus der Natur gelernt wurden. Das Tutorial richtet sich an Computational Biologists, ML-Ingenieure und Forschende in der Wirkstoffentwicklung und führt durch den Entwurf von Protein-Binder-Kandidaten gegen PD-L1, ein Ziel in der Onkologie.
Aufbauend auf dem teilweise latenten Ansatz von Proteina-Complexa kombiniert das Modell explizite Backbone-Koordinaten mit latenter Repräsentation sowie gelernten Sequenz- und atomistischen Variablen. Der Decoder des Autoencoders erzeugt Sequenz und All-Atom-Struktur gemeinsam. Damit entfällt die separate Übergabe an ein Inverse-Folding-Modell wie ProteinMPNN.
Suche zur Inferenzzeit und die Geschwindigkeitsgewinne
Das zentrale Merkmal ist die belohnungsgesteuerte Suche. Bei der Suche zur Inferenzzeit entrauscht das Modell Generierungspfade, um Strukturen zu erhalten, bewertet diese, behält vielversprechende Teilzustände bei und verzweigt sie, bis die Generierungskriterien erfüllt sind. Belohnungen können Geometrie, Wechselwirkungen oder die Konfidenz einer unabhängigen Vorhersage messen. Laut NVIDIA optimiert diese zusätzliche Suche die Entwürfe auf ein vorgegebenes Ziel hin und liefert Designs mit höherer Bewertung.
Die Effizienzgewinne gegenüber RFD3 führt NVIDIA auf mehrere Entscheidungen zurück:
- Eine latente Repräsentation auf Residuenebene statt auf Atomebene, wodurch ein explosionsartiger Speicheranstieg vermieden wird.
- Eine technische Überarbeitung des Diffusionsprozesses, die das Sampling von etwa 400 Schritten in Proteina-Complexa auf 60 reduziert.
- CUDA-beschleunigte Oracles für die Suche, darunter OF3 und physikalische Methoden wie tmol.
Modell und Kernels wurden gemeinsam mit den Teams von cuEquivariance und BioNeMo Inference Runtime auf Geschwindigkeit und Skalierbarkeit hin entwickelt. Im berichteten Generierungs-Benchmark bei 200 Residuen liefert das Modell nach Angaben des Unternehmens eine 3,8-mal schnellere Generierung und einen um 84 Prozent geringeren reservierten Spitzenspeicher als RFD3.
Der PD-L1-Workflow und die Zugriffsmöglichkeiten
Nutzer können RFD4-Proteina auf zwei Wegen verwenden. Das offene Modell, verfügbar auf GitHub, ist für Training, Inferenz, Methodenentwicklung und direkte Kontrolle über den Sampling-Code gedacht. Der NIM-Microservice dient dem schnellen Inferenz-Deployment über eine HTTP-Schnittstelle. Das NIM lässt sich auf x86_64- oder arm64-Linux mit Docker, einem NVIDIA-Treiber, dem NVIDIA Container Toolkit und einem NGC-API-Schlüssel selbst hosten. Ein API-Endpunkt auf build.nvidia.com benötigt weder eine lokale GPU noch eine Modellinstallation, wird von NVIDIA für Produktionsläufe jedoch nicht empfohlen.
Der Workflow beginnt damit, festzulegen, was sich ändern darf, was fest bleiben muss und welche rechnerischen und experimentellen Erfolgskriterien gelten. AtomWorks, die molekulare Datenschicht, bereitet feste Atome, gestaltbare Residuen, Hotspots und den molekularen Kontext vor. Sowohl das offene Modell als auch das NIM akzeptieren annotierte CIF-Dateien oder eine Bedingungsspezifikation samt zugehöriger Ausgangsstruktur.
Im Beispiel dient die zugeschnittene PD-L1-Struktur aus dem Repository (PDB 5O45) als Ziel. Ihre Sequenz und Backbone-Koordinaten sind fixiert, die Seitenketten dürfen neu gepackt werden, und die Generierung wird auf Hotspot-Atome an Tyr56, Met115 und Tyr123 ausgerichtet. Der neue Binder umfasst 100 bis 150 Residuen mit freier Sequenz und freien Koordinaten.
Agentengesteuerte Designkampagnen
NVIDIA beschreibt den Referenz-Workflow als iterativen Zyklus, der molekulares Design, rechnerische Bewertung und experimentelle Tests verbindet. Ein Agent kann die Werkzeuge koordinieren und Ergebnisse nachverfolgen, während Wissenschaftlerinnen und Wissenschaftler die Ziele definieren und experimentelle Befunde nutzen, um die nächste Runde zu steuern. Die Skills rfd4-proteina-campaign und rfd4-proteina-package im BioNeMo Agent Toolkit übernehmen Generierung, Suche, Bewertung und Archivierung der Ergebnisse.
Für Forschungsteams lautet das Versprechen: geringerer Speicherbedarf und schnelleres Sampling sowie ein einziges Modell, das Sequenz und Struktur ohne separaten Inverse-Folding-Schritt ausgibt. Die offene Veröffentlichung gibt Gruppen zudem direkten Zugriff auf den Sampling-Code.
NVIDIA Developer: Design Proteins with RFD4-Proteina Using Reward-Guided Inference-Time Search