Ollama führt Entscheidungsmodelle für schnelle, typisierte Antworten auf dem lokalen Rechner ein
Ollama unterstützt jetzt Entscheidungsmodelle auf Basis der Jev-API von TypeSafe. Ein Modell, das auf dem eigenen Rechner läuft, beantwortet damit in einer einzigen Anfrage mehrere benannte Fragen zu einem Text. Die Funktion kommt mit Ollama 0.35 und einem neuen Endpunkt namens /v1/systemone.
- Ollama 0.35 bringt den Endpunkt /v1/systemone für Entscheidungsmodelle auf Basis der Jev-API von TypeSafe.
- Eine Anfrage kann mehrere benannte Fragen unterschiedlicher Typen wie Choice, Noul und Score enthalten.
- Nimble 9B benötigte laut Ollama in einem Pac-Man-Beispiel auf einem M5 Max im Schnitt 91 ms pro Entscheidung.
- Drei Modelle sind verfügbar: nimble (9B), tev1 (4B) und tev1:0.8b (0,8B).
- Ollama plant MLX-basierte Beschleunigung auf Apple Silicon und weitere spezialisierte Modelle.
So funktioniert die neue API
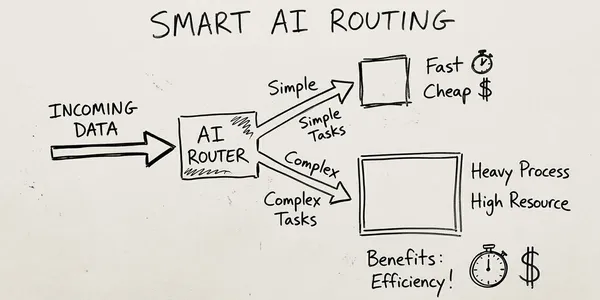
Laut Ollama ist die neue API für Aufgaben gedacht, die schnelle, strukturierte Entscheidungen erfordern, etwa die Triage von Tickets, das Routing von Modellen sowie die Moderation von Inhalten und Sicherheitsaspekten. Entwickler senden Text als State zusammen mit einer Reihe benannter Fragen, und das Modell beantwortet alle in einer Anfrage.
Die Fragen gibt es in mehreren Typen. Im Beispiel von Ollama lautet ein Support-Ticket: „I was charged twice. Please refund the extra payment.“ Daran hängen drei Fragen: welches Team das Ticket bearbeiten soll (eine Choice-Frage mit den Optionen billing, technical und other), ob der Kunde ausdrücklich eine Rückerstattung verlangt (eine Noul-Frage) und wie dringend das Ticket ist (eine Score-Frage mit den Stufen Routine, Soon und Urgent).
Die Antwort ist typisiert. Bei der Teamfrage lieferte das Modell die Auswahl „billing“ mit Wahrscheinlichkeiten von 0,985 für billing, 0,012 für technical und 0,003 für other sowie einem Konfidenzwert von 0,922. Die Rückerstattungsfrage ergab einen Noul-Wert von 0,997, die Dringlichkeitsfrage einen Score von 0,815. Das Feld usage wies im Beispiel 841 Eingabe-Token und 4 Ausgabe-Token aus.
Geschwindigkeit und verfügbare Modelle
Als Hauptvorteile nennt Ollama wegfallende Zusatzkosten und eine geringere Latenz, wenn Modelle lokal laufen, da Anfragen nicht über ein Netzwerk müssen. Als Beispiel gibt das Unternehmen an, dass Nimble 9B in einer Pac-Man-Demo auf einem MacBook Pro mit M5 Max im Schnitt 91 ms pro Entscheidung benötigte. Ollama bezeichnet das als schnell genug für rasche Entscheidungen, etwa beim Spielen oder bei der Verarbeitung von Inhalten in Echtzeit.
Derzeit sind drei Entscheidungsmodelle verfügbar:
- nimble: ein quelloffenes Entscheidungsmodell mit 9 Milliarden Parametern von Bespoke Labs
- tev1: ein experimentelles Entscheidungsmodell mit 4 Milliarden Parametern von Together AI
- tev1:0.8b: ein experimentelles Entscheidungsmodell mit 0,8 Milliarden Parametern von Together AI
Ollama kündigt außerdem weitere Entscheidungsmodelle an, darunter solche, die über die Cloud von Ollama bereitgestellt werden.
Das Unternehmen veröffentlichte ein Benchmark-Diagramm auf Basis der öffentlichen Benchmarks von Bespoke Labs. Es misst die mittlere Genauigkeit über 13 öffentliche Datensätze mit menschlichen Labels und umfasst 3.880 Entscheidungen. Nimble und Tev1 wurden auf Ollama ausgewertet, der Wert für Jev 1.13 stammt aus dem veröffentlichten Lauf von Bespoke Labs mit denselben Entscheidungen. Details verlinkt Ollama in seinen Evaluierungsergebnissen und der Benchmark-Suite.
Erste Schritte und Ausblick
Nutzer müssen die neueste Version von Ollama herunterladen oder aktualisieren und anschließend ein Modell laden, zum Beispiel mit ollama pull nimble. Anfragen lassen sich per curl an den lokalen Endpunkt /v1/systemone senden oder über das offizielle Python-SDK von TypeSafe, das als typesafe-sdk installiert wird. Das SDK wird über Umgebungsvariablen für die Basis-URL (http://localhost:11434), einen API-Schlüssel und ein Standardmodell konfiguriert.
Im Python-Beispiel definieren Entwickler Fragen mit den Klassen Choice, Noul und Score und rufen die Methode system_one des Clients auf. Die Ergebnisse lassen sich dann aus typisierten Feldern auslesen, etwa dem gewählten Team, dem Rückerstattungswert und dem Dringlichkeits-Score.
Ollama bezeichnet dies als die erste von vielen Veröffentlichungen, die Entscheidungsmodelle unterstützen. Zu den geplanten Updates gehören schnellere Leistung auf Apple Silicon dank MLX sowie weitere Modelle, die auf unterschiedliche Arten der Entscheidungsfindung spezialisiert sind.
Für Entwickler bietet die Veröffentlichung laut Ollama die Möglichkeit, Klassifizierungs- und Routing-Schritte lokal mit strukturierten Ausgaben und ohne Kosten pro Anfrage auszuführen. Wie die Modelle bei der Genauigkeit abschneiden, legt das Unternehmen in seinen Benchmark-Unterlagen dar.
Ollama: Ollama now supports Jev-style decision models