OpenRouter startet Extractions API für typisierte Daten aus Dokumenten
OpenRouter hat die Extractions API als Alpha-Version gestartet. Sie ermöglicht Entwicklern, benannte und typisierte Felder aus Texten, Bildern und PDFs auszulesen. Der Dienst liefert strukturierte Werte wie Namen, Daten und Summen sowie Metadaten, mit denen sich das Ergebnis bewerten lässt.
- OpenRouters Extractions API ist als Alpha-Version verfügbar.
- Sie extrahiert typisierte Felder aus Texten, Bildern und PDFs.
- Die API unterstützt neun Feldtypen, darunter Schätzungen und Prognosen.
- Ergebnisse können Belegstellen, Konfidenzwerte und p_null-Werte enthalten.
- Zum Start sind Modelle von Cloudflare, Inception und ScaleDown verfügbar.
Dokumentenextraktion anhand von Feldern
Die API ermöglicht es Entwicklern, die aus einem Dokument benötigten Felder zu beschreiben, und liefert anschließend für jedes Feld einen typisierten Wert zurück. Die Anfrage enthält das Dokument in state sowie eine Reihe benannter Felder. Jedes Feld hat einen Typ und kann optional durch Anweisungen ergänzt werden, die seine Bedeutung erklären.
Nach Angaben von OpenRouter unterstützt die API neun Feldtypen: Text, Zahl, Datum, Uhrzeit, Datum und Uhrzeit, Liste, Dauer, Schätzung und Prognose. Die Werte werden als JSON-Typen zurückgegeben und können ohne zusätzliche Verarbeitung gespeichert werden. Eine Liste kann beispielsweise Texte, Zahlen oder Daten enthalten, während eine Dauer eine Einheit von Sekunden bis Jahren verwenden kann.
Zum Start umfasst das Angebot Extraktionsmodelle von Cloudflare, Inception und ScaleDown. Entwickler können über die Dokumentation auf die API zugreifen oder sie im Playground von OpenRouter testen.
Belege, Konfidenz und Unsicherheit als Teil der Ausgabe
Im Beispiel verarbeitet das Modell Clairic von Cloudflare eine Rechnung. Es extrahiert die Rechnungsnummer INV-4417, einen Gesamtbetrag von 3850, die Kontakte Dana Ruiz und Priya Shah sowie ein berechnetes Fälligkeitsdatum von 2026-11-28. Das Fälligkeitsdatum steht nicht direkt auf der Rechnung. Clairic berechnet es anhand des Ausstellungsdatums 2026-10-14 und der Zahlungsbedingungen Net 45.
Textwerte können Spans enthalten, die angeben, an welcher Stelle die Antwort in der Quelle vorkommt. Entwickler können diese Spans nutzen, um neben jedem Ergebnis die entsprechenden Belege anzuzeigen. Einzelne Werte enthalten außerdem die Konfidenz und p_null, die Schätzung des Modells, dass das Dokument für das angefragte Feld keinen Wert enthält. Ein Feld wird zu null, sobald sein p_null den konfigurierten Schwellenwert überschreitet. Eine separate Vermutung zeigt, welchen Wert das Modell ansonsten ausgewählt hätte.
Für die geschätzte Zahlungsdauer der Rechnung liefert Clairic statt einer einzelnen Gewissheit eine Verteilung. Das Ergebnis hat einen Median von 45 Tagen, p10 liegt bei 42 und p90 bei 47. Das bedeutet, dass das Intervall 80 % der in diesem Beispiel beschriebenen Verteilungsmasse umfasst.
Unterstützung für Bilder und PDFs
Bilder werden über assets bereitgestellt, durch einen Schlüssel in state referenziert und verwenden dieselben Felddefinitionen wie die Textextraktion. Bildergebnisse können angeben, dass Werte aus dem Bild stammen, und für aus dem Bild gelesenen Text spell_confidence enthalten.
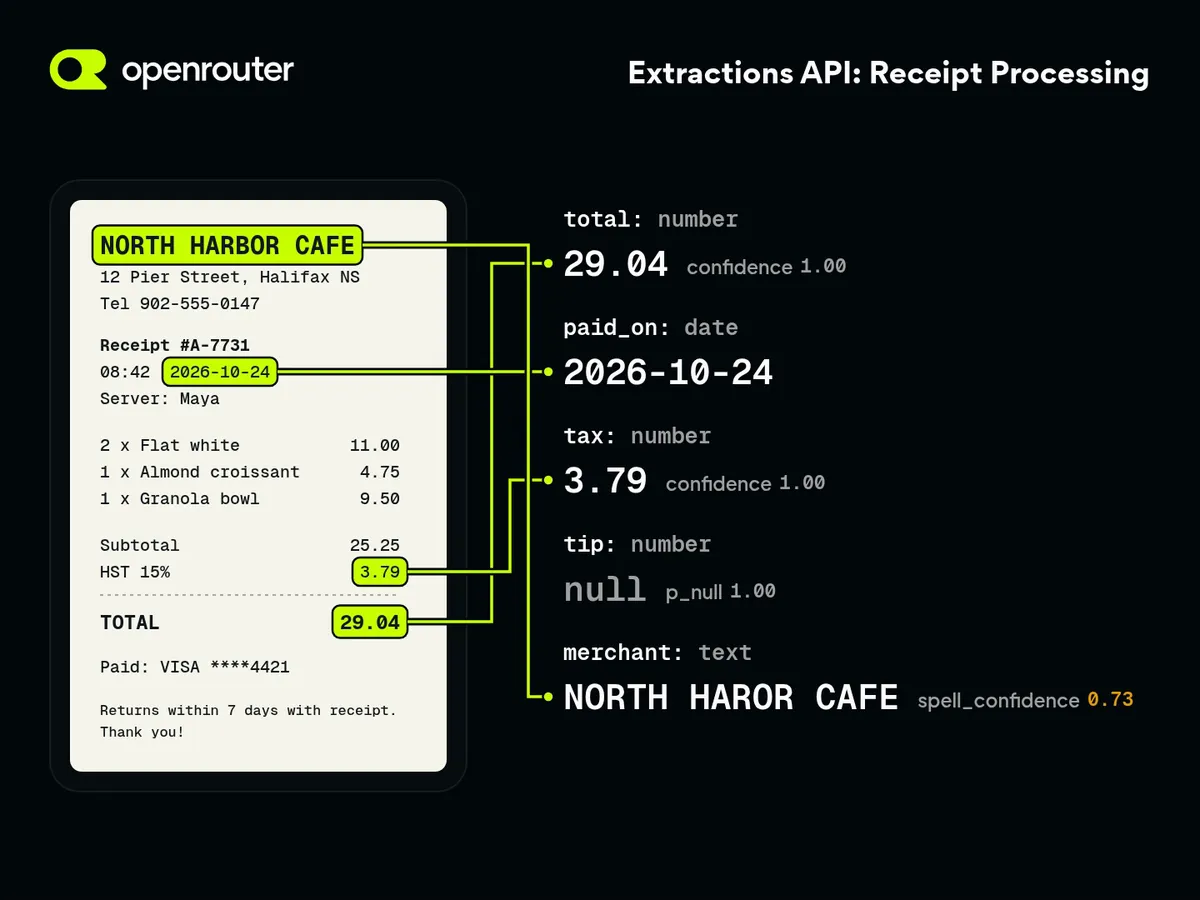
In einem Beispiel mit dem Bild eines Kassenbons lieferte Clairic einen Händlerwert, einen Gesamtbetrag von 29.04, ein Zahlungsdatum von 2026-10-24 und eine Steuer von 3.79. OpenRouter zufolge gibt die API Werte statt Bildkoordinaten zurück. Die in der Demonstration gezeigten Rahmen sind daher nicht Teil der API-Ausgabe.
Das Unternehmen beschreibt diese Konfidenz- und Belegfelder als Vertrauensmodell. Entwickler können eine Konfidenzuntergrenze festlegen, Ergebnisse mit geringerer Konfidenz an eine Person weiterleiten und die übrigen Ergebnisse speichern. Die Alpha-Version ermöglicht es, Dokumenten-Workflows rund um strukturierte Extraktion aufzubauen und zugleich Hinweise auf Belege, fehlende Felder und Unsicherheiten zu bewahren.
OpenRouter: Introducing the Extractions API