PostgreSQL 19 erreicht Lakebase am Tag der Veröffentlichung
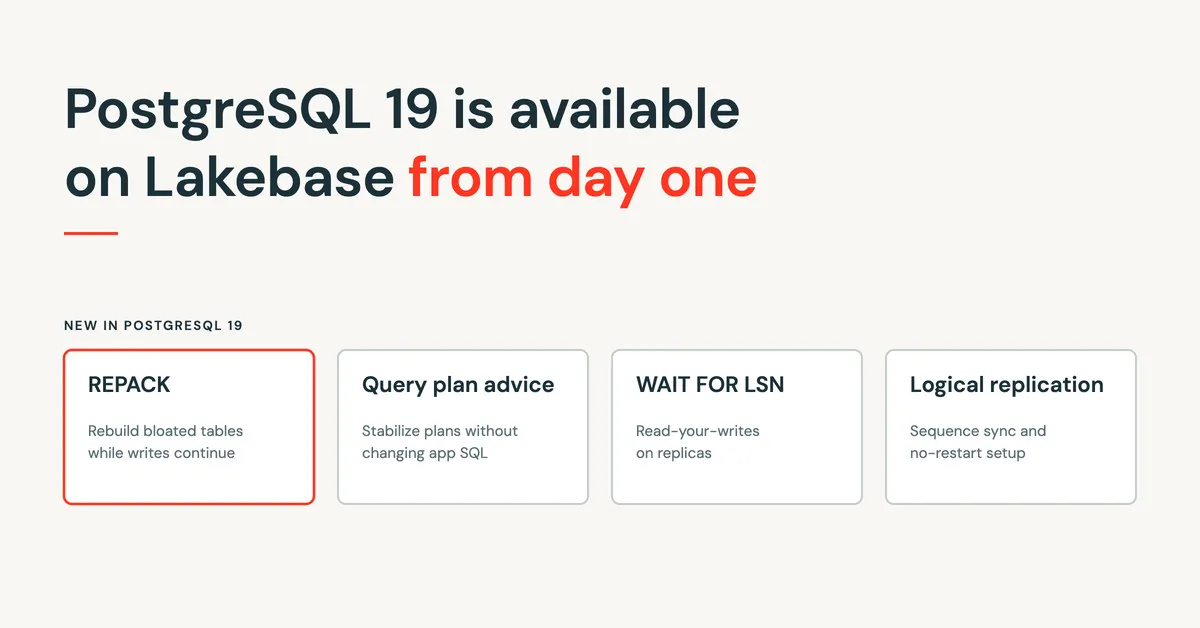
PostgreSQL 19 ist ab dem Tag seiner allgemeinen Verfügbarkeit auf Databricks’ Lakebase verfügbar. Kunden können die Version testen, indem sie ein neues Lakebase-Projekt erstellen und PostgreSQL 19 auswählen.
- PostgreSQL 19 ist ab der allgemeinen Verfügbarkeit auf Lakebase verfügbar.
- REPACK kann Speicherplatz zurückgewinnen, während Lese- und Schreibvorgänge während des größten Teils der Operation fortgesetzt werden.
- pg_plan_advice und pg_stash_advice bieten Werkzeuge zur Stabilisierung von Abfrageplänen.
- PostgreSQL 19 verbessert Autovacuum, Diagnosen und die logische Replikation.
- Nutzer können PostgreSQL 19 beim Erstellen eines neuen Lakebase-Projekts auswählen.
Eine Version mit Fokus auf operative Kontrolle
Laut Databricks zielt PostgreSQL 19 auf alltägliche Probleme von Datenbankteams, darunter aufgeblähte Tabellen, instabile Abfragepläne, Verzögerungen bei Replikaten, unvollständige Statistiken und Wartungsarbeiten, die sich in Produktionsumgebungen nur schwer sicher durchführen lassen.
Die Version konzentriert sich nicht auf ein einzelnes Feature, das das grundlegende Design von PostgreSQL verändert. Stattdessen bietet sie Teams mehr Möglichkeiten, einzugreifen, wenn das Standardverhalten nicht ausreicht, und behält dabei den Fokus des Projekts auf Zuverlässigkeit und vorhersehbarem Verhalten bei.
Databricks erklärte, dass mehrere Lakebase-Ingenieure PostgreSQL-Committer und -Beitragende sind, die direkt an der Version gearbeitet haben. Ihre Arbeit umfasste unter anderem Empfehlungen für Abfragepläne, den Shared Memory, die Verarbeitung von Gebietsschemata und das Release-Management.
REPACK verringert den Bedarf an Wartungsdowntime
PostgreSQL 19 führt REPACK ein. Damit lässt sich Tabellenplatz zurückgewinnen, während normale Lese- und Schreibvorgänge während des größten Teils der Operation fortgesetzt werden. Das Feature begegnet der Aufblähung, die entstehen kann, wenn Aktualisierungen neue Zeilenversionen erzeugen und Löschvorgänge verwaiste Tupel zurücklassen.
Mit USING INDEX kann REPACK Zeilen außerdem physisch wie bei CLUSTER anordnen. Mit CONCURRENTLY erstellt PostgreSQL eine Tabelle neu, während laufende Änderungen über Logical Decoding erfasst werden. Anschließend werden die verbleibenden Änderungen angewendet und die Dateien der neuen Tabelle und des neuen Index an ihrer Stelle eingesetzt. Für diese letzte Phase wird eine ACCESS EXCLUSIVE-Sperre verwendet.
Databricks weist darauf hin, dass gleichzeitiges Repacking zusätzliche Kapazität für Replikations-Slots, vorübergehend benötigten Speicherplatz und einen geeigneten Primärschlüssel oder eine Replica Identity voraussetzt. Lang laufende Transaktionen können die abschließende Sperre verzögern, und bei Tabellen mit vielen Aktualisierungen und Löschvorgängen bestehen Einschränkungen. Auch die physische Clusterung kann sich durch spätere Schreibvorgänge verschlechtern.
Empfehlungen für Abfragepläne, Diagnosen und Neuerungen bei der Replikation
Mit den beiden neuen Komponenten pg_plan_advice und pg_stash_advice können Administratoren Entscheidungen des Planers untersuchen, gezielte Empfehlungen anwenden und diese nach Abfrage-ID speichern. Databricks sieht darin eine Möglichkeit, eine kritische Abfrage zu stabilisieren, nachdem eine ungenaue Schätzung zu einem schlechten Ausführungsplan geführt hat. Die Empfehlungen ersetzen den Planer nicht und belegen auch nicht, dass der daraus resultierende Plan besser ist. Teams müssen ihn daher weiterhin anhand ihrer Workloads bewerten.
Zu den weiteren operativen Änderungen gehören parallele Worker für die Index-Bereinigung, ein Bewertungssystem zur Priorisierung von Autovacuum-Aufgaben sowie neue Ansichten zu Sperren, Recovery und Autovacuum-Bewertungen. EXPLAIN kann Aktivitäten der asynchronen Ein-/Ausgabe melden. Zusätzliche WAL-Informationen sind über Statistiken, Ausführungspläne und Wartungsprotokolle verfügbar.
Auch die logische Replikation erhält mehrere neue Funktionen. Logical Decoding kann ohne Neustart aktiviert werden, wenn wal_level auf replica gesetzt ist. Sequenzwerte lassen sich zwischen Publishern und Subscribern synchronisieren, und Publications können alle Sequenzen einschließen oder bestimmte Tabellen ausschließen. Änderungen an Subscriptions umfassen die Wiederverwendung von Verbindungsdaten eines postgres_fdw-Servers sowie Optionen zur Erkennung bestimmter Konflikte zwischen Aktualisierungen und Löschvorgängen.
Für Lakebase-Nutzer bedeutet dies vor allem den sofortigen Zugriff auf diese Funktionen von PostgreSQL 19. Databricks erklärte, dass wichtige PostgreSQL-Versionen andere verwaltete PostgreSQL-Dienste erst nach mehreren Wochen erreichen können, während Lakebase-Kunden die Version beim Erstellen eines neuen Projekts auswählen können.
Databricks: PostgreSQL 19 is available on Lakebase