Pure KVA hält KI-Agenten schnell, indem es verdrängte KV-Caches sichert, so Pure Storage
Pure Storage zufolge hält der Pure Key-Value Accelerator (KVA) KI-Agenten reaktionsschnell, indem er verdrängte KV-Caches im Hostspeicher und auf NFS-Storage ablegt, statt sie zu verwerfen. In einem unternehmenseigenen Lasttest mit 40 Agenten an einem Gemma-4-26B-Endpunkt blieb die mediane Wartezeit für einen wiederkehrenden Turn zwischen 0,11 und 0,30 Sekunden, während dasselbe Setup ohne KVA auf rund 45 Sekunden einbrach.
- Pure Storage zufolge legt Pure KVA verdrängte KV-Caches im Hostspeicher und auf NFS-Storage ab, S3-Objektspeicher wird ebenfalls unterstützt, und das Produkt ist ab sofort verfügbar.
- In einem Test mit 40 Agenten an einem Gemma-4-26B-Endpunkt blieb die mediane Wartezeit für wiederkehrende Turns mit KVA zwischen 0,11 und 0,30 Sekunden.
- Ohne KVA sprang der Median bei etwa 22 Agenten auf 17 Sekunden und erreichte bis zum Ende des 750-Sekunden-Laufs rund 45 Sekunden.
- Pure zufolge war eine NFS-Wiederherstellung in den Tests bis zu 32-mal schneller als ein Wiederaufbau.
- Um die Latenz von KVA ohne zweite Ebene zu erreichen, wäre laut Pure etwa das 1,8-Fache an GPU-Speicher nötig.
Warum Agenten Inferenzserver unter Druck setzen
Pure Storage argumentiert in einem Blogbeitrag, Chatbots liefen in menschlicher Zeit, Agenten dagegen in Computerzeit. Ein Mensch braucht Sekunden oder Minuten für eine Antwort, was die Kosten für den Wiederaufbau des Caches einer Unterhaltung verdeckt. Ein Agent liest Dokumente, ruft ein Tool auf, liest das Ergebnis und sendet seinen nächsten Turn binnen Sekunden, und das dutzendfach pro Aufgabe.
Laut Unternehmen kann ein Wiederaufbau, der bei einem Chatbot kaum ins Gewicht fällt, bei einer Agentenaufgabe mit 60 Turns zu mehr als zwei Minuten Wartezeit summieren. Die Ursache ist der knappe GPU-Speicher. Ein Inferenzserver im Unternehmenseinsatz bedient auf einem einzigen Knoten unter Umständen Dutzende oder Hunderte Unterhaltungen gleichzeitig, und der GPU-Speicher kann die KV-Caches aller nicht fassen. Ist der Speicher voll, verdrängt die Engine die Caches der gerade nicht aktiven Unterhaltungen, beginnend mit den am längsten nicht genutzten. Kehrt ein verdrängter Agent zurück, muss sein Cache von Grund auf neu aufgebaut werden.
Pure zufolge sind Wiederaufbauten bei einer Handvoll Agenten selten, bei einigen Dutzend fallen sie dagegen bei fast jedem Turn an, und die Verzögerung wirkt sich auf jeden Agenten auf dem Server aus.
So funktioniert Pure KVA
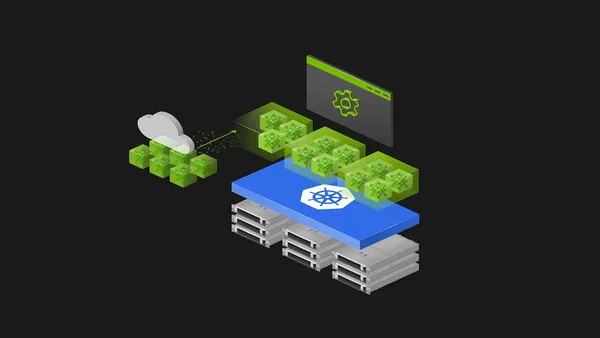
Pure KVA ist ein KV-Cache-Backend für Inferenz-Engines. Es besteht aus einem Plugin in der Engine, einem Dienst, der daneben läuft, und Enterprise-Storage darunter. Laut Pure ist es ab sofort verfügbar. Es verwaltet den Cache jeder Unterhaltung über drei Ebenen:
- GPU-HBM: der Speicher mit hoher Bandbreite im GPU-Package, in dem die Unterhaltungen liegen, die die Engine gerade aktiv bedient. Ein Cache, der hier liegt, muss nicht neu aufgebaut werden.
- Hostspeicher: DRAM im selben Server, in dem verdrängte Caches einen Hop von der GPU entfernt liegen und so die schnellsten Wiederherstellungen ermöglichen.
- NFS-Storage: weit größer als der Speicher eines einzelnen Servers und über die gesamte Flotte geteilt, sodass ein auf einem Knoten geschriebener Cache auf einem anderen wiederhergestellt werden kann. Pure KVA unterstützt außerdem S3-Objektspeicher.
Auch mit Pure KVA findet weiterhin Verdrängung statt, und der HBM bleibt gleich groß. Verändert werden die Kosten der Rückkehr: Der Cache wird aus dem Hostspeicher oder dem Storage gelesen, statt auf der GPU neu aufgebaut zu werden. In Pures Tests war eine Wiederherstellung von NFS bis zu 32-mal schneller als ein Wiederaufbau und erzeugte keine zusätzliche Rebuild-Last in der Warteschlange der GPU.
Der Lasttest mit 40 Agenten
Pure baute einen Test, bei dem alle 15 Sekunden ein neuer Agent an einem einzelnen Gemma-4-26B-Endpunkt hinzukommt. Kein Agent scheidet aus, sodass nach 10 Minuten alle 40 gleichzeitig laufen. Jeder Agent lädt im ersten Turn 10 Dokumente, was einen Start-Prompt von 22.000 bis 33.000 Tokens ergibt, wartet dann etwa 15 Sekunden zwischen den Turns und sendet jedes Mal die gesamte Unterhaltung erneut. Das Unternehmen führte denselben Plan zweimal mit demselben Zufalls-Seed aus, einmal auf vLLM mit Pure KVA und einmal auf derselben Engine ohne. Jeder Durchlauf dauerte 750 Sekunden.
Die ersten Turns waren in beiden Läufen ähnlich, mit einem Median von 2,1 Sekunden mit Pure KVA und 2,3 Sekunden ohne, da in beiden Fällen kein Cache zur Wiederverwendung existiert. In den ersten fünfeinhalb Minuten waren auch die wiederkehrenden Turns nicht zu unterscheiden, bei etwa 0,1 Sekunden, weil noch jede Unterhaltung in den HBM passte.
Dann änderte sich der Lauf ohne KVA schlagartig. Bei 5,6 Minuten, mit etwa 22 laufenden Agenten, wurde sein letzter wiederkehrender Turn in unter einer halben Sekunde beantwortet. Dreißig Sekunden später lag die mediane Wartezeit bei 17 Sekunden, länger als die eigene 15-Sekunden-Pause der Agenten. Nach acht Minuten waren es 31 Sekunden, zum Ende rund 45 Sekunden, und eine Erholung blieb aus.
Mit Pure KVA blieb der Median zwischen 0,11 und 0,30 Sekunden, sobald die ersten Agenten ihre Eröffnungsturns hinter sich hatten. Der einzige Anstieg auf 0,30 Sekunden kam bei der 10-Minuten-Marke, als die letzten Agenten eintrafen, und nach weniger als einer Minute lag der Wert wieder bei 0,12 Sekunden. Der langsamste Turn im Lauf mit Pure KVA dauerte 4,6 Sekunden und war ein erster Turn.
Pure sagt, das Wachstum der Prompts sei nicht die Ursache gewesen: Die Eingaben blieben durchgehend zwischen 21.800 und 34.100 Tokens. Der Sprung gehe ausschließlich darauf zurück, dass der HBM keinen Platz mehr hatte, woraufhin jeder zurückkehrende Agent einen Wiederaufbau brauchte und sich die Wiederaufbauten schneller aufstauten, als die GPU sie abarbeiten konnte.
Was das für Teams bedeutet, die Agenten betreiben
Pure verweist auf die Plötzlichkeit des Einbruchs als Risiko. Ein Deployment, das mit 15 Agenten perfekt aussehe, könne bei 40 mehr als 100-mal langsamer laufen, weshalb ein kleiner Pilot in die Irre führen könne. Außerdem weist das Unternehmen darauf hin, dass die GPU bei Wiederaufbauten Caches neu berechnet, die sie bereits hatte, und dass langsamere Antworten weniger Turns und weniger nützliche Tokens bedeuten, weil Agenten auf jede Antwort warten, bevor sie den nächsten Turn senden.
Bei den Kosten schätzt das Unternehmen, dass man ohne zweite Cache-Ebene etwa das 1,8-Fache an GPU-Speicher bräuchte, um die Latenz von Pure KVA zu erreichen, was in der Praxis nach seinen Angaben fast doppelt so viele GPUs bedeute. Diese Zahlen stammen aus Pures eigenem Test mit einem einzelnen Modell und Endpunkt, die Ergebnisse anderer Setups können daher abweichen.
Pure Storage: The Agent Snowball Effect: How Pure KVA Keeps Long-Running Agents Fast