Roboflow: NVIDIA Cosmos 3 Edge lässt sich mit eigenen Videos feintunen
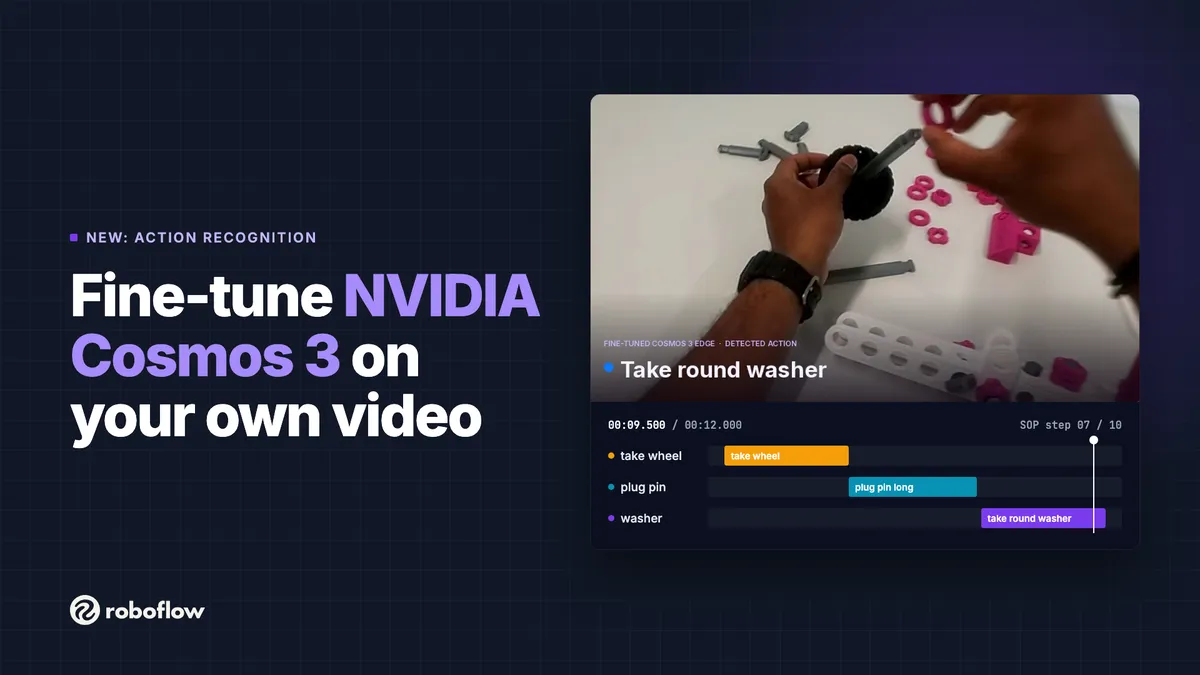
Roboflow ermöglicht es Nutzern jetzt, NVIDIA Cosmos 3 Edge mit eigenen Videodaten feinzutunen. Der neue Projekttyp Action Recognition liefert für jeden neuen Clip eine Zeitleiste der erkannten Handlungen, sodass Teams prüfen können, ob Mitarbeitende ein Verfahren eingehalten haben.
- Roboflow unterstützt jetzt das Feintuning von NVIDIA Cosmos 3 Edge mit eigenen Videos über den neuen Projekttyp Action Recognition.
- Nutzer labeln Zeitbereiche auf einer Zeitleiste, und das trainierte Modell liefert für neue Clips eine Zeitleiste der Handlungen.
- Laut Roboflow genügen für den Start einige Dutzend kurze Videos.
- Die Standardwerte sind 64 Frames pro Fenster, 4 fps und 360p, was Fenstern von 16 Sekunden entspricht.
- Die Modelle laufen über die Serverless Cloud API, das Basismodell Cosmos 3 Edge steht zudem in Workflows bereit.
Was Action Recognition leistet
Laut Roboflow kann Cosmos 3 Edge physische Szenen bereits ohne Anpassung gut einordnen. Ein allgemeines Modell kenne jedoch weder eine konkrete Fertigungslinie noch deren Teile oder die Reihenfolge, in der Bedienpersonal arbeiten soll. Das Feintuning soll dem Modell genau diese Handlungen beibringen.
Action Recognition bedeutet, in einem Video zu erkennen, welche Handlungen wann stattfinden. Ein angepasstes Modell könne Fragen beantworten wie: Hat eine Person alle Schritte eines Montageablaufs in der richtigen Reihenfolge abgeschlossen? Wie lange dauert jeder Schritt? Wo verlangsamen sich Zyklen? Wurde ein Schritt ausgelassen, wiederholt oder in falscher Reihenfolge ausgeführt?
Zur Demonstration hat Roboflow ein Modell mit Aufnahmen trainiert, in denen Personen ein Spielzeugauto zusammenbauen. Verwendet wurde der Datensatz IndustReal (Schoonbeek et al., WACV 2024, Apache-2.0, modifiziert). Für jeden neuen Clip markiert das Modell, welcher der 10 Montageschritte wann stattfindet. Neben eine Standardarbeitsanweisung (SOP) gelegt, kann die Ausgabe einen ausgelassenen, doppelten oder falsch eingeordneten Schritt mit Zeitstempel melden. Laut Roboflow funktioniert dasselbe Prinzip für Kommissionierung, Verpackung, Maschinenumrüstungen und Qualitätsprüfungen an einer Station.
Vom Labeln zum Training
Der Ablauf beginnt auf app.roboflow.com: Dort legen Nutzer ein neues Projekt an und wählen „Action Recognition“. Roboflow rät, Clips der Kamera hochzuladen, die später produktiv läuft, mit demselben Winkel und derselben Beleuchtung. Nach Angaben des Unternehmens genügen für den Anfang einige Dutzend kurze Videos, die jeweils die gesamte Aufgabe zeigen. Für ein erneutes Training lassen sich später weitere ergänzen.
Beim Labeln kommen keine Bounding Boxes zum Einsatz. Stattdessen ziehen Nutzer in einer Zeitleistenzeile einen Bereich auf, um Anfang und Ende einer Handlung zu markieren, und vergeben dann den Klassennamen. Jede Klasse hat eine eigene Zeile, sodass ein Video viele Handlungen enthalten kann. Die Ränder lassen sich ziehen oder mit „Set In“ und „Set Out“ bildgenau setzen. Roboflow empfiehlt, ein Segment mit der ersten Bewegung einer Handlung zu beginnen, es zu beenden, wenn die Handlung abgeschlossen ist, und Leerlaufzeiten auszulassen.
Sind die Videos gelabelt, erstellen Nutzer eine Dataset-Version, klicken auf „Train on This Version“ und wählen „Cosmos 3“ mit der Modellgröße „Edge“. Im Vergleich zu V-JEPA 2.1 trainiert Cosmos 3 Edge laut Roboflow langsamer, nutzt aber mehr Bewegungs- und Zeitkontext. Das helfe, wenn zwei Schritte in einem einzelnen Bild ähnlich aussehen und sich nur in der Bewegung unterscheiden.
Die Standardwerte funktionieren laut Roboflow für die meisten Projekte. Wer einen Trainingslauf anpassen möchte, öffnet „Customize Training Recipe“:
- Sliding Window: zerlegt jedes Video in Fenster, statt es als Ganzes zu zeigen; empfohlen für lange Videos.
- Frames per Window: Standardwert 64.
- Sampling Rate (fps): Standardwert 4, die Rate, für die Cosmos 3 veröffentlicht wurde.
- Frame Resolution: die lange Seite jedes Bildes, von 240p bis 720p, Standardwert 360p.
Mit den Standardwerten deckt jedes Fenster 16 Sekunden Video ab. Laut Roboflow muss ein Fenster lang genug sein, um die längste Handlung zu fassen. Ein Panel „Ready to train“ zeigt geschätzte Credits und Trainingsdauer an, und ein „Credit Cap“ stoppt den Lauf, sobald ein festgelegtes Budget erreicht ist. Zudem lässt sich von einem früheren Checkpoint starten oder die Anzahl der Epochen ändern.
Modell ausführen und Bedeutung
Ist das Training abgeschlossen, erhalten Nutzer eine E-Mail, und das Modell erscheint unter „Models“. Sie kopieren die Modell-ID und schicken einen Clip über die Serverless Cloud API, etwa mit dem Client inference_sdk und dessen Aufruf infer_on_video. Die Antwort enthält eine Zeitleiste der gefundenen Handlungen.
Roboflow schlägt vor, diese Zeitleiste mit der SOP abzugleichen: Ist jeder Schritt vorhanden, in der richtigen Reihenfolge und innerhalb der Zielzeit? Das Ergebnis lässt sich an ein Dashboard, einen Linienalarm oder ein MES übergeben. Wer lieber in natürlicher Sprache Fragen zu einer Szene stellen möchte, kann das Basismodell Cosmos 3 Edge nutzen, das ebenfalls über die API und als Block „Cosmos 3“ in Workflows verfügbar ist.
Für Teams in Fertigung und Logistik bietet die Veröffentlichung die Möglichkeit, Stationsvideos in schrittweise Zeitleisten zu verwandeln, ohne Boxen Bild für Bild zu zeichnen. Roboflow lädt Interessierte ein, sich anzumelden oder mit dem Vertrieb über einen Einsatz an mehreren Standorten zu sprechen.
Roboflow: Fine-Tune NVIDIA Cosmos 3 Edge on Your Own Video