Roboflow-Test zeigt, wie ein 90-Sekunden-GPU-Verkehrsanstieg zum Ausfall führt
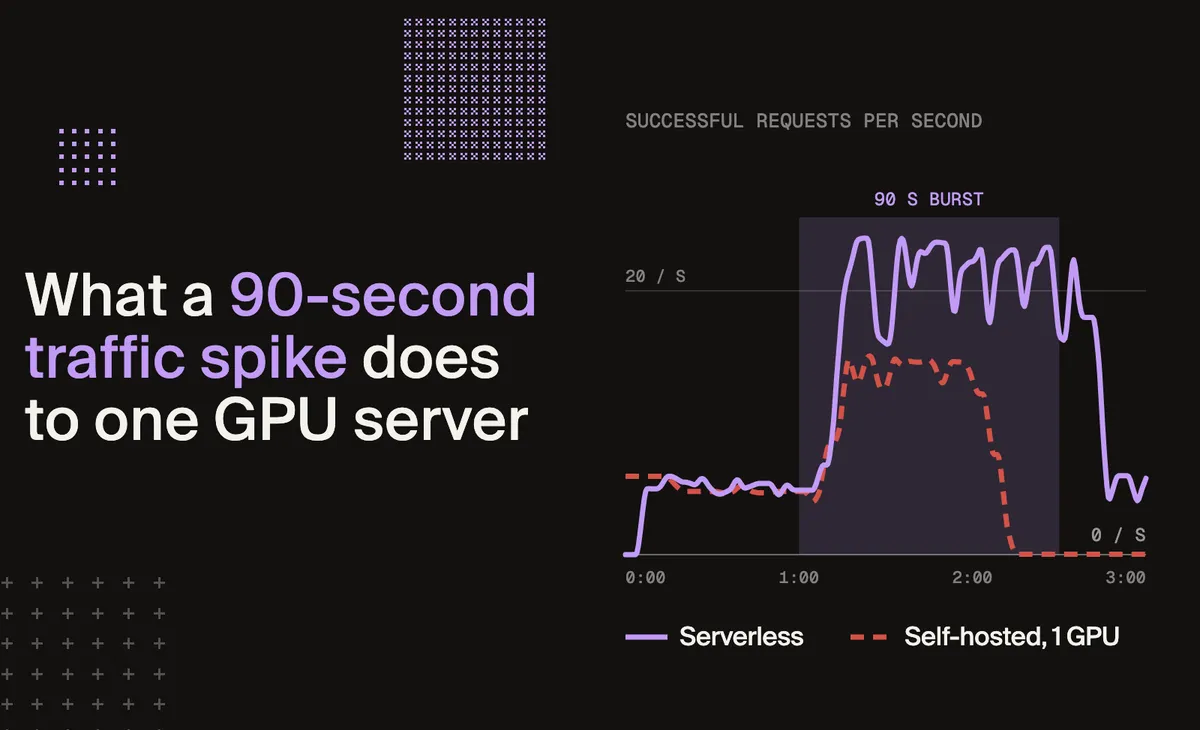
Ein 90-sekündiger Anstieg des Computer-Vision-Datenverkehrs führte bei einem einzelnen, selbst gehosteten NVIDIA-L40S-Server zu Timeouts. Roboflow Serverless lieferte dagegen weiterhin Inferenz-Ergebnisse. Der Vergleich zeigt die Herausforderungen bei der Kapazitätsplanung für Echtzeit-Vision-Workloads auf fest dimensionierter GPU-Infrastruktur.
- Ein 90-sekündiger Anstieg erhöhte den Datenverkehr von 5 auf 20 Anfragen pro Sekunde.
- Jede Anfrage erzeugte 16 Modellaufrufe, wodurch 320 Modellaufrufe pro Sekunde erreicht wurden.
- Die mediane Latenz des selbst gehosteten Servers erreichte das 20-Sekunden-Timeout.
- Serverless gab 2.273 erfolgreiche Anfragen mit einer medianen Latenz von 1,4 Sekunden zurück.
- Roboflow maß etwa fünf Minuten, um einen zusätzlichen GPU-Server zu starten.
Ein anspruchsvoller Workflow zur Fahrzeugzählung
Roboflow testete die beiden Bereitstellungsansätze mit einem Workflow, der Fahrzeuge in 1280×1280 großen Luftaufnahmen eines Parkplatzes zählte. Der Workflow nutzte SAHI, um jedes Bild in 16 überlappende Kacheln mit einer Größe von 427×427 zu teilen, den Detektor auf jeder Kachel auszuführen, überlappende Erkennungen zusammenzuführen und die verbleibenden Boxen zu zählen.
Dieser Prozess erfasste 102 Fahrzeuge im Testbild, verglichen mit zwei Fahrzeugen, wenn das vollständige Bild in einem einzigen Vorgang durch den Detektor geleitet wurde. Obwohl der Client nur eine API-Anfrage stellte, löste jede Anfrage 16 Modell-Inferenzen und den Zusammenfügungsprozess aus. Dadurch entstand eine deutlich höhere Arbeitslast als bei einem einfachen Benchmark mit einem einzelnen Bild.
Derselbe Datenverkehr legte einen deutlichen Unterschied offen
Roboflow verglich seinen gehosteten Inferenzdienst unter der Adresse serverless.roboflow.com mit einer einzelnen Cloud-VM, auf der eine NVIDIA L40S und Roboflows Open-Source-Inferenzserver in Version 1.7.4 mit den Standardeinstellungen liefen. Beide nutzten dieselbe Locust-Datei und Konfiguration für den Lasttest. Der einzige Unterschied zwischen den Tests war die Host-URL.
Der Test begann eine Minute lang mit 20 simulierten Nutzern, entsprechend fünf Anfragen pro Sekunde. Anschließend wurde die Zahl für 90 Sekunden auf 80 Nutzer beziehungsweise 20 Anfragen pro Sekunde erhöht, bevor sie für 30 Sekunden wieder auf 20 Nutzer sank. Da jede Anfrage 16 Modellaufrufe erzeugte, erreichte die Spitzenlast 320 Modellaufrufe pro Sekunde. Anfragen mit einer Dauer von mehr als 20 Sekunden wurden als Fehler gewertet.
Bei fünf Anfragen pro Sekunde lag die mediane Latenz beider Systeme bei etwa einer Sekunde. Während des Anstiegs bearbeitete der selbst gehostete Server ungefähr 13 bis 15 Anfragen pro Sekunde, während weiterhin 20 Anfragen pro Sekunde eintrafen. Seine mediane Latenz stieg bis zum 20-Sekunden-Timeout, und die Zahl erfolgreicher Antworten fiel später auf null, auch nachdem der Datenverkehr wieder auf fünf Anfragen pro Sekunde zurückgegangen war.
Auch bei Roboflow Serverless stieg die mediane Latenz. Zu Beginn des Anstiegs erreichte sie etwa drei Sekunden, pendelte sich später bei rund 1,3 Sekunden ein und bewältigte dabei ungefähr 16 bis 24 Anfragen pro Sekunde. Nach dem Anstieg sank die mediane Latenz auf etwa eine halbe Sekunde.
Gemeldete Ergebnisse und die Grenzen der automatischen Skalierung
Über den dreiminütigen Lauf hinweg meldete Roboflow, dass Serverless 2.273 erfolgreiche Anfragen mit einer medianen Latenz von 1,4 Sekunden zurückgab. Der selbst gehostete Server beantwortete 1.095 Anfragen, mit einer medianen Latenz von 20 Sekunden über den gesamten Lauf. Locust wertete 50 % der Anfragen an den selbst gehosteten Server als Fehler, verglichen mit gerundet 0 % bei Serverless.
Roboflow zufolge haben Betreiber zwei zentrale Möglichkeiten, auf das Ergebnis beim Self-Hosting zu reagieren: Sie können genügend GPUs für den größten erwarteten Anstieg bereitstellen oder automatisch skalieren. In seiner Demonstration maß das Unternehmen etwa fünf Minuten, um die GPU-VM zu starten, den Inferenz-Container abzurufen und den Server zu starten. Da der Verkehrsanstieg 90 Sekunden dauerte, wäre eine neue GPU erst nach dem Ende des Anstiegs verfügbar gewesen.
Das Unternehmen erklärt, dass sein serverloses System für jedes Modell Warteschlangen sowie GPU-Worker verwendet, die Modelle bevorzugen, die bereits im VRAM geladen sind. Roboflow zufolge antwortet ein warmes Modell in etwa 5 ms, während das Laden eines kalten Modells rund 30 Sekunden dauert. Das System skaliert anhand des Rückstands über alle Modelle hinweg und hält eine warme Grundkapazität als Reserve vor. Die eigenen Trainingsjobs von Roboflow treten zurück, wenn die Inferenz mehr GPUs benötigt.
Was der Vergleich für die Wahl des Bereitstellungsmodells bedeutet
Der Test stützt Roboflows Unterscheidung zwischen gleichmäßigen und schwankenden Workloads. Self-Hosting kann eine sinnvolle Wahl sein, wenn der Datenverkehr vorhersehbar ist. Eine Arbeitslast kann jedoch stark ansteigen, wenn weitere Kameras online gehen, eine Produktionslinie startet, Aufnahmen nachträglich verarbeitet werden oder ein Workflow mehr Bildkacheln hinzufügt, ohne dass die Anfragerate steigt.
Für Nutzer des getesteten Workflows besteht der praktische Zielkonflikt darin, den maximalen GPU-Bedarf im Voraus zu planen oder einen Dienst zu verwenden, der während eines Anstiegs zusätzliche Kapazität bereitstellt. Roboflow zufolge lief derselbe Workflow auf Serverless, ohne dass außer der URL eine Änderung erforderlich war. Die Ergebnisse sind der Benchmark des Unternehmens für diese spezifische Konfiguration und keine allgemeine Leistungsbehauptung für jeden Inferenz-Workload.