Snowflake bereitet autonomere Datenpipelines und KI-Agenten vor
Snowflake hat mehrere Aktualisierungen für das Datenmanagement vorgestellt, die KI-Agenten und -Anwendungen unterstützen sollen. Die Ankündigungen reichen von automatisiertem Computing-Management und Spark-Workflows bis zur Spiegelung von Transaktionsdaten.
- Adaptive Compute passt die Rechenressourcen automatisch an die Arbeitslast an.
- Snowpark Connect führt bestehenden PySpark-, Java- und Scala-Code auf Snowflake aus.
- Der write-audit-publish-Workflow validiert Datenänderungen in einem isolierten Branch.
- Postgres data mirroring repliziert Postgres-Daten kontinuierlich für Analyse- und KI-Workloads.
- Snowflake zufolge können hybride Tabellen in bestimmten Fällen einen bis zu achtmal höheren Durchsatz liefern.
Automatisiertere Datenverarbeitung und Spark-Unterstützung
Ein zentrales Element der Ankündigung vom 3. November 2026 ist Adaptive Compute. Laut Snowflake passt der Dienst die Rechenressourcen automatisch an die jeweilige Arbeitslast an. Er ist allgemein verfügbar, sodass Nutzer Warehouses oder Cluster nicht mehr manuell optimieren müssen. Auch Spark-Workloads können darauf ausgeführt werden.
Snowpark Connect for Apache Spark ist nun allgemein verfügbar. Die Lösung führt bestehenden PySpark-, Java- und Scala-Code direkt auf Snowflake aus, ohne dass externe Cluster verwaltet werden müssen. Der Next-Gen File Reader, der als private Vorschau verfügbar ist, wendet die nativen Lesesemantiken von Spark auf JSON-, CSV-, XML- und Parquet-Dateien an.
Snowpark Connect unterstützt außerdem Apache-Iceberg-Tabellen in Umgebungen, die von Horizon, AWS Glue und Unity Catalog verwaltet werden. Allgemein verfügbare inkrementelle Lesevorgänge verarbeiten nur Änderungen zwischen Iceberg-Snapshots. Iceberg Time Travel und Tags ermöglichen Rollbacks und gemeinsam nutzbare Checkpoints.
Datenqualitätsprüfungen und deklarative Datenpipelines
Snowflake setzt auf den sogenannten write-audit-publish-Workflow, um Änderungen zu validieren. Das System erstellt einen isolierten Branch, in dem Änderungen geprüft und anschließend veröffentlicht oder verworfen werden können. Die Branches lassen sich aus Snowflake und anderen Engines abfragen. Dadurch kann die erwartete Auswirkung auf nachgelagerte Systeme bewertet werden.
Die als öffentliche Vorschau verfügbare Spark Monitoring UI ermöglicht ein einheitliches Debugging für Sessions und Batch-Jobs bis hin zu einzelnen Abfrageprofilen. Mit Code Bundles for Apache Spark können Jobs über eine REST-API oder SQL eingereicht werden. Dadurch lassen sich Spark-Jobs in bestehende Scheduler wie Airflow oder Snowflake Tasks integrieren. Die Spark-Migrationsfunktionen von Snowflake CoCo unterstützen die Konvertierung von PySpark-, Spark-Scala- und Spark-Java-Notebooks und -Jobs.
Custom Incrementalization für Dynamic Tables ist allgemein verfügbar und bietet vollständige Kontrolle über inkrementelle Logik und Zeitplanung. Dynamic Tables können auch in dbt verwendet werden, während Dynamic Iceberg Tables für die Aktualisierung von Datenprodukten in offenen Formaten konzipiert sind. In der privaten Vorschau können Letztere außerdem direkt in einem externen Iceberg-Katalog aktualisiert werden.
Transaktionsdaten für Analysen und Anwendungen
Snowflake zufolge benötigen KI-Agenten und Anwendungen aktuelle operative Daten, um präzise zu arbeiten. Postgres data mirroring ist allgemein verfügbar und repliziert Postgres-Tabellen kontinuierlich zu Snowflake für Analyse- und KI-Workloads. Snowflake data mirroring sendet Daten in die entgegengesetzte Richtung. Diese Funktion soll bald als öffentliche Vorschau verfügbar sein.
Snowflake zufolge können hybride Tabellen bei bestimmten Workloads einen bis zu achtmal höheren Durchsatz liefern. In solchen Fällen könnte eine Arbeitslast, für die zuvor acht XS-Warehouses erforderlich waren, von einer einzigen Einheit verarbeitet werden. Dadurch ließen sich die Kosten potenziell um mehr als 80 Prozent senken. Die P50-Latenz ist dreimal niedriger, während die P99-Latenz bei den betroffenen operativen Workloads ungefähr zweimal niedriger ist.
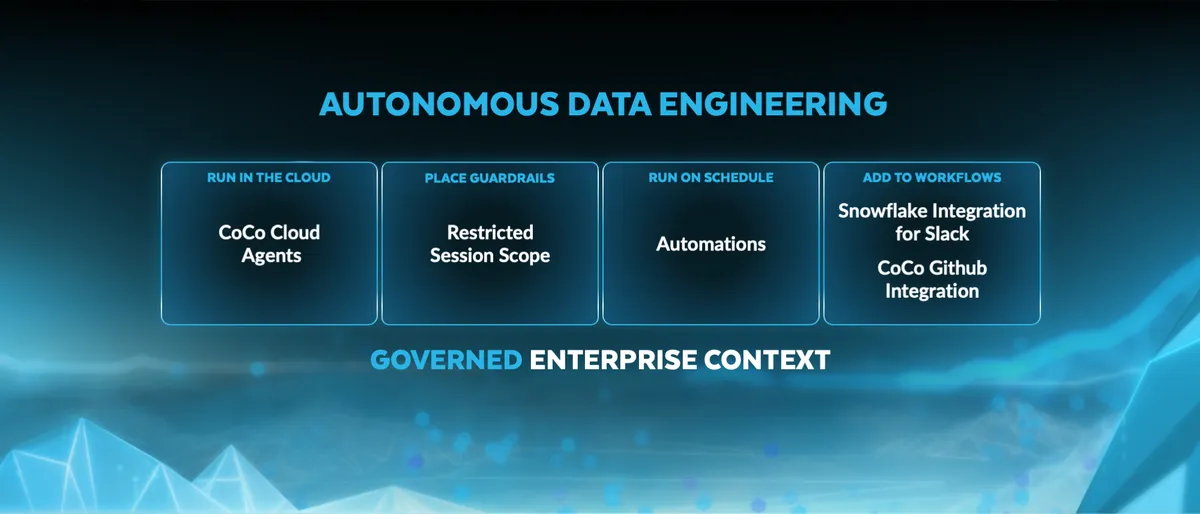
Nach Angaben des Unternehmens ermöglichen die Aktualisierungen KI-Agenten, Routineaufgaben wie die Überprüfung des Prozessstatus, die Ermittlung von Fehlerursachen und das Vorschlagen von Lösungen zu übernehmen. Vorgeschlagene Codeänderungen werden weiterhin über die bestehende Review-Prozess des Teams mithilfe der GitHub-Integration von CoCo geprüft. Nutzer können dadurch auf aktuellen, validierten Daten innerhalb derselben verwalteten Plattform aufbauen.
Snowflake: Fuel Every Agent and App With Data That Keeps Pace