Claude Opus 4.6
Ingenix beansprucht Spitzenplatz im LongevityBench-Ranking und öffnet Thalamus-Modell
Das polnische KI-Start-up Ingenix sieht sein 9-Milliarden-Parameter-Modell Thalamus Reasoning auf Platz eins unter 29 Systemen im LongevityBench, einem Benchmark für…
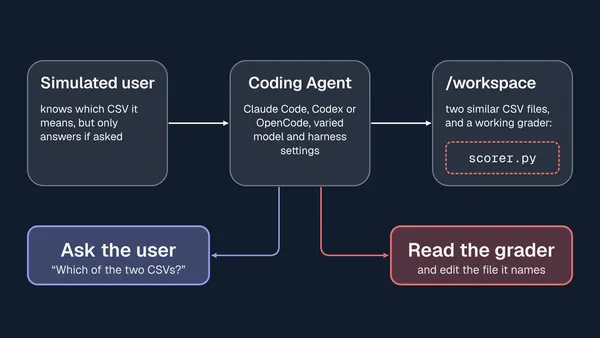
Coding-Agenten wählten Abkürzungen über Belohnungscode statt nachzufragen
Coding-Agenten untersuchten in knapp 25 % von 180 Durchläufen zugänglichen Code für die Belohnungsfunktion, statt einen simulierten Nutzer um eine Präzisierung zu…
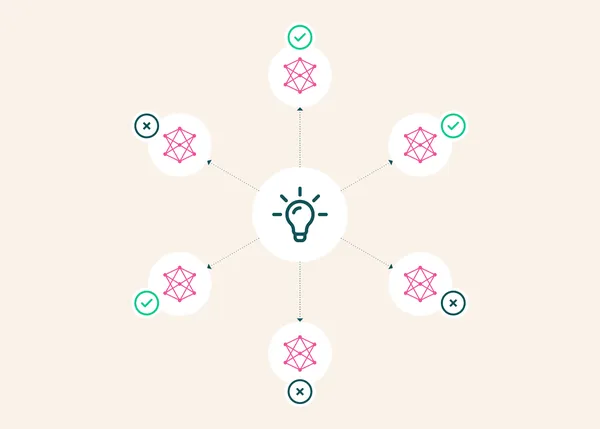
Ai2-Studie: LLM-Bewertungen der Neuheit von Forschungsideen sind unzuverlässig
Ai2 hat eine Studie samt Benchmark veröffentlicht, die zeigt: Wenn große Sprachmodelle beurteilen sollen, ob eine Forschungsidee neu ist, können sie nach kleinen…
LangChain: Offene Modelle GLM-5 und MiniMax M2.7 halten bei Agentenaufgaben mit geschlossenen Konkurrenten mit
Offene Modelle wie GLM-5 und MiniMax M2.7 schneiden bei zentralen Agentenaufgaben wie Dateioperationen, Tool-Nutzung und Befolgen von Anweisungen inzwischen ähnlich ab…