Together AI sagt, einfachere Kernel können seine Megakernels schlagen
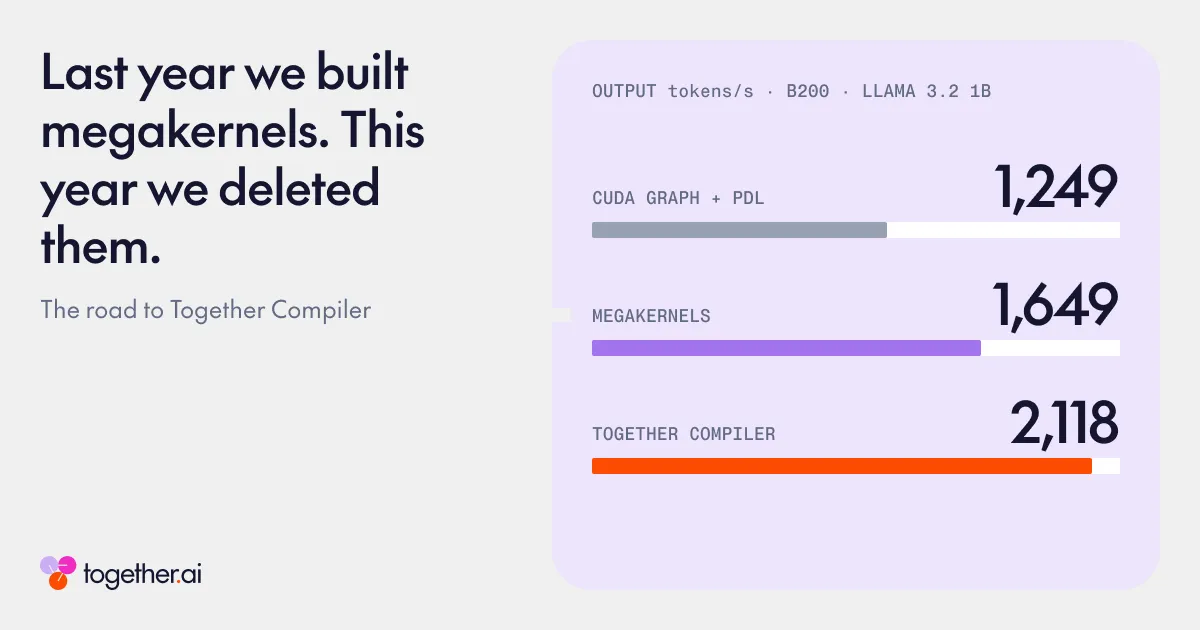
Together AI hat nach eigenen Angaben seine schwer bereitzustellenden KI-Megakernels durch einen anpassungsfähigeren Ansatz auf Basis von CUDA Graphs, PDL, Torch-Inductor-Kernels und automatisierter Optimierung ersetzt. Das Unternehmen erklärt, dieser Ansatz habe 98 % der Megakernel-Leistung wiederhergestellt, ohne einen einzigen Kernel zu schreiben. Multi-Kernels und Agentenschleifen übertrafen die bisherigen Systeme demnach um bis zu 1,7-mal.
- Together AI zufolge stellten CUDA Graphs und PDL 98 % der Megakernel-Leistung wieder her.
- Multi-Kernels und Agentenschleifen erreichten bei Llama 1B auf H100 mehr als 1100 TPS.
- Der Ansatz übertraf laut Unternehmen die älteren Megakernels um bis zu 1,7-mal.
- Inductor legte laut Together AI im dritten Quartal 2026 607 Tuning-Flags offen.
- Together AI stellte fest, dass isolierte Benchmarks die Leistung bei laufender Inferenz falsch darstellen können.
Von Rekordgeschwindigkeiten zu den Grenzen der Produktion
Die Ankündigung von Together AI erfolgt vor dem Hintergrund zunehmend vielfältiger KI-Inferenz-Workloads. Modellarchitekturen ändern sich häufig, der Datenverkehr verteilt sich auf unterschiedliche Batch-Größen und Sequenzlängen, und die Zahl der Hardwareplattformen wächst weiter. Nach Angaben des Unternehmens müssen Optimierungssysteme mit diesen sich wandelnden Bedingungen umgehen können, statt auf eine einzige feste Konfiguration ausgerichtet zu sein.
Im vergangenen Jahr war Together AI an der Veröffentlichung einiger der ersten KI-Megakernels beteiligt. Diese Systeme führten einen vollständigen Forward-Pass eines Modells in einem einzigen, stark fusionierten GPU-Kernel aus und erreichten Rekordgeschwindigkeiten. Die Bereitstellung im produktiven Betrieb erwies sich jedoch als deutlich schwieriger. Nach monatelanger Arbeit hatte das Unternehmen nach eigenen Angaben ein Modell, eine Batch-Größe und einen Kunden.
Diese Erfahrung veranlasste Together AI, zu hinterfragen, ob der größtmögliche fusionierte Kernel immer das richtige Ziel ist. Das Unternehmen erklärt, CUDA Graphs und PDL hätten in Kombination mit standardmäßigen Torch-Inductor-Kernels 98 % der Megakernel-Leistung wiederhergestellt, ohne einen eigenen Kernel zu benötigen. Zudem hätten Multi-Kernels und Agentenschleifen die älteren Megakernels um bis zu 1,7-mal übertroffen und bei Llama 1B auf H100 mehr als 1100 TPS erreicht.
Warum Together AI über Compiler-Heuristiken hinausblickt
Together Compiler wird als Framework für die kontinuierliche Optimierung von KI-Inferenz vorgestellt. Nach Darstellung des Unternehmens entstand das Projekt aus zwei Jahren Arbeit an GPU-Programmierung und Optimierungssystemen, darunter Untersuchungen zu Torch Compile und den darauf folgenden Megakernels.
Together AI zufolge erfasst Torch Compile, das von Inductor unterstützt wird, PyTorch-Operationen in einem Berechnungsgraphen, optimiert diesen Graphen und erzeugt ausführbare GPU-Kernels. Inductor verwendet paarweise, gierige Fusionsentscheidungen sowie Heuristiken, die Faktoren wie die Einsparungen beim Speicherverkehr schätzen. Das Unternehmen argumentiert, dass diese lokalen Entscheidungen nicht global über alle möglichen Kernel-Aufteilungen und Ausführungsstrategien hinweg suchen.
Experimente mit Llama 1B ergaben laut Together AI, dass Compilereinstellungen je nach Workload sehr unterschiedliche Ergebnisse liefern können. Das Unternehmen erklärt, die Aktivierung von Freezing habe den Durchsatz um 10, 26 % bei größeren Batch-Größen verbessert, aber bei Batch-Größe 1 eine Verlangsamung um 49 % verursacht. Im dritten Quartal 2026 legte Inductor nach Angaben des Unternehmens 607 Tuning-Flags offen, darunter 198, die im Vorjahr hinzugekommen waren. Together AI argumentiert, dass bei diesem Umfang eine systematische Suche sinnvoller ist, als manuell zu erraten, welche Flags aktiviert werden sollten.
Benchmarks können das reale Inferenzverhalten verfehlen
Together AI bezweifelt außerdem, dass isolierte Kernel-Benchmarks die Leistung bei laufender Inferenz zuverlässig vorhersagen. Das Unternehmen erklärt, Inductor leere vor der Messung einzelner Kernels den L2-Cache der GPU, obwohl Kernels in einem realen Forward-Pass möglicherweise Daten wiederverwenden, die von vorherigen Operationen hinterlassen wurden. In seinen Experimenten waren die Zeiten isolierter Benchmarks 39, 58 % langsamer als die Zeiten bei laufender Inferenz, wenn die Cache-Wiederverwendung den Speicherverkehr reduzierte.
Bei Embedding-Benchmarks beschreibt das Unternehmen das umgekehrte Problem. Inductor habe Token-IDs auf null initialisiert, sodass jedes Token auf denselben Embedding-Vektor zugriff. Bei einer Sequenz mit 64K Tokens habe dies den Kernel laut Together AI 2,1-mal schneller gemacht als bei der Verwendung zufälliger Token-IDs, da die wiederholten Zugriffe eine ungewöhnlich hohe Cache-Wiederverwendung erzeugten.
Diese Ergebnisse stützen Together AIs umfassendere Argumentation für ein Optimierungsframework, das Konfigurationen in realistischen Ausführungskontexten testet. Nach Angaben des Unternehmens werden sich die übrigen Teile seines Blogbeitrags mit den Grenzen von Megakernels, den einfacheren Grundbausteinen hinter ihren Leistungsgewinnen und der agentengesteuerten Infrastruktur befassen, mit der Together Compiler entwickelt wird.