Ultralytics vergleicht TensorRT mit ONNX Runtime auf 19 GPUs
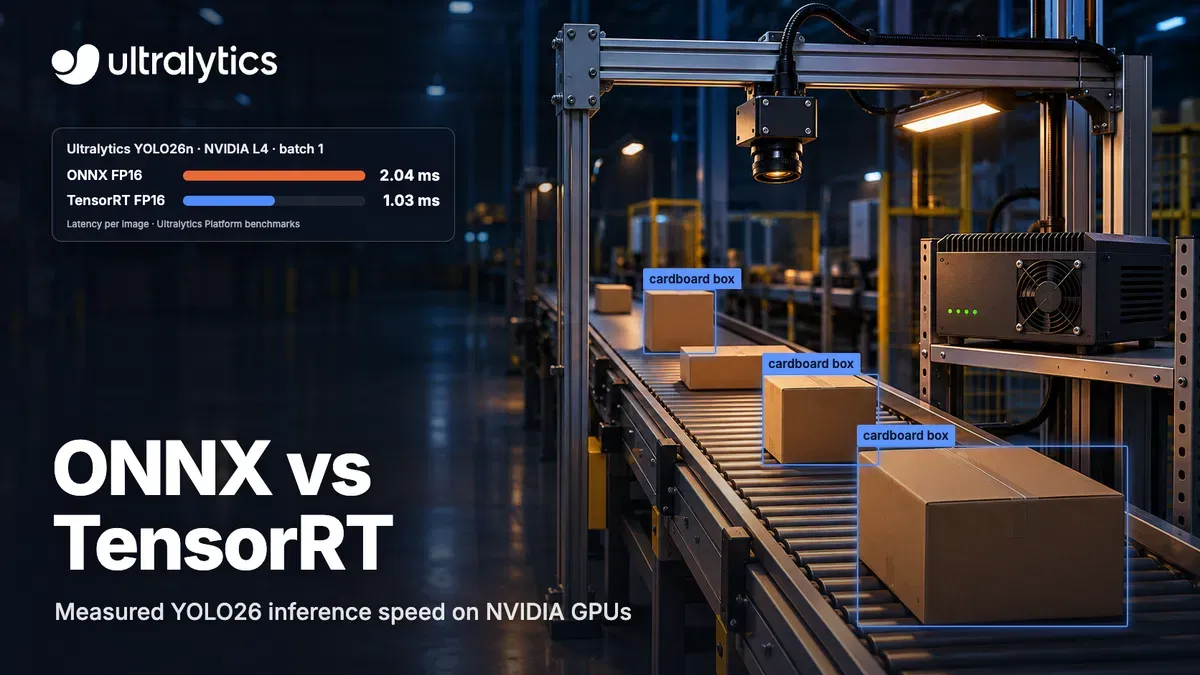
TensorRT FP16 war bei Ultralytics YOLO26 auf 19 NVIDIA-GPUs schneller als die veröffentlichten ONNX-FP16-Ergebnisse. Das geht aus Benchmarks hervor, die Ultralytics am 5. November 2026 veröffentlicht hat. Die Ergebnisse zeigen, dass die Wahl davon abhängt, ob bei der Bereitstellung die Latenz auf NVIDIA-GPUs oder die Hardware-Flexibilität im Vordergrund steht.
- TensorRT FP16 war auf allen 19 getesteten NVIDIA-GPUs schneller als die veröffentlichten ONNX-FP16-Ergebnisse.
- Die mittleren Geschwindigkeitsgewinne von TensorRT FP16 lagen bei den YOLO26-Modellgrößen zwischen 1.85x und 2.55x.
- Der Benchmark gibt nicht an, welcher ONNX-Runtime-Execution-Provider verwendet wurde.
- INT8 war bei YOLO26n auf 17 von 19 GPUs langsamer als FP16.
- ONNX Runtime eignet sich für gemischte Hardware, während TensorRT FP16 auf geringe Latenz bei NVIDIA-GPUs ausgerichtet ist.
ONNX und TensorRT erfüllen unterschiedliche Aufgaben
Ultralytics zufolge sind ONNX und TensorRT keine direkten Konkurrenten. ONNX, kurz für Open Neural Network Exchange, ist ein Modellformat, das den Graphen und die Gewichte eines trainierten Modells in einer frameworkneutralen Datei speichert. TensorRT ist die Inferenz-Engine von NVIDIA. Sie verwendet typischerweise eine ONNX-Datei als Eingabe und kompiliert sie zu einer optimierten Engine.
ONNX Runtime führt ONNX-Modelle über Hardware-Backends aus, die als Execution Provider bezeichnet werden. Dazu gehören CPU, CUDA und TensorRT. Dadurch kann eine Modelldatei auf unterstützter Hardware ausgeführt werden. ONNX Runtime kann außerdem den TensorRT Execution Provider verwenden, während CUDA Knoten verarbeiten kann, die TensorRT nicht unterstützt.
Eine eigenständige TensorRT-Engine wird dagegen für einen bestimmten NVIDIA-GPU-Typ kompiliert. Laut Ultralytics lassen sich die YOLO-Modelle mit einem einzigen Argument nach ONNX oder TensorRT exportieren.
TensorRT FP16 führte beim YOLO26-Geschwindigkeitsvergleich
Die Benchmarks maßen die Erkennungsmodelle Ultralytics YOLO26 auf 19 NVIDIA-GPUs aus den Familien Ampere, Ada und Hopper. Getestet wurde mit Batch 1, Eingaben mit 640 Pixeln und COCO val2017. Die Aufwärmphase wurde nicht berücksichtigt, und die Zeiten pro Durchlauf wurden per Sigma-Clipping bereinigt. Die Genauigkeit wurde als mAP 50-95 gemessen.
TensorRT FP16 war auf jeder GPU und bei jeder Modellgröße schneller als die veröffentlichten ONNX-FP16-Ergebnisse, während die Genauigkeit innerhalb von 0.001 mAP 50-95 blieb. Die mittleren Geschwindigkeitsgewinne lagen zwischen 1.85x bei YOLO26m und 2.55x bei YOLO26n. Die veröffentlichten Genauigkeitswerte betrugen 0.397 für beide YOLO26n-Formate, 0.471 für YOLO26s, 0.519 für YOLO26m, 0.535 für YOLO26l mit TensorRT FP16 gegenüber 0.536 mit ONNX FP16 sowie 0.564 für YOLO26x mit TensorRT FP16 gegenüber 0.563 mit ONNX FP16.
Ultralytics weist darauf hin, dass der Benchmark nicht angibt, welcher ONNX-Runtime-Execution-Provider die ONNX-Ergebnisse erzeugt hat. Daher lässt sich daraus weder ein allgemeiner Vergleich mit ONNX Runtime ableiten noch ein Vergleich bei Verwendung des TensorRT Execution Providers.
INT8 kann die Geschwindigkeit erhöhen, muss aber validiert werden
Der Vergleich testete auch TensorRT INT8. Die Ergebnisse zeigen, dass eine geringere Präzision nicht automatisch schneller ist. Bei YOLO26n war INT8 auf 17 der 19 GPUs langsamer als TensorRT FP16 und verringerte die Genauigkeit um 0.04 mAP 50-95.
Bei größeren Modellen half INT8 häufiger und erreichte bei YOLO26x auf einer L4 bis zu die 1.67-fache Geschwindigkeit von TensorRT FP16. Gleichzeitig verringerte sich die Genauigkeit über die Modellgrößen hinweg um 0.034 bis 0.076 mAP 50-95. Für den Benchmark wurde NVIDIA ModelOpt mit COCO128 als Kalibrierungsdaten verwendet. Ultralytics empfiehlt dagegen, mit repräsentativen Bildern aus dem Einsatzbereich zu kalibrieren und die Genauigkeit mit den vorgesehenen Daten zu validieren.
Die Wahl für die Bereitstellung hängt von der Hardware ab
Ultralytics empfiehlt, bei einer YOLO26-Bereitstellung auf einer NVIDIA-GPU und hohen Anforderungen an die Latenz mit TensorRT FP16 zu beginnen. Eine TensorRT-Engine ist standardmäßig an die zum Erstellen verwendete GPU und TensorRT-Version gebunden. Eine auf einer RTX 4090 erstellte Engine sollte daher nicht direkt auf eine H100 oder Jetson kopiert werden. Das Unternehmen erklärt, Engines sollten grundsätzlich auf dem Zielgerät oder für dieses erstellt werden.
ONNX Runtime ist die flexiblere Option, wenn eine Modelldatei auf unterschiedlichen Hardwaretypen laufen muss, darunter CPUs, Hardware anderer Hersteller als NVIDIA oder gemischte Flotten. Dieselbe ONNX-Datei kann überall ausgeführt werden, wo ONNX Runtime und ein geeigneter Execution Provider verfügbar sind. Beide Formate unterstützen variable Eingabegrößen. Dynamische TensorRT-Formen erfordern jedoch ein Optimierungsprofil, das minimale, optimale und maximale Dimensionen festlegt.
Ultralytics zufolge gelten die Ergebnisse für das getestete Setup mit Batch 1 und Eingaben mit 640 Pixeln. Nutzer sollten ihr eigenes Modell, ihre Daten und ihr Zielgerät benchmarken, bevor sie ein Format auswählen. Das gilt insbesondere bei ONNX Runtime mit TensorRT im Hintergrund oder bei einer INT8-Engine.
Ultralytics: ONNX vs TensorRT for computer vision inference: benchmarks and how to choose