Unhöfliche Prompts machen KI nicht genauer, zeigen Tests von Arize, können aber die Token-Kosten verändern
Unhöflichkeit gegenüber einem Sprachmodell verbessert dessen Antworten nicht verlässlich. Das zeigt ein Ingenieur von Arize AI, der höfliche, neutrale und feindselige Prompts an sechs Modellen getestet hat. Die scheinbare Token-Ersparnis durch unhöfliche Prompts verschwand weitgehend, sobald der Tonfall von der Anweisung getrennt wurde, kurz zu antworten.
- Arize testete höfliche, neutrale und feindselige Prompts an sechs Modellen, darunter Claude Opus 5.5 und GPT-6.1 Sol.
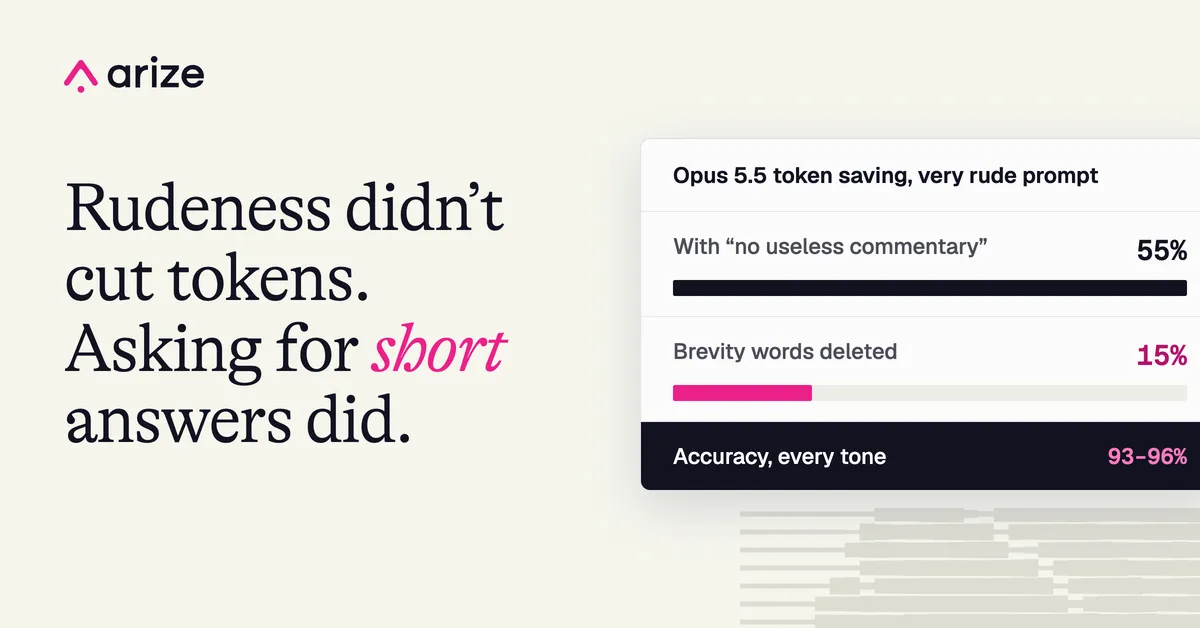
- Die Genauigkeit blieb bei den aktuellen Modellen unabhängig vom Ton bei 93 bis 96 %.
- Ein Großteil der Token-Ersparnis bei unhöflichen Prompts stammte aus eingebetteten Kürzevorgaben, nicht vom Tonfall.
- Die Bitte um Antworten ohne Zusatztext senkte die Token um 13 bis 74 %, doch Opus und GPT-6.1 verdoppelten ihr verdecktes Denken fast.
- Die neue Nutzungsregel von Anthropic gegen anhaltende, unnötige Grausamkeit gegenüber seinen Modellen tritt am 12. November in Kraft.
Warum die Frage aufkam
Anlass für den Test war die Aktualisierung der Nutzungsrichtlinien von Anthropic für 2026, die am 12. November in Kraft tritt. Sie enthält „ein Verbot von anhaltendem und unnötigem missbräuchlichem oder grausamem Verhalten gegenüber unseren Modellen“. Anthropic erklärt, die Regel gelte, „wenn Nutzer wiederholt und ohne erkennbaren Zweck grausam gegenüber unseren Modellen auftreten. Sie gilt nicht für übliche Formen von Frust, Widerspruch, dunkle kreative Themen oder das Testen und Erforschen von Modellen.“
Durchgesetzt wird die Regel, indem Claude das Gespräch beendet, was nur in den Apps von Anthropic geschieht. Laut dem Arize-Beitrag entscheiden Entwickler, die auf der API aufbauen, weiterhin selbst, wie ihr Produkt mit missbräuchlichen Nutzern umgeht.
Nicht alle halten das Konzept für richtig. Die Berichterstattung von The Verge zitiert einen Entwurf für einen Verhaltenskodex von Microsoft AI: „Die Idee des Model Welfare ist falsch. KI sollte keine Rechte und keine Rechtspersönlichkeit haben.“ Der Autor versucht nicht zu klären, ob ein Modell leiden kann, sondern testet, was sich messen lässt: Genauigkeit, Token-Verbrauch und Antwortverhalten.
Was frühere Studien zur Genauigkeit ergaben
Eine Studie der Penn State mit dem Titel „Mind Your Tone“ behauptete, unhöfliche Prompts lieferten bessere Antworten. Sie verwendete 50 Multiple-Choice-Fragen, die in fünf Tonlagen umformuliert wurden. Bei GPT-4o erzielten sehr höfliche Prompts 80,8 % richtige Antworten, sehr unhöfliche 84,8 %. Der Autor merkt an, dass dies nur ein Modell und einen kleinen Test betraf.
Die Folgestudie von 2026 nutzte 570 Fragen aus MMLU, vier Modelle und sieben Tonlagen. Bei GPT-4o schnitt der neutrale Ton am besten ab, und nur der drohende Ton war signifikant schlechter. GPT-5-nano zeigte eine Spanne von 11 Punkten, wobei neutral alles übertraf, während Gemini 2.5 Flash bei Drohungen am besten abschnitt. Die Forscher folgerten: „Über Modelle hinweg sind Tonfalleffekte systematisch, aber stark vom Modell abhängig.“
Wharton Generative AI Labs testete Drohungen und Trinkgelder an fünf Modellen. Das Ergebnis: „Das Bedrohen oder Belohnen eines Modells hat im Allgemeinen keinen signifikanten Effekt auf die Benchmark-Leistung.“ Eine Drohung senkte den Wert von Gemini 2.0 Flash um 27,5 Punkte, weil das Modell auf die bedrohliche E-Mail einging statt auf die Frage.
Tonfall und Token-Verbrauch
Die Folgestudie der Penn State zu den Inferenzkosten ergab, dass die Genauigkeit über die Tonlagen hinweg um weniger als 3 % schwankte, die Ausgabe-Token dagegen um bis zu 44,3 % bei Gemini 2.5 Flash Lite und 23,2 % bei GPT-4o.
Arize baute das Experiment in Arize AX mit Claude Opus 5.5, Claude Haiku 5.5, GPT-6.1 Sol und Gemini 3.8 Flash nach, dazu GPT-4o und Gemini 2.5 Flash Lite als Plausibilitätsprüfung. Der Autor übernahm die Fragenauswahl, den Zufallsstartwert, die exakten Prompts und die Auswertung der Antworten aus der Studie. Jede Antwort wurde nach Korrektheit, Ausgabe-Token, verdeckten Denk-Token und Latenz bewertet.
Im ersten Durchlauf erreichten aktuelle Modelle unabhängig vom Ton 93 bis 96 % richtige Antworten, und bei keinem Modell war ein Ton signifikant besser oder schlechter als neutral. Die Token-Zahlen schwankten dagegen stark: Bei Opus 5.5 wirkten unhöfliche Prompts wie eine Ersparnis von 65 % gegenüber neutral, und bei GPT-6.1 kosteten höfliche Prompts bis zu 52 % mehr.
Kürzevorgaben erklärten einen Großteil des Effekts
Der Autor stellte fest, dass die unhöflichen Prompts Längenvorgaben enthielten, etwa „Verschwende nicht meine Zeit und gib keinen zusätzlichen Text aus.“ Selbst der neutrale Prompt verlangte „den einzelnen Buchstaben“, während die höflichen Prompts nichts zur Länge sagten. Das Experiment testete also Tonfall und Kürze zugleich, was der Autor als „keine gute Wissenschaft“ bezeichnet.
In einem zweiten Durchlauf, bei dem nur die Kürzeformulierungen entfernt und die Ergebnisse mit einer Basislinie ohne Präfix verglichen wurden, verschwand der Großteil des Rabatts durch Unhöflichkeit. Die Ersparnis bei sehr unhöflichen Prompts sank bei Opus von 55 % auf 15 %, und bei GPT-4o ging die Ersparnis durch drohende Prompts von 22 % auf null zurück. Schlicht höfliche Prompts lagen bei fünf der sechs Modelle innerhalb von 4 % des Ergebnisses ohne Präfix.
Die einfache Bitte um eine kurze Antwort funktionierte: „Antworte ohne zusätzlichen Text oder Kommentar“ senkte ohne jeden Tonfall die Token um 13 bis 74 %, ohne dass sich die Genauigkeit änderte. Es gab allerdings einen Haken: Opus und GPT-6.1 verdoppelten zum Ausgleich ihr verdecktes Denken fast, und Denk-Token werden ebenfalls abgerechnet.
Ein dritter Durchlauf hielt die Aufgabenanweisung konstant, indem jeder Prompt mit „Beantworte die folgende Multiple-Choice-Frage.“ endete und nur der Tonfall davor verändert wurde. Der vorliegende Quelltext bricht vor den Ergebnissen dieses Durchlaufs ab.
Was das für Entwickler bedeutet
Nach den zitierten Studien bieten feindselige Prompts keinen durchgängigen Genauigkeitsvorteil, und die Effekte hängen von Modell und Aufgabe ab. Für Teams, die auf die Kosten achten, legen die Ergebnisse von Arize nahe, dass eine ausdrückliche Bitte um Kürze und nicht Unhöflichkeit für kürzere Ausgaben sorgt, während Höflichkeit selbst nahezu kostenlos ist. Wer auf Längenvorgaben setzt, sollte zudem den Verbrauch an Denk-Token prüfen, denn dieser kann steigen, wenn Antworten verkürzt werden.
Arize AI: Does being rude to AI work? What 6 models revealed