VocabX: Spezialisiertes Vokabular senkt die Inferenzkosten eines SLM um 77 Prozent
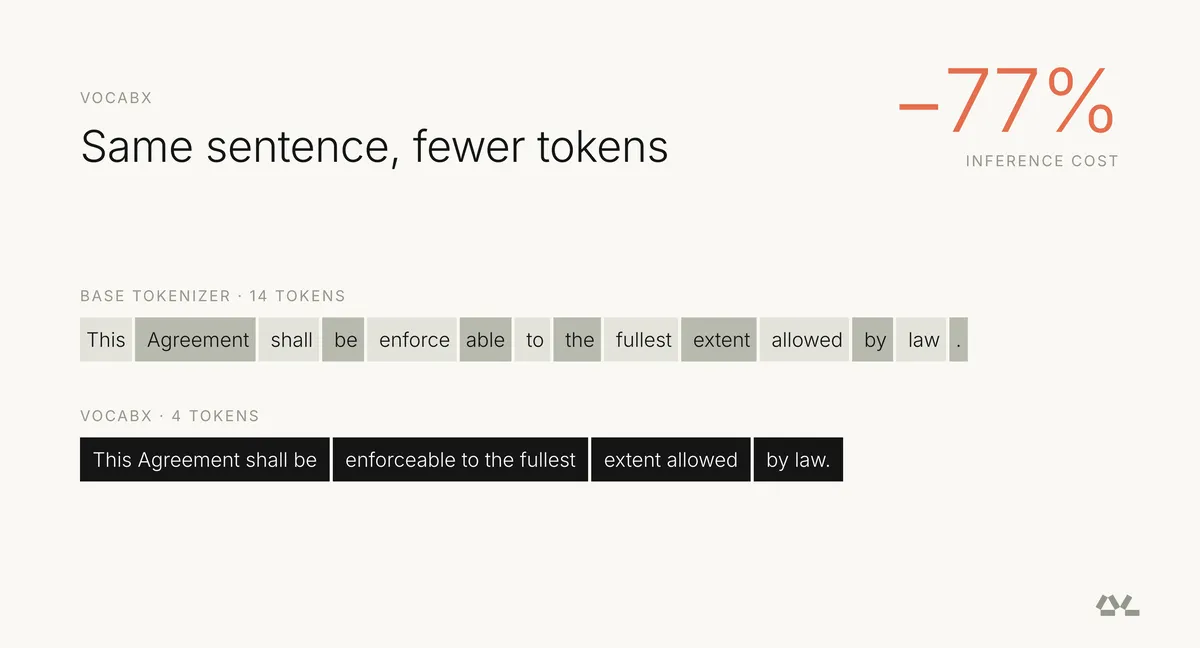
Dharma-AI will die gemessenen Inferenzkosten eines produktiv eingesetzten Aufsatzprüfers um 77 Prozent gesenkt haben, ohne das Basismodell zu verändern. Dafür baute das Team das Tokenizer-Vokabular nicht nach der Häufigkeit, sondern nach den Kosten jedes einzelnen Tokens um. Die Methode namens VocabX wird in einem Blogbeitrag auf Hugging Face beschrieben, der eine Veröffentlichung vorab ankündigt, die das Team nach eigenen Angaben bald vorlegen will.
- Dharma-AI zufolge senkte VocabX die gemessenen Inferenzkosten eines portugiesischen Aufsatzprüfers auf Basis von Qwen3-4B um 77 Prozent, bei gleichem Basismodell, gleichen Daten und gleichem Trainingsrezept.
- Die Methode wählt Tokens nach Kosten statt nach Häufigkeit aus: Beim Prüfer kostet ein erzeugtes Token das 7,4-Fache eines gelesenen.
- VocabX arbeitet nach einem einheitlichen Kostenkriterium auf der Subwort- und der Multiwort-Ebene (Makro-Tokens).
- Die Ausgabeschicht des Prüfers schrumpfte von rund 152.000 auf rund 65.000 Zeilen.
- Die Zahlen stammen aus einem Paper, das noch begutachtet wird und sich vor der Veröffentlichung ändern kann.
Ein Tokenizer für alle, genutzt für eine einzige Aufgabe
Die Fallstudie betrifft einen automatisierten Prüfer für portugiesische Aufsätze auf Basis von Qwen3-4B. Laut dem Team erhält er den Aufsatz, die Aufgabenstellung und die Begleittexte und liefert eine Bewertung im JSON-Format mit einer Note und einem Kommentar zu jeder Kompetenz. Das Modell war mit 4 Milliarden Parametern bereits klein und für die Aufgabe bereits trainiert.
Sein Tokenizer war jedoch weiterhin der ursprüngliche von Qwen3-4B, der für viele Sprachen und viele Textarten ausgelegt ist. Das führt nach Angaben der Autoren zu zwei Arten von Verschwendung. Die erste ist Fragmentierung: Der Tokenizer zerlegt genau das in viele Teile, was in der Domäne am häufigsten wiederkehrt, etwa die JSON-Hülle, die Namen der Kompetenzen und die Bewertungsformeln, mit denen jede Antwort beginnt. Die zweite ist Überschuss: Das Vokabular mit 151.669 Einträgen enthält viele Einträge, die die Aufgabe kaum je braucht, die das Modell aber bei jedem erzeugten Token dennoch bewertet.
Das Team behielt dasselbe Basismodell, dieselben Daten und dasselbe Trainingsrezept bei und änderte ausschließlich das Vokabular. Die Zahlen stammen aus der aktuellen Fassung des Papers, das noch im Begutachtungsprozess ist und sich bis zur Veröffentlichung noch ändern kann.
Warum erzeugte Tokens mehr kosten als gelesene
Das Kernargument lautet: Tokens zu zählen heißt nicht, die Rechnung zu messen. Die Inferenz besteht aus zwei Phasen. Im Prefill verarbeitet das Modell die gesamte Eingabe in einem Durchgang, und die Rechenleistung setzt die Grenze. Im Decode erzeugt es die Antwort Token für Token, und die Grenze verschiebt sich zur Speicherbandbreite, weil die GPU die meiste Zeit auf Daten aus dem Speicher wartet. Nach Angaben der Autoren ist dieser Effekt bei kleinen Modellen mit moderaten Batches am stärksten.
Beim gemessenen Prüfer kostet ein erzeugtes Token das 7,4-Fache eines gelesenen. Die Autoren betonen, dass dieses Verhältnis mit Hardware, Batchgröße, Kontextlänge und weiteren Faktoren schwankt und auch größer ausfallen kann, dass das Erzeugen aber grundsätzlich teurer ist als das Lesen.
Das Vokabular bringt einen dritten Kostenfaktor ins Spiel. Der LM-Head enthält pro Vokabulareintrag eine Zeile an Parametern und macht bei einem Modell in der Größe von Qwen3-4B knapp 10 Prozent der Parameter aus. Für jedes erzeugte Token liest und multipliziert er die gesamte Matrix, sodass ein ungenutzter Eintrag so viel kostet wie ein häufiger. Beim Prüfer schrumpfte die Ausgabeschicht von rund 152.000 auf rund 65.000 Zeilen.
So funktioniert VocabX
Bestehende Ansätze wie Fast Vocabulary Transfer (FVT), Multi-Word Tokenization (MWT) und das In-Place-BPE von Liquid AI verringern laut den Autoren bereits die Fragmentierung, wählen Tokens aber nach Häufigkeit statt nach Kosten aus und arbeiten nur auf einer einzigen Ebene. VocabX ändert das auf drei Arten.
- Auswahl nach Kosten. Jedes eingesparte Token wird mit dem Preis des Feldes multipliziert, in dem es vorkommt: Systemprompt, Nutzernachricht oder Modellantwort. Beim Prüfer ist ein in der Antwort eingespartes Token 7,4-mal so viel wert wie eines in der Eingabe.
- Zwei Ebenen nach einem Kriterium. Auf der Subwort-Ebene baut VocabX neu auf, wie Fachwörter zerlegt werden. Auf der Multiwort-Ebene macht es aus wiederkehrenden Abschnitten, von kurzen Wendungen bis zu ganzen Zeilen und JSON-Hüllen, einzelne Makro-Tokens. Jede Ebene hat ihr eigenes Budget.
- Schätzen, was die Stichprobe nicht zeigt. Eine Auswahl nach Kosten setzt voraus zu wissen, wie viel jeder Kandidat nach früheren Entscheidungen noch einspart. Der Quelltext bricht bei der Beschreibung dieses dritten Schritts ab.
Um wiederkehrende Abschnitte zu finden, setzt das Team fünf Miner ein, die jeweils auf eine Art von Wiederholung spezialisiert sind: lange Wörter, ganze Zeilen, Wendungen, vollständige Sätze sowie Strukturen mit Satzzeichen wie JSON und Tags. Gemittelt über acht Korpora trug der letzte den größten Anteil bei, bei Code allein 17,5 Punkte. Ohne alle fünf ginge die Tokenreduktion beim Prüfer um 55,6 Punkte zurück.
Was das für spezialisierte Modelle bedeutet
Der Beitrag argumentiert, dass der Tokenizer, der meist als feste Eigenschaft eines Basismodells gilt, bei einem auf eine einzige Domäne spezialisierten Modell einer der größten Kostenhebel sein kann und dass er vor jedem Trainingsschritt festgelegt wird. Dieselbe Logik gelte nach Angaben der Autoren auch für Verträge mit Standardklauseln oder für Code mit wiederkehrenden Bezeichnern.
Teams, die offene Modelle wie Qwen und Gemma für enge Aufgaben feinabstimmen, könnten Einsparungen daher eher im Vokabular als in der Modellgröße finden. Die 77 Prozent stammen allerdings aus einem einzigen Produktivsystem und einem Paper, das noch begutachtet wird, sodass die Ergebnisse anderswo abweichen können.