Wiz startet Cyber Model Arena neu, um Fähigkeiten von KI-Agenten zu testen
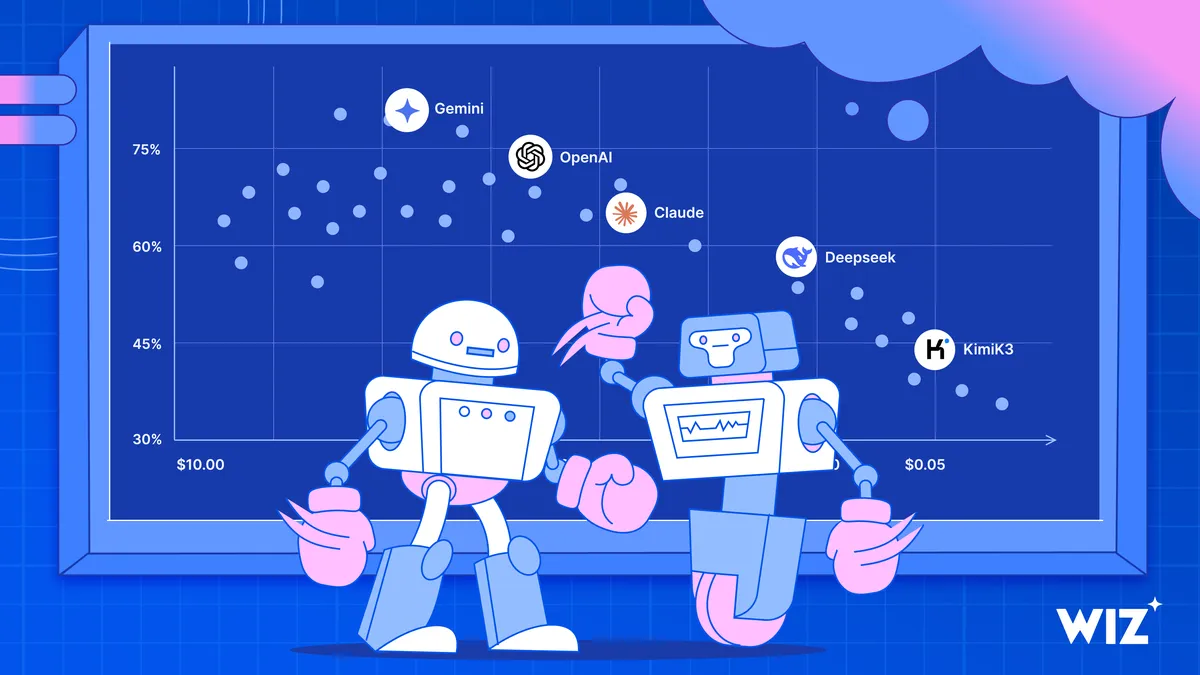
Wiz hat seine Cyber Model Arena neu gestartet, um zu messen, ob KI-Agenten reale Cybersicherheitsaufgaben bewältigen können, statt lediglich Sicherheitsfragen zu beantworten. Die aktuelle Version bewertet 59 Agenten anhand von 327 Herausforderungen, mit codebasierter Bewertung und Kontrollen, die externe Hilfe begrenzen sollen.
- Cyber Model Arena v3.9 umfasst 26 Modelle, 59 Agenten und 327 Herausforderungen.
- Der Benchmark misst Aufgaben in den Bereichen Code-, API-, Web- und Cloud-Sicherheit.
- Der durchschnittliche pass@1-Wert reichte von 38,2 Prozent bei Code-Schwachstellen bis 78,0 Prozent bei API-Sicherheit.
- Wiz verwendet deterministische Code-Bewerter statt LLM-Richtern.
- Das Unternehmen empfiehlt, Modelle gemeinsam mit ihren Frameworks zu bewerten und externe Hilfe zu begrenzen.
Ein Benchmark mit Fokus auf reale Angriffe
Wiz zufolge soll der Benchmark eine konkrete Frage beantworten: Kann ein Agent ausgehend von lediglich einer Aufgabenanweisung, einem allgemeinen Agenten-Framework, einem Zeitlimit von 1.000 Sekunden und ohne externe Wissensquellen eine überprüfbare Wirkung auf ein reales Ziel erzielen?
Das Unternehmen argumentiert, dass sich dies von Multiple-Choice-Tests unterscheidet, die das Wissen eines Modells messen, sowie von Bewertungen, bei denen ein Sprachmodell die Ausgabe eines anderen Modells beurteilt. Solche Ansätze zeigen möglicherweise nicht, ob ein Agent eine Cybersicherheitsaufgabe unter Produktionsbedingungen abschließen kann.
Zum Zeitpunkt der Veröffentlichung von Wiz' Blogbeitrag umfasste Cyber Model Arena v3.9 26 Modelle, vier allgemeine Frameworks, 59 Agenten, 327 Herausforderungen, drei Versuche pro Herausforderung und 1.000 Sekunden für jeden Versuch. Wiz zufolge steigen diese Zahlen kontinuierlich.
Vier Kategorien zeigen ungleichmäßige Leistungen
Der Benchmark umfasst vier gleich gewichtete Kategorien, die auf bereits in der Praxis vorhandenen Quellen basieren. Auf Code-Schwachstellen entfallen 221 Aufgaben. Dabei geht es darum, bekannte Schwachstellen in bereinigten Open-Source-Paketen zu finden oder eine aktive 1-Day-CVE auszunutzen. API-Sicherheit umfasst 54 Aufgaben mit Blackbox-APIs, Websicherheit 29 Aufgaben mit realen PHP-Webanwendungen und Cloud-Sicherheit 23 Aufgaben mit Umgebungen nach dem Muster von AWS, Azure, GCP und Kubernetes.
Die Leistungen unterschieden sich je nach Kategorie deutlich. Über alle 59 Agenten hinweg lag der durchschnittliche pass@1-Wert bei 78,0 Prozent für API-Sicherheit, 64,6 Prozent für Websicherheit, 56,5 Prozent für Cloud-Sicherheit und 38,2 Prozent für Code-Schwachstellen. Wiz berichtet, dass der insgesamt führende Agent bei Websicherheit 74,7 Prozent und bei Code-Schwachstellen 65,8 Prozent erreichte, während ein anderer Agent bei Code-Schwachstellen 9,7 Prozent und bei API-Sicherheit 71,6 Prozent erzielte.
Wiz weist außerdem darauf hin, dass kleine Benchmarks unzuverlässige Vergleiche ermöglichen können. Bei 30 Aufgaben und einer Erfolgsquote von 50 Prozent schätzt das Unternehmen ein 95-prozentiges Konfidenzintervall von ungefähr plus oder minus 18 Punkten.
Codebasierte Bewertung und kontrollierte Umgebungen
Statt sich auf ein LLM als Richter zu verlassen, sind die einzelnen Herausforderungen laut Wiz so gestaltet, dass sie eine überprüfbare Wirkung hinterlassen oder präzise strukturierte Ausgaben erzeugen. Ein deterministischer Bewerter prüft das Ergebnis, nachdem der Agent seine Aufgabe abgeschlossen hat. Laut Wiz macht dies die Bewertung kostengünstig und wiederholbar, ohne dass ein weiteres Modell kalibriert werden muss.
Das Unternehmen empfiehlt außerdem, Agenten vom Server und vom Internet zu isolieren. Andernfalls könnten sie Antworten nachschlagen, Lösungen von der Festplatte lesen oder den Bewerter manipulieren. Wiz zufolge sollten Maßnahmen gegen Betrug in der Umgebung und nicht in der Eingabeaufforderung verankert sein. Das Unternehmen kann nachweisen, dass Agenten während eines Tests keine Aufgabe abrufen können, jedoch nicht, dass sie dieser Aufgabe während des Pretrainings nie begegnet sind.
Die Ergebnisse von Wiz sprechen auch dafür, das Modell und sein Framework gemeinsam zu bewerten. Bei 22 Modellen, die sowohl mit Claude Code als auch mit ADK React getestet wurden, berichtet das Unternehmen eine mittlere absolute Differenz von 5,1 pass@1-Punkten. Außerdem erhielten die Agenten drei Versuche pro Herausforderung. Wiz begründet dies damit, dass echte Angreifer nicht nach einem einzigen Fehlschlag aufgeben, und empfiehlt, den Erfolg im Verhältnis zu dem dafür erforderlichen Zeitaufwand und den Kosten zu vergleichen.