AI21 Labs startet Teel, eine Python-Laufzeitumgebung für schnellere Agenten-Workflows
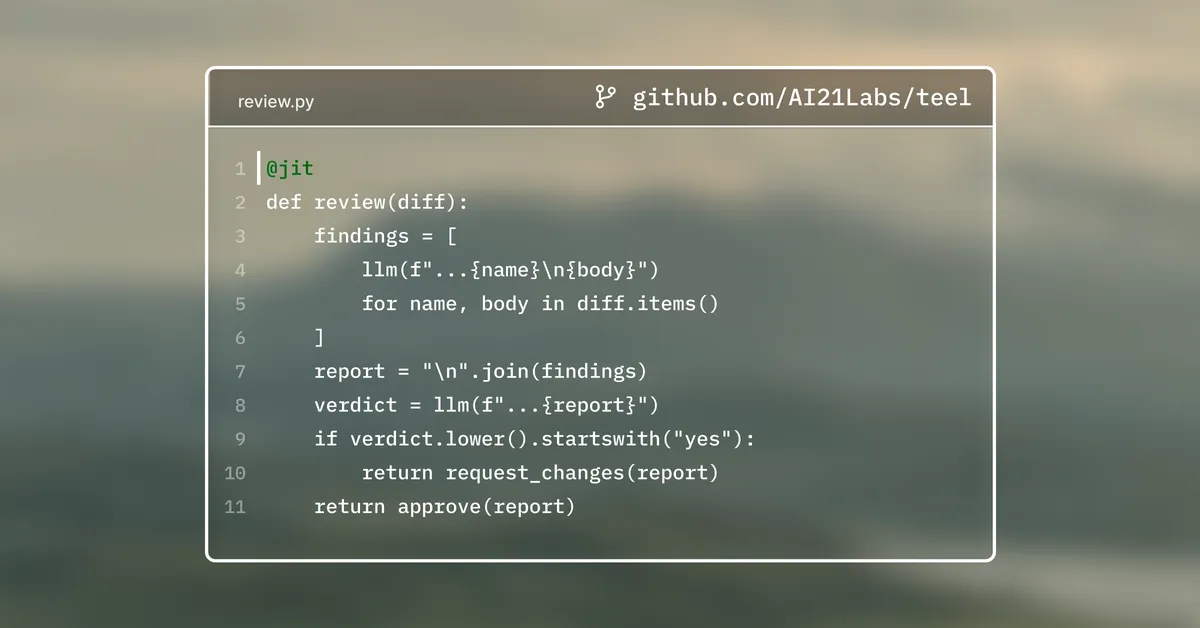
AI21 Labs hat Teel vorgestellt, eine quelloffene Python-Laufzeitumgebung, die unabhängige, E/A-gebundene Aufrufe in gewöhnlichem sequenziellem Python-Code überlappt. Nach Angaben des Unternehmens verkürzte Teel die Laufzeit bei einem unveränderten Tree-of-Thoughts-Workload im Durchschnitt um 83 %.
- Teel ist eine quelloffene Python-Laufzeitumgebung von AI21 Labs.
- Die Laufzeitumgebung überlappt unabhängige, E/A-gebundene Aufrufe in sequenziellem Code.
- AI21 meldet eine durchschnittliche Laufzeitverkürzung von 83 % bei Tree of Thoughts.
- Teel setzt derzeit exakt Python 3.12.13 voraus.
- Das Projekt verwendet die Dekoratoren @cacheable, @jit und optional @inline.
Eine Laufzeitumgebung, die parallele Arbeit erkennt
Teel soll den Aufwand für Parallelitätslogik reduzieren, den Entwickler und KI-Agenten beim Erzeugen von Code schreiben müssen. Entwickler kennzeichnen aufwendige Funktionen mit @cacheable und Orchestrierungsfunktionen mit @jit. Innerhalb eines with Teel():-Kontexts liest die Laufzeitumgebung den Python-Bytecode einer Funktion vorausschauend und sucht nach Aufrufen, deren Argumente bereits bekannt sind.
Findet Teel einen unabhängigen Aufruf, startet die Laufzeitumgebung ihn in einem Hintergrund-Thread, bevor der Haupt-Thread diese Zeile erreicht. Der Ansatz ist für Workloads mit Modellaufrufen, Abrufen, Webanfragen, Tool-Aufrufen und Shell-Ausführung gedacht, bei denen ein großer Teil der verstrichenen Zeit mit dem Warten auf externe Systeme verbracht werden kann.
Nach Angaben von AI21 funktioniert Teel, ohne async, await, Futures oder gather vorauszusetzen. Außerhalb des Teel-Kontexts werden dekorierte Funktionen wie gewöhnliches Python ausgeführt.
Leistungsergebnisse aus zwei Agenten-Workloads
AI21 wandte Teel auf Princetons Implementierung von Tree of Thoughts für Game-of-24-Beispiele mit GPT-4 an, ohne das Repository zu bearbeiten. Nach Angaben des Unternehmens sank die durchschnittliche Laufzeit um 83 %, am unteren Ende von 148 s auf 24 s und am oberen Ende von 307 s auf 38 s. Der längste Lauf war damit 8,07-mal schneller.
In einem separaten Test forkte AI21 LangChains Deep Agents und ersetzte dessen asynchrone JavaScript-Ausführung durch synchron ausgeführtes Python unter Teel. Bei zehn gemischten Prompts für Websuche und LLMs meldet das Unternehmen eine durchschnittliche Laufzeit von 58 s, verglichen mit 71 s für asynchrones JavaScript und 150 s für denselben Python-Lauf in sequenzieller Ausführung. AI21 zufolge berücksichtigt der Vergleich Verteilungen generierter Programme, da derselbe Prompt jedes Mal einen anderen Code erzeugen kann.
AI21 beschreibt außerdem ein Beispiel für einen Agenten zur Codeprüfung. Die sequenzielle Version benötigte 7,1 s, eine manuell umgeschriebene asyncio-Version 3,0 s und der ursprüngliche Code mit Teels Dekoratoren 2,9 s. Nach Angaben des Unternehmens beginnen beide schnelleren Versionen mit möglichen Folgeaktionen, bevor ein Ergebnis vorliegt. Teel erkennt und verwaltet dieses Verhalten jedoch automatisch.
API und aktuelle Voraussetzungen
Teel bietet drei Dekoratoren und einen Context Manager. @cacheable kennzeichnet aufwendige, parallelisierbare Schritte und speichert Ergebnisse anhand eines Schlüssels zwischen, der aus json.dumps der Argumente erstellt wird. Daher sollten diese Argumente als JSON serialisierbar sein. @jit kennzeichnet Orchestrierungsfunktionen, die Teel analysieren kann, während der optionale Dekorator @inline kostengünstige Hilfsfunktionen markiert, die während des vorausschauenden Lesens ausgeführt werden können.
AI21 zufolge setzt Teel derzeit exakt Python 3.12.13 voraus. Das Projekt ist quelloffen. Das Unternehmen verweist Entwickler auf das Repository unter github.com/AI21Labs/teel. Für Nutzer, die Agenten entwickeln, besteht der genannte Vorteil darin, dass sich unabhängige Aufrufe durch das Kennzeichnen vorhandenen sequenziellen Codes parallel auffächern lassen, statt die Aufrufkette um asynchrone Funktionen herum neu zu schreiben.