Amazon skaliert synthetisches Training für Tabellendaten mit Mitra-v2
Amazon hat Mitra-v2 vorgestellt, ein Foundation-Modell für Tabellendaten, das fehlende Werte in unbekannten Tabellen für Klassifikations- und Regressionsaufgaben vorhersagen soll. Nach Angaben des Unternehmens führt das Modell den Bereich der Einzelmodelle im TabArena-Benchmark an, nachdem Umfang und Vielfalt der synthetischen Vortrainingsdaten erweitert wurden.
- Mitra-v2 unterstützt Klassifikation und Regression auf bislang unbekannten Tabellen.
- Für das synthetische Vortraining werden Tabellen mit zehnmal so vielen Zeilen und ungefähr dreimal so vielen Spalten wie bei Mitra-v1 verwendet.
- Amazon zufolge führt Mitra-v2 bei den 51 Datensätzen von TabArena das Feld der Einzelmodelle an.
- Das feinjustierte Mitra-v2 belegt auf der Regressionsrangliste von ScoringBench den ersten Platz.
- Die Modelle und der Code sind unter der Apache-2.0-Lizenz auf Hugging Face verfügbar.
Ein Foundation-Modell für Geschäftstabellen
Geschäftsdaten liegen häufig in Tabellen vor. Die Zeilen stehen dabei für Kunden, Transaktionen oder Interaktionen, während die Spalten deren Merkmale enthalten. Zu den typischen Aufgaben gehören die Vorhersage der Kundenbindung oder die Schätzung der künftigen Nachfrage. Herkömmliche Verfahren wie Gradient-Boosted Decision Trees erfordern in der Regel ein auf jede Tabelle zugeschnittenes Modell und eine entsprechende Verarbeitungspipeline.
Mitra-v2 soll diesen Aufwand reduzieren. Das Modell liest beschriftete Zeilen aus einer bislang unbekannten Tabelle ein und sagt die unbeschrifteten Zeilen mithilfe von In-Context-Learning voraus. Amazon zufolge unterstützt das Modell sowohl Klassifikation als auch Regression und wird von Amazon Connect Customer für Vorhersagen auf strukturierten Geschäfts- und Kundenerfahrungsdaten eingesetzt.
Nach Angaben von Amazon wurde Mitra-v2 vollständig auf synthetischen Tabellen vortrainiert. Der Trainingsprozess verwendet keine realen Daten, auch keine Kundendaten, und soll dem Modell allgemeine Beziehungen zwischen Spalten vermitteln, statt Informationen aus einem bestimmten Datensatz zu lernen.
Größere Tabellen und vielfältigere synthetische Daten
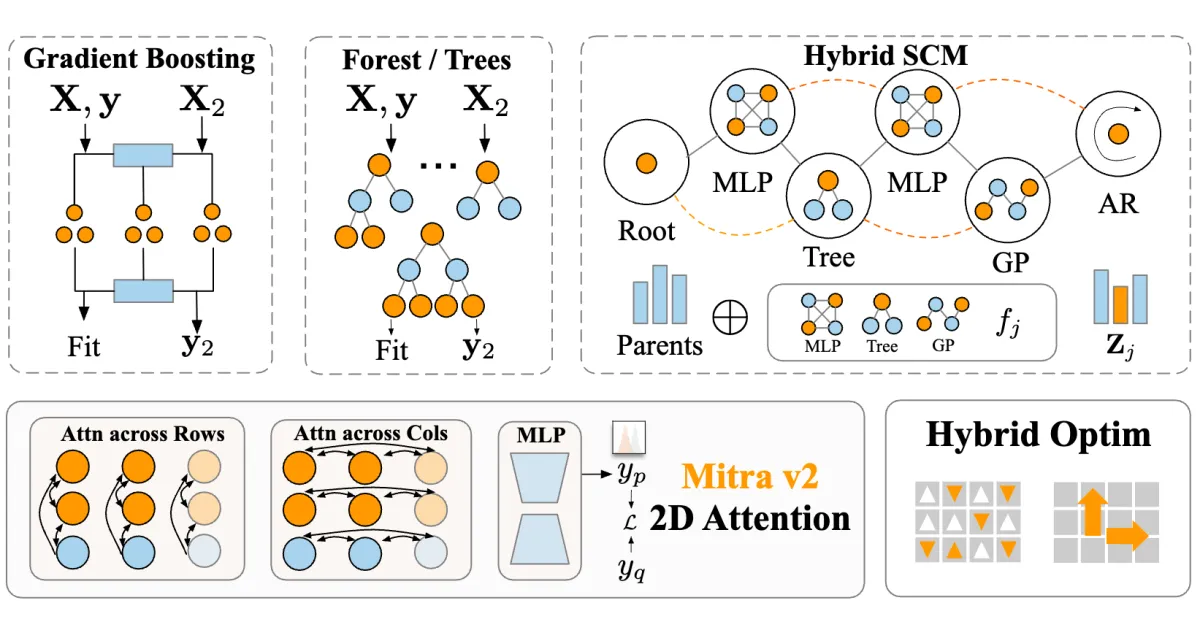
Das Modell behält die Transformer-Architektur von Mitra-v1 bei, die sowohl über die Zeilen als auch über die Spalten einer Tabelle hinweg Zusammenhänge berücksichtigt. Die wichtigste Änderung betrifft den Umfang der Trainingsbeispiele. Mitra-v2 wurde auf Tabellen mit zehnmal so vielen Zeilen und ungefähr dreimal so vielen Spalten wie bei Mitra-v1 vortrainiert.
Amazon hat außerdem ein hybrides strukturelles Kausalmodell ergänzt. Innerhalb eines synthetischen Kausalgraphen können Beziehungen zwischen Spalten durch ein kleines neuronales Netzwerk, einen Entscheidungsbaum, eine aus einem Gauß-Prozess abgeleitete glatte Funktion oder einen zeitabhängigen autoregressiven Prozess dargestellt werden. Ein hybrider Optimierer soll das Training über diese Mechanismen hinweg stabil halten.
Zwei schlanke Erweiterungen helfen dem Modell bei Aufgaben, die über die Grenzen des Vortrainings hinausgehen. Für sehr breite Tabellen kommt die Singulärwertzerlegung zum Einsatz, während ein hierarchischer Baum Vorhersagen für Klassifikationsprobleme mit mehr als 10 Klassen verfeinert. Standardmäßig wird das Modell für jede neue Tabelle kurz feinjustiert und bildet den Mittelwert der Vorhersagen von acht Kopien, ein Verfahren, das Amazon als Bagging bezeichnet. Das Unternehmen erklärt, dass dies zusätzlichen Rechenaufwand verursacht, aber die Genauigkeit verbessern und Kunden mehr Optionen bieten kann.
Benchmark-Ergebnisse und Verfügbarkeit
Im öffentlichen TabArena-Benchmark mit 51 realen Datensätzen führt Mitra-v2 laut Amazon das Feld der Einzelmodelle an. Auf 32 der 33 Datensätze, auf denen beide Modelle nativ ausgeführt wurden, erzielte es ein besseres Ergebnis als Mitra-v1. Außerdem absolvierte es alle 51 Datensätze innerhalb des einstündigen Budgets des Benchmarks. Amazon zufolge schaffte es Mitra-v1 nicht, mehr als ein Drittel davon vollständig zu bearbeiten.
Im unabhängigen TALENT-Benchmark mit ungefähr 300 Datensätzen gehört Mitra-v2 zu den führenden Methoden und ist besonders stark bei Klassifikationsaufgaben mit mehr als 10 Klassen. Bei Regressionen sagt das Modell neben einem Punktschätzer auch eine Bandbreite wahrscheinlicher Werte voraus. Das feinjustierte Mitra-v2 belegt bei ScoringBench den ersten Platz. Der Benchmark bewertet die Genauigkeit und Kalibrierung von Vorhersageintervallen.
Amazon hat feinjustierte Versionen für Klassifikation und Regression sowie Code für Inferenz und Feinjustierung unter der Apache-2.0-Lizenz auf Hugging Face veröffentlicht. Damit erhalten Forschende und Praktiker Zugriff auf das Modell, um es mit eigenen Tabellen zu testen. Die Ergebnisse von Amazon stützen zugleich die Aussage des Unternehmens, dass ein breiteres synthetisches Vortraining Tabular-Foundation-Modelle verbessern kann, ohne das Netzwerk tiefer zu machen.
Amazon Science: Mitra-v2: Scaling synthetic pretraining for tabular foundation models