Amazons Priming-Methode macht aus Transformern Hybridmodelle für weniger als 0,5 Prozent der Pretraining-Kosten
Forscher von Amazon Web Services haben mit Priming eine Methode vorgestellt, die von vortrainierten Transformer-Gewichten ausgeht, um hybride Architekturen zu bauen. Nach Angaben des Teams senkt sie die Pretraining-Kosten um mehr als 99 Prozent. Der Ansatz ist im Paper "Priming: Hybrid state space models from pre-trained Transformers" beschrieben.
- AWS-Forscher stellen Priming vor, das vortrainierte Transformer-Gewichte wiederverwendet, um hybride State-Space-Modelle zu bauen.
- Laut den Autoren senkt es die Pretraining-Kosten um mehr als 99 Prozent und verbraucht weniger als 0,5 Prozent des Pretraining-Token-Budgets des Ausgangsmodells.
- Gated KalmaNet schnitt von den drei getesteten SSMs am besten ab, vor Gated DeltaNet und Mamba-2.
- Ein GKA-Hybrid mit 32 Milliarden Parametern erreicht in Reasoning-Benchmarks das Niveau seines Ausgangs-Transformers und dekodiert bei 128.000 Token Kontext bis zu doppelt so schnell.
- Modelle mit acht und 32 Milliarden Parametern, Code, Kernel und ein vLLM-Plugin erscheinen unter Apache 2.0.
Warum sich Hybridarchitekturen bisher schwer untersuchen ließen
Die Transformer-Architektur verursacht Speicherkosten, die mit der Zahl der verarbeiteten Token wachsen. Je länger KI-Agenten laufen und je längere Argumentationsketten sie durchlaufen, desto stärker steigen diese Kosten, heißt es im Beitrag von Amazon Science.
Hybridarchitekturen versuchen, Speicherbedarf, Geschwindigkeit und Qualität auszubalancieren, indem sie mehrere Verfahren kombinieren. Dazu zählen Sparse Attention, die eine Teilmenge vergangener Token auswählt, Sliding-Window-Attention (SWA), die nur die jüngsten Token behält, und State Space Models (SSMs), die die gesamte Historie in einem Zustand fester Größe komprimieren.
Bislang bedeutete die Erkundung dieses Designraums, jede neue Architektur von Grund auf zu trainieren, mit Billionen Token und Hunderttausenden GPU-Stunden. Kontrollierte Vergleiche zwischen Hybriden seien dadurch extrem teuer geworden, schreibt das Team.
So funktioniert Priming
Attention verleiht Transformern, was die Autoren ein eidetisches Gedächtnis nennen: wortgetreues Erinnern an jedes vergangene Token, abgelegt in einem wachsenden KV-Cache. Nicht jede Attention-Schicht braucht das. Manche leisten Retrieval über Zehntausende Token hinweg, andere arbeiten lokal und kommen mit einer kompakten Zusammenfassung fester Größe aus, die die Autoren als verblassendes Gedächtnis (fading memory) bezeichnen. Hybridmodelle setzen Attention-Schichten dort ein, wo globaler Abruf zählt, und State-Space-Schichten für den Rest.
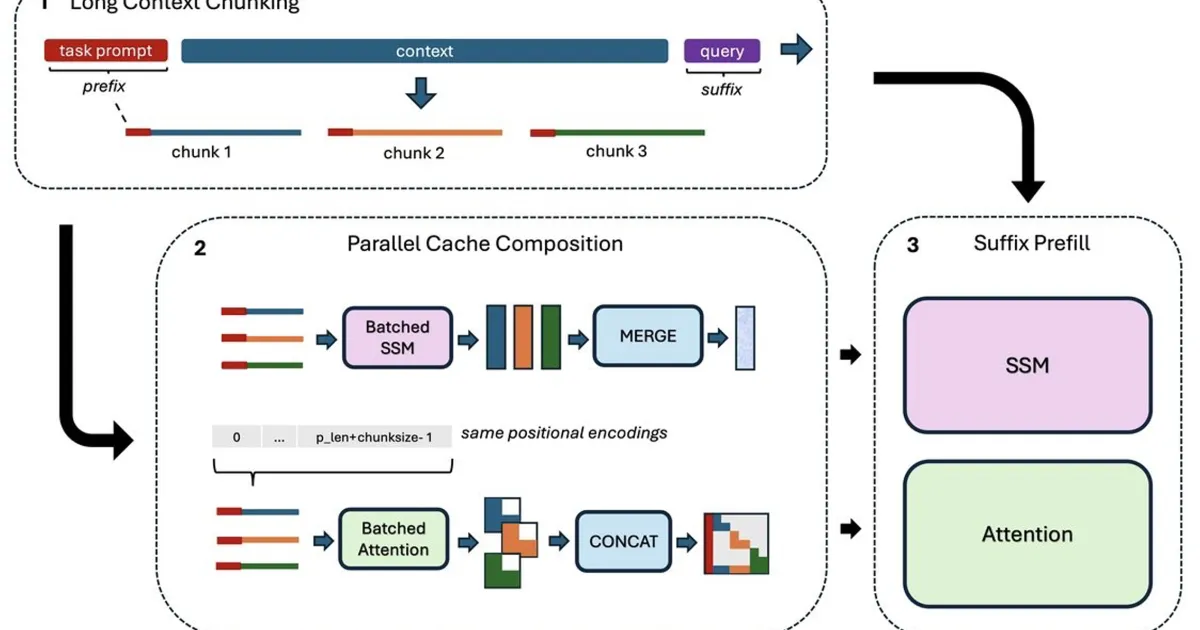
Priming beruht auf der Beobachtung, dass ein Transformer ein Spezialfall einer State-Space-Realisierung ist. Kann ein SSM eine Mixing-Matrix erzeugen, die der einer Attention-Schicht nahe genug kommt, lassen sich die Query-, Key- und Value-Projektionen des Ausgangs-Transformers als Eingangsprojektionen des SSM wiederverwenden. Gelernt werden müssen dann nur noch die SSM-spezifischen Parameter.
Um zu entscheiden, welche Schichten sich umwandeln lassen, ersetzt das Team jede Schicht durch SWA und misst die Verschlechterung. Schichten, die den Austausch verkraften, kommen für die SSM-Umwandlung infrage. Die Pipeline besteht aus drei Stufen:
- Schichtauswahl: Schichten identifizieren, die sich in einen Zustand fester Größe komprimieren lassen, und die übrigen als Attention beibehalten.
- Gewichtstransfer und Angleichung: SSM-Schichten aus den entsprechenden Attention-Gewichten initialisieren und anschließend in einem kurzen Distillationsprozess jedes SSM an die Schicht angleichen, die es ersetzt.
- End-to-End-Anpassung: das gesamte Hybridmodell per Next-Token-Prediction feinabstimmen.
Laut den Autoren verbraucht die gesamte Pipeline weniger als 0,5 Prozent des Pretraining-Token-Budgets des Ausgangsmodells. Sie funktioniere über Transformer-Familien (Qwen, Llama, Mistral), Modellklassen (dicht oder MoE) und Größen von acht Milliarden bis 32 Milliarden Parametern und mehr hinweg.
Ergebnisse des Vergleichs
Das Paper vergleicht Hybride, die mit drei State Space Models gebaut wurden: Gated KalmaNet (GKA), Gated DeltaNet (GDN) und Mamba-2. Unter kontrollierten Bedingungen schneidet GKA nach Angaben des Teams am besten ab, gefolgt von GDN und dann Mamba-2. Zudem biete GKA eine Inferenzberechnung variabler Länge ohne erneutes Training und gebe Nutzern so direkte Kontrolle über ihre Position auf der Grenzlinie zwischen Geschwindigkeit und Genauigkeit, so die Autoren.
Die Forscher berichten außerdem, dass SSMs durchweg besser abschneiden als SWA, selbst wenn SWA das doppelte Speicherbudget erhält. Ihr Fazit: Eine gute verlustbehaftete Zusammenfassung von allem schlägt eine perfekte Aufzeichnung der jüngsten Vergangenheit.
Bei der Geschwindigkeit erreicht ein GKA-basierter Hybrid mit 32 Milliarden Parametern in Reasoning-Benchmarks das Niveau seines Ausgangs-Transformers und dekodiert bei 128.000 Token Kontext bis zu doppelt so schnell. Nach Angaben der Autoren kommt er in nur zwei Dritteln der Echtzeit zu korrekten Antworten.
Offene Veröffentlichung und Bedeutung
Zur Förderung weiterer Forschung hat das Team eine Sammlung geprimter Hybridmodelle mit acht und 32 Milliarden Parametern für Long-Context-Reasoning und Instruction Following veröffentlicht. Die Veröffentlichung umfasst außerdem Trainingscode, optimierte Kernel und ein vLLM-Serving-Plugin, alles unter der Apache-2.0-Lizenz.
Für Modellentwickler ändert sich praktisch, dass Fragen, die zuvor im großen Maßstab zu teuer zu testen waren, nun greifbar werden: Welche Attention-Schichten lassen sich ersetzen, wie viele können entfallen, ohne die Qualität zu mindern, welche State-Space-Schicht funktioniert am besten und wie sieht der Zielkonflikt zwischen Geschwindigkeit und Genauigkeit aus? Da jede Variante von derselben vortrainierten Initialisierung ausgeht und nur minimales Training benötigt, lassen sich Schichttyp, Hybridverhältnis und Schichtplatzierung nach Ansicht der Autoren nun günstig und systematisch erkunden.
Amazon Science: Can we change an AI model’s architecture without retraining it from scratch?