vLLM: Abgestimmte Kernel machen asynchrones RL bei Lag 64 stabil
Laut vLLM beseitigt die Abstimmung der numerischen Kernel für Rollout und Training eine Ursache für Instabilität beim asynchronen Reinforcement Learning. Das REINFORCE-Zero-Rezept nutzt ungeclippte Importance-Sampling-Gewichte, um den verbleibenden Gewichtslag zu korrigieren, und trainierte in einem agentischen Tool-Use-Szenario bei einem Policy-Lag von 64.
- REINFORCE Zero stimmt Rollout- und Learner-Kernel ab, bevor Importance Sampling angewandt wird.
- Die Methode trainierte in einem Qwen3-4B-Tool-Use-Setup bei einem Policy-Lag von 64.
- vLLM meldet einen 2,40-fachen Durchsatz bei den Trainingsschritten gegenüber synchronem Training.
- Importance Sampling mit Standard-Kerneln zeigte ein steigendes KL und einen sinkenden Online-AIME24-pass@1-Wert.
- Zero Mismatch umfasst inzwischen unter anderem DeepSeek-V4.1-Flash und Kimi K3.1.
Asynchrones Training hat zwei verschiedene Lücken
Asynchrones Reinforcement Learning ermöglicht es, Rollout und Training gleichzeitig auszuführen. Das kann den Durchsatz erhöhen, allerdings aktualisiert der Learner Samples, die mit älteren Modellgewichten erzeugt wurden. In den REINFORCE-Zero-Experimenten erreichte der Policy-Lag bei Aufgaben zum mathematischen Schlussfolgern 2 und 8, beim agentischen Tool-Use jedoch 64.
vLLM unterteilt die daraus entstehende Logprob-Differenz in Gewichtslag und Kernel-Abweichung. Der Gewichtslag vergleicht verschiedene Policy-Versionen und verändert sich über die jüngsten Updates hinweg gleichmäßig. Eine Kernel-Abweichung entsteht, wenn Rollout-Engine und Learner für dieselben Gewichte und Tokens unterschiedliche Werte erzeugen. Laut vLLM schwankt diese zweite Lücke abhängig von Batch-Zusammensetzung und numerischer Ausführung. Importance Sampling allein beseitigt sie nicht.
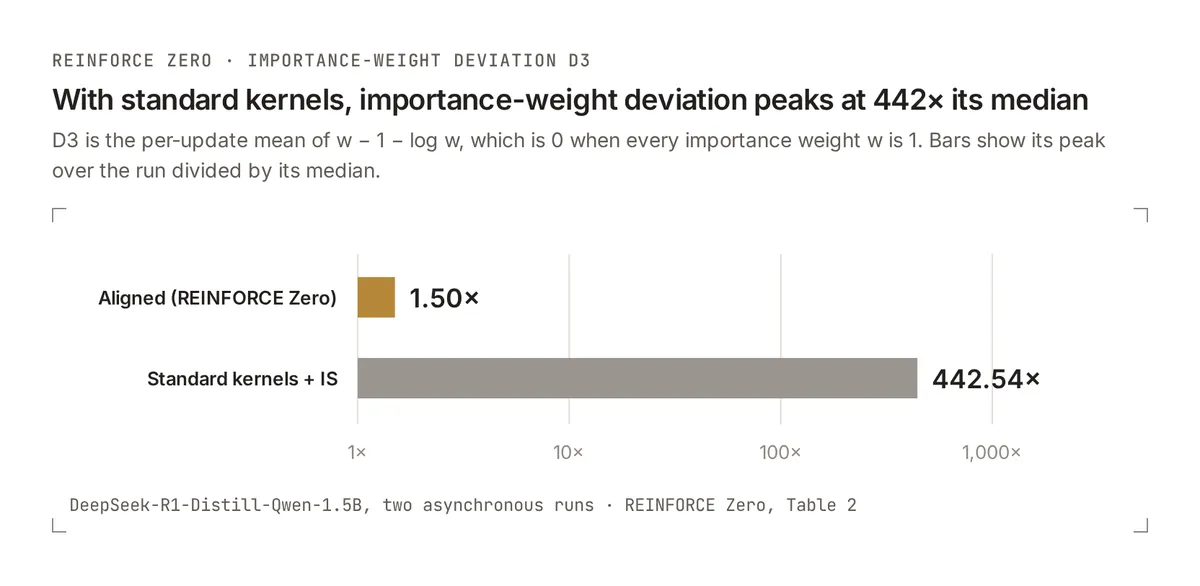
In den genannten Experimenten erzeugten abgestimmte Kernel eine Spitze der Abweichung der Importance-Gewichte vom 1,50-Fachen des Medians, verglichen mit dem 442,54-Fachen bei Standard-Kerneln. Die Zahlen stammen aus dem REINFORCE-Zero-Paper von NVIDIA Research und Inferact.
REINFORCE Zero beseitigt zuerst die Abweichung
Das Rezept besteht aus drei Teilen: Rollout- und Learner-Kernel werden abgestimmt, anschließend wird tokenbasiertes Importance Sampling ohne Clipping angewandt und schließlich einfaches REINFORCE optimiert. Der Rollout zeichnet die Logprob jedes erzeugten Tokens auf, während der Learner seine eigene Wahrscheinlichkeit durch den aufgezeichneten Wert teilt.
Jede Antwort erhält einen Vorteil, der ihrer Belohnung minus der durchschnittlichen Belohnung ihrer Gruppe entspricht. Die Tokens werden innerhalb einer Antwort gemittelt. Die Methode verwendet weder ein Wertmodell noch Ablehnungsschranken.
vLLM zufolge kann das Clipping der Importance-Gewichte einen Bias einführen. Sobald der Kernel-Term entfernt ist, kann ungeclipped Importance Sampling nach Ansicht des Unternehmens den verbleibenden Gewichtslag korrigieren und zugleich die großen Schwankungen vermeiden, die bei Standard-Kerneln auftreten.
Gemeldete Ergebnisse umfassen 2,40-fach höheren Durchsatz
Mit abgestimmten Kerneln blieb REINFORCE Zero im genannten 1.5B-Reasoning-Experiment über 20.000 Updates hinweg stabil. Bei einem Policy-Lag von 64 lernte ein Qwen3-4B-Setup mit Python-Tools und einem 16K-Kontext über 5.000 Updates weiter. Die durchschnittliche Belohnung stieg von 0.287 in den ersten 100 Updates auf etwa 0.78.
Über 16 GPUs und 12.000 Updates hinweg meldet vLLM einen 2,40-fachen Durchsatz bei den Trainingsschritten gegenüber synchronem Training mit abgestimmten Kerneln. Die angegebenen Laufzeiten betrugen 68.55 beziehungsweise 164.77 Stunden. In einem weiteren Experiment verbesserte ein Qwen3-30B-A3B-Setup mit Tools den Makro-pass@1-Wert in 3.000 Updates von 31.29% auf 71.55%.
Im Gegensatz dazu stieg bei asynchronem Importance Sampling mit Standard-Kerneln das Rollout-zu-Learner-KL zwischen den ersten und letzten 1.000 Updates um das 83.33-Fache. Online-AIME24-pass@1 sank von 34.27% auf 13.96%, während die größte Gradientennorm vor dem Clipping 38.27 erreichte, verglichen mit 0.0555 bei abgestimmten Kerneln.
Zero Mismatch wird auf neuere Modelle ausgeweitet
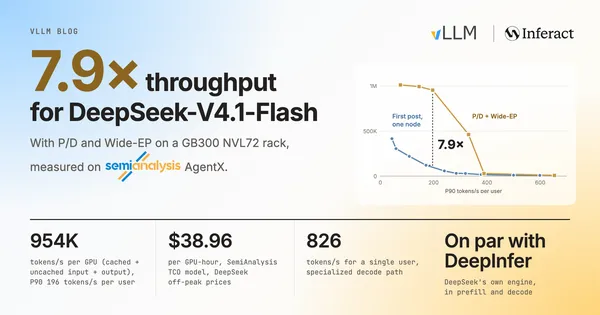
vLLM zufolge umfasst die Zero-Mismatch-Arbeit inzwischen DeepSeek-V4.1-Flash, Kimi K3.1 am Tag 0 sowie DeepSeek-V4-Flash und Kimi K3.1 auf AMD MI355X. Für DeepSeek-V4.1-Flash nutzt der konsistente Pfad FP8- und MXFP4-Gewichte, MegaMoE, Sparse Attention mit einem gleitenden Fenster, DSpark Speculative Decoding und CUDA Graphs. Laut vLLM lag der DAPO-Rollout-Schritt höchstens 10% hinter der schnellen Baseline.
Das Unternehmen erklärt, der Abstimmungscode und zugehörige Materialien seien unter Inferact/zero-mismatch-rl verfügbar. Die Ergebnisse legen nahe, dass Nutzer von asynchronem RL einen höheren Trainingsdurchsatz anstreben können, ohne zusätzliche Sample-Ablehnungsschranken einzuführen, sofern Rollout- und Learner-Berechnungen aufeinander abgestimmt sind. vLLM berichtet allerdings auch von einem Nachteil: Auf OSWorld betrug die durchschnittliche Schrittzeit mit abgestimmten Kerneln 944.25 Sekunden, verglichen mit 884.17 Sekunden bei Importance Sampling mit Standard-Kerneln und einer Sequenzschranke.