Inferact
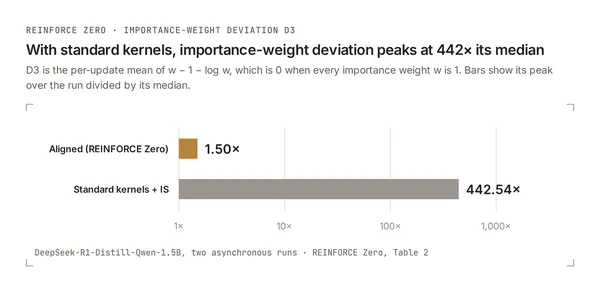
vLLM: Abgestimmte Kernel machen asynchrones RL bei Lag 64 stabil
Laut vLLM beseitigt die Abstimmung der numerischen Kernel für Rollout und Training eine Ursache für Instabilität beim asynchronen Reinforcement Learning. Das…
Google bringt PyTorch-native Inferenz-Engines für vLLM und SGLang auf die TPU
Google hat native PyTorch-Backends für vLLM und SGLang auf der TPU gestartet, die auf einer neuen Laufzeitumgebung namens TorchTPU aufbauen. Laut Google wurden die…
vLLM TorchTPU bringt vLLM-Modellbetrieb auf Google Cloud TPUs
Das vLLM-Projekt hat vLLM TorchTPU (vllm-torchtpu) veröffentlicht, ein neues Backend, das vLLM auf Google Cloud TPUs ausführt. Laut Projekt lassen sich die meisten…