vLLM erreicht 954.000 Tokens pro Sekunde und GPU mit DeepSeek-V4.1-Flash auf GB300 NVL72
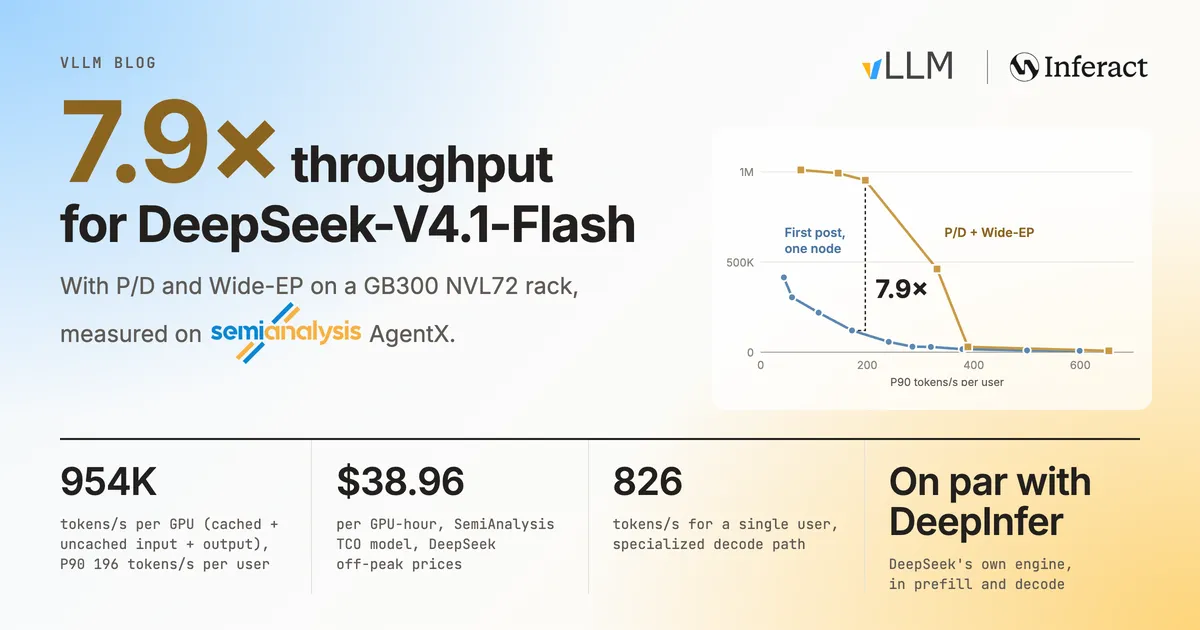
Das vLLM-Team berichtet, dass seine Engine mit P/D-Disaggregation und Wide-EP auf einem NVIDIA-GB300-NVL72-Rack im SemiAnalysis-Benchmark AgentX DeepSeek-V4.1-Flash mit 954K Tokens pro Sekunde und GPU bereitstellt. Laut vLLM liegt der Decode-Durchsatz über Batch-Größen von 8 bis 256 hinweg höchstens 6 % unter dem von DeepInfer, der hauseigenen Engine von DeepSeek.
- vLLM meldet 954K Tokens pro Sekunde und GPU auf einem GB300-NVL72-Rack bei SemiAnalysis AgentX, bei einem P90 von 196 Tokens/s pro Nutzer.
- Das ist das 7,9-Fache des Einzelknoten-Ergebnisses aus dem ersten vLLM-Beitrag; die Kosten betragen 38,96 US-Dollar pro GPU-Stunde zu DeepSeeks Off-Peak-Preisen.
- Der Decode-Durchsatz liegt laut vLLM über Batch-Größen von 8 bis 256 innerhalb von 6 % von DeepInfer.
- Einen Prefill-Geschwindigkeitsvorteil gegenüber DeepInfer behauptet vLLM nicht, da sich die Testaufbauten unterscheiden.
- Ein spezialisierter Decode-Pfad erreicht 826 Tokens/s für einen einzelnen Nutzer.
Die wichtigsten Ergebnisse auf GB300 NVL72
In einem Beitrag vom 23. Oktober 2026 gibt vLLM an, auf einem einzelnen NVIDIA-GB300-NVL72-Rack bei SemiAnalysis AgentX 954K Tokens pro Sekunde und GPU zu erreichen, bei einem P90 von 196 Tokens pro Sekunde und Nutzer. Das ist das 7,9-Fache des Einzelknoten-Ergebnisses aus dem ersten Beitrag des Teams. Zudem nennt das Team Kosten von 38,96 US-Dollar pro GPU-Stunde zu den Off-Peak-Preisen von DeepSeek.
Ein spezialisierter Decode-Pfad erreicht laut vLLM 826 Tokens pro Sekunde für einen einzelnen Nutzer. In den Durchsatz des Benchmarks fließen gecachte Eingabe-Tokens, nicht gecachte Eingabe-Tokens und Ausgabe-Tokens ein.
Vergleich mit DeepInfer
DeepInfer ist die hauseigene Inferenz-Engine von DeepSeek für DeepSeek-V4.1-Flash. vLLM beschreibt sie als in derselben Woche veröffentlichte Offline-Engine mit publizierten Prefill- und Decode-Kurven und betrachtet sie als die relevanteste Referenz für das Modell.
Decode. Mit der Decode-Konfiguration von DeepSeek (131K Kontext, nextn=3) liegt vLLM auf GB200 laut dem Beitrag über Batch-Größen von 8 bis 256 hinweg innerhalb von 6 % der veröffentlichten DeepInfer-Ergebnisse.
Prefill. Hier unterscheiden sich die Setups. Die veröffentlichte DeepInfer-Kurve nutzt EP4DP4 mit 32 redundanten Experten und einem begrenzten Replay von 140 Tokens, auf Hardware, die das Diagramm nicht nennt. Der Lauf von vLLM verwendet DEP2 auf GB300 ohne redundante Experten, ein Replay von 128 Tokens und eigene Prompts. Deshalb versteht vLLM die Differenz nicht als Geschwindigkeitsvorteil einer Engine gegenüber der anderen, sondern lediglich als Beleg dafür, dass der eigene DEP2-Prefill im gesamten veröffentlichten Bereich der DeepInfer-Kurve folgt.
Die Nähe führt das Team auf eine gemeinsame Herkunft zurück: DeepInfer wurde ursprünglich auf Basis von vLLM entwickelt, und vLLM hat fortlaufend Kernel aus den Bibliotheken von DeepSeek integriert, darunter MegaAttn, MegaMoE und Mega-mHC. Anders als DeepInfer, das ein einzelnes Modell im Offline-Modus bedient, stellt derselbe vLLM-Build das Modell laut Beitrag auch online über ein komplettes NVL72-Rack bereit.
Was das Modelldesign für das Serving bedeutet
Vor der Optimierung hat vLLM die Architektur des Modells vermessen und mehrere Schlüsse gezogen:
- Der globale KV-Cache benötigt dank schichtübergreifendem KV-Sharing und FP4-Kompression nur 890 Bytes pro Token.
- Decode ist selbst bei langem Kontext MoE-limitiert. Bei DEP4-Decoding mit 128K Kontext und 64 Anfragen pro Rank entfallen 62 % des Ziel-Schritts auf MoE, auf Attention und Indexer zusammen 13 %.
- Die Decode-Zeit wächst kaum mit dem Kontext. Bei DEP32 auf GB300 erhöht der Sprung von 128K auf 855K die Decode-Latenz des Zielmodells um 0,6 ms (+7 %), von 8,93 ms auf 9,53 ms.
Daraus folgert das Team, dass Prefill mit einer kleinen DEP-Größe laufen sollte, dass die KV-Kapazität die Batch-Größe selten begrenzt und dass Wide-EP für Decode wirksam ist, weil es die dominanten Kosten beim Lesen der MoE-Gewichte senkt. Auch das Load Balancing beim Decode lässt sich vereinfachen: Es genügt eine Least-Load-Verteilung nach Anzahl der Anfragen pro Rank.
Prefill-Optimierungen und Messmethode
In einem reinen AgentX-Prefill-Lauf mit Parallelität 256 erreichte DEP4 83 % des Durchsatzes pro GPU von DEP2 (53,3K gegenüber 64,4K Tokens/s). Mirror- und Lag-Replays zeigten, dass DEP4 durch DP-Ungleichgewicht 13,6 % Durchsatz verliert, DEP2 nur 5,9 %. Deshalb ist DEP2 bei vLLM die Standardeinstellung für Prefill.
Der Beitrag nennt außerdem Korrekturen für Engpässe, die mit der Kontextlänge wachsen. Auf zwei GB300-GPUs dauert ein Prefill von 8K Tokens ohne Vorkontext 87,9 ms, mit 512K gecachtem Kontext dagegen 189,4 ms. Die Ausweitung des begrenzten SWA-Replays bis Layer 20 (#59894) steigert den Prefill-Durchsatz bei 32K neuen Tokens um 19,9 %, mit Zuwächsen von 10,1 % bei 4K bis 23,1 % bei 64K. Der Einsatz von 2-MB-Seiten für gemeinsam genutzte Engram-Host-Tabellen (#62359) bringt bei 32K weitere 2,8 %, weil häufige GPU-TLB-Misses vermieden werden.
Für die Messung nutzt vLLM vllm bench forward (#61339), um exakte Prefill- oder Decode-Batches zu timen, und den DecodeBenchConnector für End-to-End-Decode bei vorgegebener Parallelität.
Was das bedeutet
Für Betreiber von DeepSeek-V4.1-Flash legen die Ergebnisse, die von vLLM selbst stammen, nahe, dass eine universelle offene Serving-Engine einer modellspezifischen nahekommen kann und zugleich Online-Serving im Rack-Maßstab beherrscht. Dem Beitrag zufolge stammen die Gewinne aus Engineering an Komponenten, die vLLM bereits besitzt, aufbauend auf von DeepSeek als Open Source veröffentlichten Kerneln. Der vorliegende Quelltext bricht mitten in der Liste der Optimierungen ab, weitere Details sind daher hier nicht abgedeckt.