NVIDIA erläutert Full-Stack-Ansatz gegen den wachsenden Speicherdruck bei KI
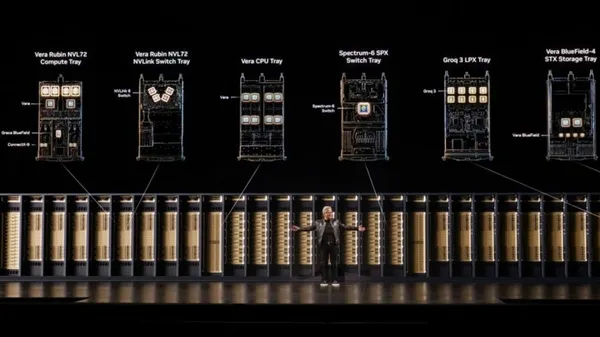
NVIDIA erläutert eine Full-Stack-Strategie, die den durch größere KI-Modelle, längere Kontexte und agentische Anwendungen entstehenden Speicherdruck mindern soll. Nach Angaben des Unternehmens koordiniert der Ansatz GPUs, CPUs, Netzwerke, Speicher und Software, statt sich allein auf mehr GPU-Speicher zu stützen.
- NVIDIA koordiniert GPUs, CPUs, Speicher und Software, um den Speicherdruck bei KI zu reduzieren.
- Agentische Trajektorien können bis zu 3 Millionen Tokens verarbeiten und damit den Bedarf an KV-Cache erhöhen.
- NVFP4 reduziert im Vergleich zu FP8 den für Modellgewichte und KV-Cache benötigten Speicherplatz.
- NVIDIA zufolge liefert Vera Rubin NVL72 bei einem genannten Workload einen bis zu 30-mal höheren Durchsatz pro Dollar als GB300 NVL72.
Warum KI-Workloads an Speichergrenzen stoßen
KI-Fabriken nutzen eine Hierarchie, die den High-Bandwidth-Speicher von GPUs, CPU-Speicher, lokale SSDs und gemeinsam genutzten Speicher umfasst. HBM ist die schnellste und teuerste Ebene, doch Modellgewichte und der KV-Cache konkurrieren um seine begrenzte Kapazität.
Dieser Druck nimmt zu, da Frontier-Modelle Billionen von Parametern erreichen. Der KV-Cache speichert den für aktive Anfragen benötigten Kontext, während agentische Trajektorien den Kontext über wiederholte Modell- und Tool-Aufrufe hinweg übertragen. In einigen Fällen verarbeiten diese Trajektorien bis zu 3 Millionen Tokens. Retrieval-Augmented Generation fügt Eingabeaufforderungen Unternehmensinformationen hinzu und erzeugt dadurch mehr Kontext, der verarbeitet und vorgehalten werden muss.
NVIDIA zufolge lässt sich das gesamte Problem nicht einfach durch eine höhere HBM-Kapazität lösen. Die Speicherbandbreite bestimmt, wie schnell Daten zu den Recheneinheiten gelangen. Sobald diese Bandbreite ihre Grenze erreicht, lässt sich zusätzliche Kapazität möglicherweise nicht effektiv nutzen. Das Unternehmen bezeichnet diese Einschränkung als Memory Wall.
NVIDIAs Strategie umfasst Speicher, Storage und Software
NVIDIA zufolge zielt der Full-Stack-Ansatz auf mehrere Ursachen für Ineffizienz. NVFP4 reduziert im Vergleich zu FP8 den für Modellgewichte benötigten Speicherplatz. Kürzlich wurden Modelle von Black Forest Labs, Thinking Machines Lab, Reflection, Meta, StepFun und NVIDIA Nemotron 3.5 Super VL mit NVFP4-Checkpoints veröffentlicht.
In einem NVL72-System lassen sich die Gewichte auf bis zu 72 GPUs verteilen. Dadurch bleibt mehr HBM für den KV-Cache und gleichzeitige Nutzer verfügbar. NVIDIA wendet NVFP4 zudem auf den KV-Cache an, um dessen Platzbedarf zu reduzieren. Nach Angaben des Unternehmens kann die NVIDIA Vera CPU die Tool-Ausführung verkürzen und mit ihrem großen LPDDR-Speicher einen nahegelegenen Ablageort für pausierte Kontexte bereitstellen. Verbunden ist sie über NVIDIA NVLink-C2C mit NVIDIA Rubin GPUs.
Die Inferenzsoftware NVIDIA Dynamo kann inaktive Kontexte in den Speicher von NVIDIA CMX Context Memory verschieben und vor der erneuten Nutzung zurückholen. Dynamos KV Cache Reuse verwaltet den KV-Cache über GPU-Speicher, CPU-Speicher und Storage hinweg. Dadurch kann ein einmal berechneter Kontext im gesamten System wiederverwendet werden. NVIDIA zufolge gehören Cloudian, DDN, Dell Technologies, Everpure, HPE, IBM, NetApp, VAST und WEKA zu den CMX-Partnern.
Für Retrieval-Augmented Generation erzeugen die NVIDIA-Nemotron-Retriever-Modelle kleinere Embeddings. Die NVIDIA-cuVS-Bibliothek unterstützt den Aufbau und die Bereitstellung des Index über CPU und Storage hinweg. Die Wissensbasis bleibt damit außerhalb des HBM, während nur benötigte Passagen in den Modellkontext gelangen.
Die Durchsatzgewinne fallen größer aus als die HBM-Zuwächse
NVIDIA verweist auf den Durchsatz pro Dollar als Maß dafür, wie effektiv seine Plattformen den Speicher nutzen. Nach Angaben des Unternehmens stieg die HBM-Kapazität pro GPU von NVIDIA Blackwell Ultra bis zur Vera-Rubin-Plattform um etwa 3 Prozent, während der agentische Durchsatz pro Dollar auf SemiAnalysis AgentX um bis zu das 30-Fache zunahm.
Beim SemiAnalysis-AgentX-Workload DeepSeek V4 Pro liefert GB300 NVL72 laut NVIDIA bei 100 Tokens pro Sekunde und Nutzer einen bis zu 10-mal höheren Durchsatz pro Dollar als die NVIDIA-H200-Plattform. Die HBM-Kapazität pro GPU verdoppelt sich dabei ungefähr. Bei 125 Tokens pro Sekunde und Nutzer erzielt Vera Rubin NVL72 laut NVIDIA einen bis zu 30-mal höheren Durchsatz pro Dollar als GB300 NVL72, während die HBM-Kapazität pro GPU um etwa 3 Prozent steigt.
Für Betreiber von KI-Fabriken besteht das erklärte Ziel darin, innerhalb eines Strombudgets mehr nutzbare Tokens zu erzeugen und zugleich die Anforderungen an die Antwortzeit zu erfüllen. NVIDIAs Argument lautet, dass die Abstimmung von Präzision, Platzierung, Wiederverwendung und Datenbewegungen über die Speicherhierarchie hinweg die Kosten pro Token senken kann. Zusätzlicher HBM soll dabei nicht als einzige Antwort auf die steigende Nachfrage betrachtet werden.