SemiAnalysis AgentX

NVIDIA erläutert Full-Stack-Ansatz gegen den wachsenden Speicherdruck bei KI
NVIDIA erläutert eine Full-Stack-Strategie, die den durch größere KI-Modelle, längere Kontexte und agentische Anwendungen entstehenden Speicherdruck mindern soll. Nach…
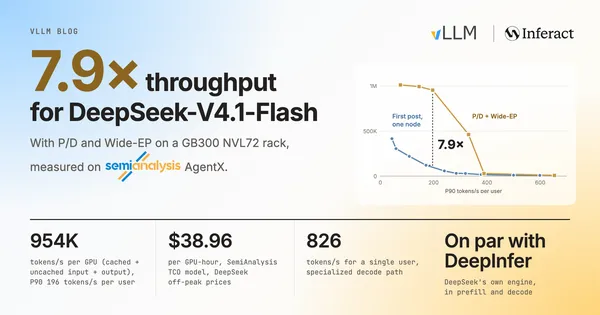
vLLM erreicht 954.000 Tokens pro Sekunde und GPU mit DeepSeek-V4.1-Flash auf GB300 NVL72
Das vLLM-Team berichtet, dass seine Engine mit P/D-Disaggregation und Wide-EP auf einem NVIDIA-GB300-NVL72-Rack im SemiAnalysis-Benchmark AgentX DeepSeek-V4.1-Flash mit…