Anaconda testet TypeSafes Entscheidungsmodell Jev an echten Kundenbeschwerden
Anaconda hat eine Analyse zu Jev veröffentlicht, einem „Entscheidungsmodell“ von TypeSafe, das eine Eingabe einmal liest und für jede mögliche Antwort eine Wahrscheinlichkeit ausgibt, statt Text zu schreiben. Der Beitrag beschreibt, was über das Modell bekannt ist, und vergleicht es mit einem kleinen offenen Klassifikator, den Anaconda selbst trainiert hat.
- TypeSafes Jev ist ein Entscheidungsmodell, das für jede Antwort eine Wahrscheinlichkeit ausgibt, statt Text zu erzeugen.
- Laut Anaconda kostet Jev 0,042 Dollar pro Million Eingabe-Tokens, bei einer mittleren Antwortzeit von 88 Millisekunden.
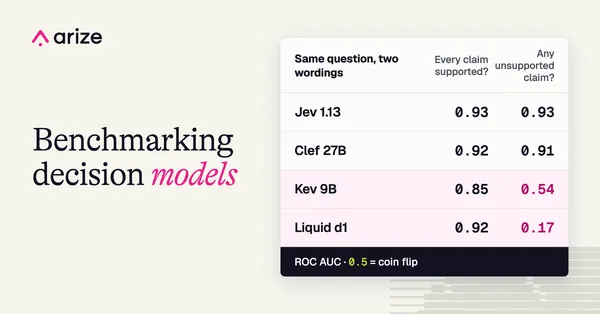
- Das Umsortieren der Optionen verschob Jevs Wahrscheinlichkeiten um bis zu 0,20 und überschritt in 7 von 80 Fällen die Marke von 0,9.
- Bei neuen Matheaufgaben lag Jev in 56 Prozent der Fälle richtig, traute sich selbst aber nur etwa 35 Prozent zu.
- Anaconda rät, Wahrscheinlichkeiten und Optionsreihenfolge vor dem Einsatz an den eigenen Daten zu testen.
Was ein Entscheidungsmodell leistet
Anaconda erläutert das Problem an einer Kundenbeschwerde: Eine Person wird für eine Hotelbuchung über 340 Dollar doppelt belastet, die zweite Abbuchung landet bei einem Inkassounternehmen und taucht in einer Kreditauskunft auf. Eine solche Beschwerde braucht einen Lösungsweg, ein Ja oder Nein dazu, ob sich schnell ein Mensch darum kümmern sollte, und eine Einstufung des Schweregrads. Die meisten Organisationen, so Anaconda, kombinieren dafür handgeschriebene Regeln, ein klassisches Machine-Learning-Modell und einen menschlichen Rückfallplan. Eine wachsende vierte Option ist, die Beschwerde an ein großes Sprachmodell zu geben und JSON zurückzufordern.
Anaconda nennt das einen merkwürdigen Weg zu einer Ein-Wort-Antwort. Das Modell schreibt Token für Token, begründet womöglich in Hunderten von Wörtern, die abgerechnet werden, und braucht ein Schema, einen Validator und Code für Wiederholungsversuche. Die angegebene Sicherheit, etwa „confidence“: 0.91, sei Text, den das Modell sich ausgesucht habe, und keine gemessene Wahrscheinlichkeit.
TypeSafe bezeichnet Jev als „System-One-Modell“, in Anlehnung an Daniel Kahnemans „Schnelles Denken, langsames Denken“. Es ist ein Klassifikator: Bei einer Eingabe (dem Zustand) und einer Reihe von Fragen mit festen Antwortlisten liefert es für jede Antwort eine Wahrscheinlichkeit. Zusammenfassen, Code schreiben oder die eigene Entscheidung erklären kann es nicht. Laut Anaconda hat OpenAI inzwischen auf der DevDay am 29. September eine ähnliche Decisions API in einer begrenzten Vorschau angekündigt.
Warum Entwickler aufhorchen und was über Jev bekannt ist
Sebastian Raschka, der seit Langem Textklassifikatoren baut, stellte fest, dass Jev besser funktionierte als erwartet. Er nennt es „den ChatGPT-Moment für die Klassifikation“. Anaconda führt drei Vorteile an:
- Die Antwort ist immer eine der vorgegebenen Optionen, sodass nur die Korrektheit geprüft werden muss.
- Die Wahrscheinlichkeit wird aus dem internen Zustand des Modells ausgelesen und nicht von ihm geschrieben. Sie lässt sich daher mit Ergebnissen abgleichen und mit Schwellenwerten versehen.
- Es ist günstig: 0,042 Dollar pro Million Eingabe-Tokens, für die Ausgabe fallen keine Kosten an.
Die Beschwerden in Anacondas Test umfassten im Schnitt etwa 630 Tokens und kosteten rund 0,00003 Dollar pro Stück, bei einer mittleren Antwortzeit von 88 Millisekunden. Raschka verarbeitete die 25.000 IMDb-Testrezensionen für etwa 65 Cent und erreichte 96,5 Prozent, auf Augenhöhe mit einem feinjustierten ModernBERT-Modell. Anaconda warnt, dass das Konfidenzfeld der API keine Schätzung der Genauigkeit sei, sondern misst, wie deutlich sich die beste Antwort abhebt. Schwellenwerte sollten daher auf der Wahrscheinlichkeit beruhen.
TypeSafe hat nicht veröffentlicht, wie Jev aufgebaut ist, und das Modell lässt sich nicht herunterladen. Anaconda stützt sich auf die Analyse von Archer Hume, der rund zehntausend Test-Aufrufe der API ausgewertet hat. TypeSafe zufolge werden alle Antworten gleichzeitig erzeugt, und das Modell sei ein bestehendes Sprachmodell, das mit einer unveröffentlichten Methode namens Reinforcement Learning for Calibrated Decisions (RLCD) trainiert wurde. Der CEO hat erklärt, sämtliche Trainingsdaten seien synthetisch. API-Tests zeigen, dass Fragen innerhalb derselben Anfrage einander nicht sehen können und dass eine zusätzliche, irrelevante fünfte Option das Verhältnis zwischen zwei ursprünglichen Optionen verschob. Hume vermutet darunter ein großes allgemeines Sprachmodell, Raschka tippt auf etwas Kleines wie ModernBERT.
Wo das Versprechen an Grenzen stößt
Anaconda betont, dass gute Wahrscheinlichkeiten in Benchmarks keine guten Wahrscheinlichkeiten auf den eigenen Daten garantieren. Bei frisch geschriebenen Matheaufgaben lag Jev in 56 Prozent der Fälle richtig, traute sich selbst aber nur etwa 35 Prozent zu, was Anaconda als viel zu zurückhaltend bezeichnet.
Auch die Reihenfolge der Optionen spielt eine Rolle. Bei 40 Beschwerden wählte Jev nach dem Umsortieren in 79 von 80 Fällen dieselbe Antwort, doch die Wahrscheinlichkeiten verschoben sich um bis zu 0,20 und überschritten in 7 der 80 Fälle die Marke von 0,9. Ein Teil davon ist Rauschen: Eine unveränderte Frage wich zwischen identischen Anfragen um bis zu 0,04 ab. Anacondas eigenes Modell blieb in etwa 48 von 80 Fällen bei seiner Antwort.
Außerdem kann Jev weder schrittweise schlussfolgern noch Informationen nachschlagen. Anaconda unterstützt den Vorschlag von TypeSafe, dass das Entscheidungsmodell entscheidet und ein Sprachmodell schreibt.
Was das für Anwender bedeutet
Zu Jevs Preis, argumentiert Anaconda, lasse sich für jede Zeile, jedes Ereignis und jede Logzeile eine Entscheidung treffen. Der praktische Rat des Beitrags: Wahrscheinlichkeiten an Beispielen aus dem eigenen Workflow messen, bei denen die Antwort bekannt ist, und vor dem Einsatz eines solchen Modells die Reihenfolge der Optionen testen, denn eine Verschiebung von 0,84 auf 0,95 kann einen Schwellenwert überschreiten und verändern, was ein System tut.
Anaconda: Decision Models: Jev vs. a Fine-Tuned Classifier