Arize vergleicht acht Entscheidungsmodelle: Jev, Liquid d1 und Clef 27B liegen bei der Genauigkeit eng beieinander
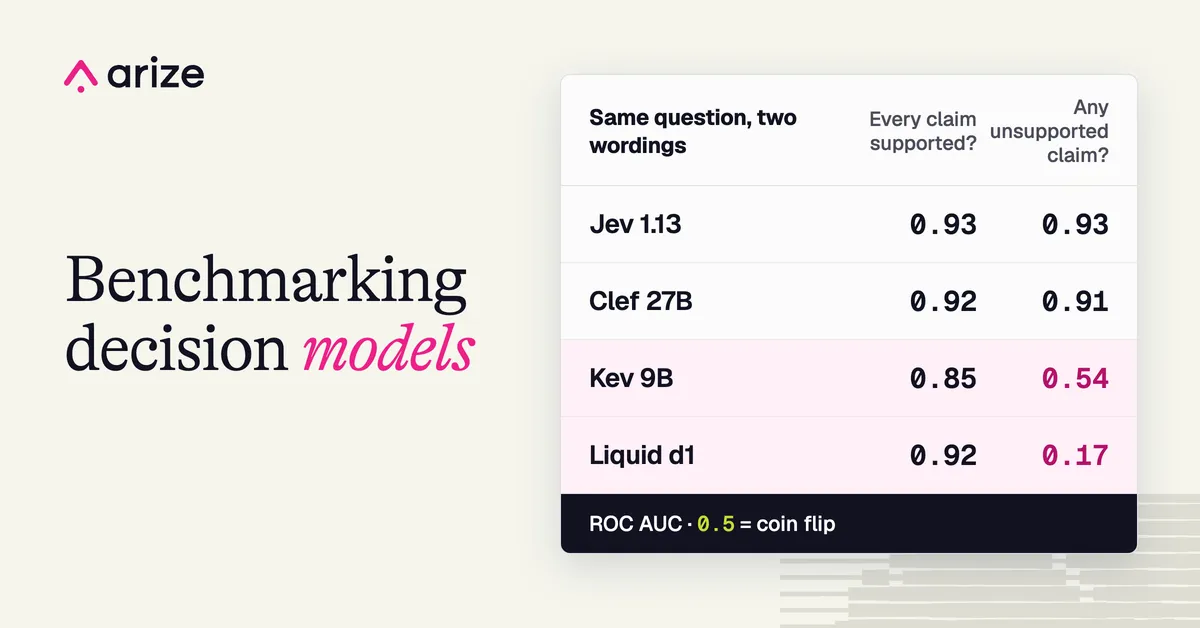
Arize AI hat acht Entscheidungsmodelle verglichen, darunter Jev von TypeSafe, Liquid d1 und OpenAI Decisions. Die Spitzenreiter liegen bei der Genauigkeit eng beieinander, unterscheiden sich aber deutlich bei Latenz, Kosten und Einsatzweise. Die Tests deckten Halluzinationserkennung, LLM-Evaluierung und Agent-Routing ab.
- Arize hat acht Entscheidungsmodelle bei Halluzinationserkennung, LLM-Evaluierung und Agent-Routing verglichen.
- Bei RAGTruth erreichte Jev 85,5 Prozent Balanced Accuracy und kostete 0,045 US-Dollar pro 1.000 Entscheidungen, OpenAI Decisions kam auf 81,5 Prozent und 0,090 US-Dollar.
- Liquid d1 schlug Cloudflares Clef 27B bei Tempo und Kosten nach statistischem Gleichstand bei der Genauigkeit (84,8 gegenüber 85,2 Prozent).
- Im Cloud-Finale der Phoenix-Evals kam Jev auf 91,1 Prozent und Liquid auf 87,6 Prozent, die Partie wurde als Unentschieden gewertet.
- Laut Arize kosten Jev, Liquid und Clef 27B pro Bewertung 0,3, 0,2 und 1,6 Prozent von Opus 5 und liegen bei der Genauigkeit im Rahmen der Messunsicherheit.
Was Entscheidungsmodelle sind und warum Arize sie getestet hat
Laut Arize nimmt ein Entscheidungsmodell eine Frage und eine feste Menge an Optionen entgegen und gibt für jede Option eine Wahrscheinlichkeit zurück. Es erzeugt keinen Text, sodass keine Ausgabe-Token anfallen, die bezahlt werden müssen oder auf die man warten muss. Arize zufolge macht das solche Modelle günstig und schnell für zwei Aufgaben: für einzelne Entscheidungen innerhalb eines Agenten, etwa welches Tool oder welcher Skill genutzt wird oder ob der Agent aufhört, und als Bewerter, der Traces in Arize AX auswertet.
Die Kategorie hat sich rasant entwickelt. TypeSafe veröffentlichte Jev am 15. September, und binnen weniger Wochen brachten laut Arize rund 10 Unternehmen etwas auf den Markt, das nach demselben Prinzip arbeitet. OpenAI, Liquid, Cloudflare, AWS und PostHog haben jeweils eines vorgestellt, und auf Hugging Face tauchte mit Kev ein offener Nachbau auf. Arize zufolge akzeptieren sieben der acht getesteten Modelle das Anfrageformat /v1/systemone von Jev. Die Ausnahme ist OpenAI: Die Decisions-API erwartet einen einzelnen Block Klartext sowie eine Liste von Fragen. Arize hat dafür jeden Fall als beschriftete Textabschnitte formuliert und weist darauf hin, dass ein anderes Layout anders abschneiden könnte. Die Zahlen zu OpenAI beschreibt Arize als ersten Eindruck von einer öffentlichen Beta.
Die Teilnehmer und die Regeln
Die acht Modelle sind Jev 1.13 (TypeSafe), Liquid d1 (Liquid AI), OpenAI Decisions (gpt-6-luna), Clef 27B (Cloudflare), Kev 9B (Jared Palmer), Jeeves 9B (PostHog), Strands Decider 2B (AWS) und Laya multilingual (Convai Innovations). Laya ist ein BERT-artiger Encoder mit 322 Millionen Parametern und kein LLM. Die Listenpreise pro eine Million Eingabe-Token lagen bei 0,042 US-Dollar für Jev, 0,04 US-Dollar für Liquid d1, 0,10 US-Dollar für OpenAI und 0,24 US-Dollar für Clef 27B. Kev, Jeeves, Strands und Laya lassen sich kostenlos selbst hosten.
Arize teilte das Feld in eine Cloud-Konferenz mit gehosteten APIs und eine lokale Konferenz mit offenen Modellen, die auf einem MacBook Pro mit Apple M4 Max und 36 GB Arbeitsspeicher liefen. Jede Konferenz kürt einen Sieger, die beiden treffen im großen Finale aufeinander. Bewertet werden Genauigkeit, Latenz und Kosten pro 1.000 Entscheidungen; um weiterzukommen, braucht ein Modell zwei von drei Siegen. Bei der Genauigkeit zählt ein Sieg nur, wenn sich die 95-Prozent-Konfidenzintervalle nicht überlappen. Jedes Modell bekommt seinen eigenen Ja/Nein-Schwellenwert, der auf einer Hälfte der Daten abgestimmt und auf der anderen bewertet wird.
Die drei Aufgaben waren Halluzinationserkennung anhand von 2.675 Zeilen aus RAGTruth, alle 13 Phoenix-Evaluator-Suiten mit 655 gelabelten Fällen und 52 Agent-Routing-Entscheidungen.
Viertelfinale: Ergebnisse bei der Halluzinationserkennung
Jev setzte sich gegen OpenAI Decisions durch. Jev erreichte eine ausgewogene Genauigkeit (Balanced Accuracy) von 85,5 Prozent, OpenAI 81,5 Prozent, doch die Konfidenzintervalle berühren sich, die Genauigkeit endete also unentschieden. Jev antwortete in 0,08 Sekunden pro Entscheidung gegenüber 0,16 Sekunden und kostete 0,045 US-Dollar pro 1.000 Entscheidungen gegenüber 0,090 US-Dollar. Damit kam es mit 2:0 weiter.
Liquid d1 schlug Clef 27B. Bei der Genauigkeit gab es praktisch einen Gleichstand: 85,2 Prozent für Clef 27B, 84,8 Prozent für Liquid. Liquid war schneller (0,20 gegenüber 0,50 Sekunden) und günstiger (0,034 gegenüber 0,223 US-Dollar pro 1.000 Entscheidungen).
In der lokalen Gruppe besiegte Kev das Modell Laya. Laya war mit 0,04 Sekunden pro Entscheidung das schnellste Modell im Wettbewerb und ist kleiner als ein Gigabyte, erreichte aber nur 59,8 Prozent gegenüber 76,8 Prozent bei Kev. Jeeves gewann gegen Strands mit 80,3 zu 69,0 Prozent, weil es vor der Antwort argumentiert. Strands war im Median etwa 50-mal schneller.
Arize verglich die verbliebenen Modelle außerdem mit einem LLM als Bewerter. In früheren Benchmarks erreichte Opus 5 eine Balanced Accuracy von 86,6 Prozent bei 14,30 US-Dollar pro 1.000 Bewertungen. Jev, Liquid und Clef 27B liegen laut Arize im Rahmen der Messunsicherheit dieses Werts, bei 0,3, 0,2 beziehungsweise 1,6 Prozent der Kosten von Opus 5. OpenAI liegt bei der Genauigkeit einige Punkte weiter zurück, bei 0,6 Prozent der Kosten.
Konferenzfinale: Jev und Liquid trennen sich bei den Phoenix-Evals unentschieden
In der zweiten Runde wurde geprüft, ob ein Modell als Bewerter in einer Eval-Pipeline taugt. Als Tiebreaker nutzte Arize hier die Kalibrierung, gemessen als durchschnittliche Lücke zwischen der angegebenen Konfidenz eines Modells und der tatsächlichen Trefferquote. Niedriger ist besser.
Im Cloud-Finale kam Jev auf 91,1 Prozent und Liquid auf 87,6 Prozent, die Intervalle überlappen, die Genauigkeit war also ein Unentschieden. Jev gewann bei der Geschwindigkeit, Liquid bei den Kosten. Der Kalibrierungsfehler lag bei Jev bei 0,023, bei Liquid bei 0,051, doch bei 655 Fällen überlappen die Intervalle, und Arize wertete die Partie als Unentschieden. Müsse man sich entscheiden, so Arize, habe Jev leicht die Nase vorn. Bei einem Paar aus einem korrekten und einem inkorrekten Fall war Jev in 85 Prozent der Fälle beim korrekten sicherer, Liquid in 81 Prozent. In den 14 Prozent der Fälle, in denen Jev angab, sich zu mindestens 99 Prozent sicher zu sein, lag es jedes Mal richtig.
Der Quelltext bricht vor dem lokalen Finale, dem großen Finale zum Agent-Routing und den abschließenden Ergebnissen ab.
Was das für Agent-Entwickler bedeutet
Für Teams, die Agenten bauen oder Evals betreiben, legt der Benchmark nahe, dass die Wahl zwischen Entscheidungsmodellen weniger von der Genauigkeit abhängt als von Latenz, Kosten, Einsatzort und der Empfindlichkeit gegenüber der Formulierung der Fragen. Grundlage ist Arizes Befund, dass die Spitzenreiter bei der Genauigkeit eng beieinander lagen. Der Kostenabstand zu einem vollwertigen LLM als Bewerter ist in Arizes Zahlen groß. Die Ergebnisse stammen allerdings aus Arizes eigenen Tests und, im Fall von OpenAI, von einem Modell in der öffentlichen Beta, das mit einem von Arize gewählten Prompt-Layout lief.
Arize AI: Decision model benchmark: Jev, Kev, Liquid d1, and more