Ant Group und vLLM stellen Humming als Open Source vor: Kernel-Bibliothek für quantisierte Inferenz
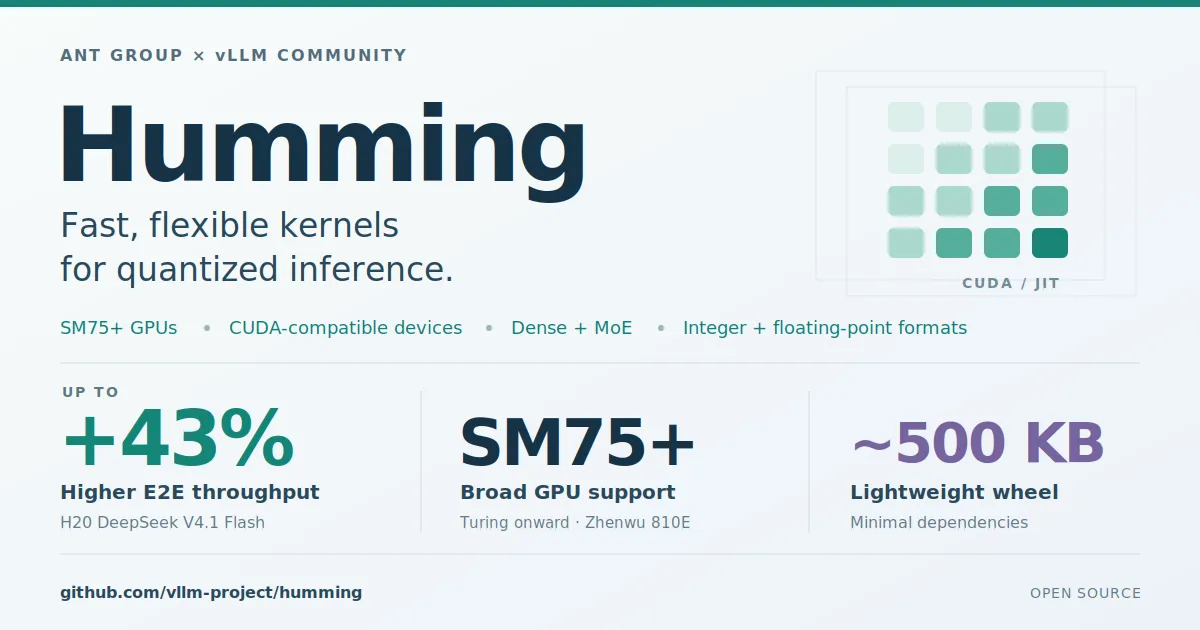
Ant Group und die vLLM-Community machen Humming als Open Source verfügbar, eine universelle, leistungsstarke Kernel-Bibliothek für quantisierte Inferenz. Laut Projekt unterstützt sie NVIDIA-GPUs ab Turing sowie zahlreiche Gewichts- und Aktivierungsformate für Dense- und MoE-Workloads.
- Ant Group und die vLLM-Community haben mit Humming eine Kernel-Bibliothek für quantisierte Inferenz als Open Source veröffentlicht.
- Sie unterstützt NVIDIA-GPUs ab Turing sowie CUDA-kompatible Geräte wie T-Heads Zhenwu 810E.
- Laut Projekt übertrifft sie vLLM Marlin, FlashInfer und DeepGEMM bei vielen repräsentativen Workloads deutlich.
- In einem W4A16-Test auf einer H200 sank die Kompilierzeit von 23,35 Sekunden (CUTLASS mit NVCC) auf 1,82 Sekunden (Humming mit NVCC).
- Ein schneller Pfad von MXFP4 zu INT8/FP8 ermöglicht W4A8-MXFP4-Inferenz auf GPUs vor Blackwell wie der H200.
Was Humming bietet
Der vLLM-Blog nennt drei Hauptmerkmale. Erstens eine breite Geräteunterstützung: NVIDIA-GPU-Architekturen ab Turing sowie CUDA-kompatible Geräte wie T-Heads Zhenwu 810E. Zweitens eine umfassende Quantisierungsunterstützung, mit einer einheitlichen Architektur, die Kombinationen aus Gewichts- und Aktivierungsformaten für Dense- und MoE-Workloads abdeckt, über Integer- und Gleitkommatypen, Bitbreiten und Skalierungsschemata hinweg.
Drittens die Performance. Laut der Ankündigung übertrifft Humming bestehende Implementierungen von vLLM Marlin, FlashInfer und DeepGEMM bei vielen repräsentativen Workloads deutlich. Der Code ist unter github.com/vllm-project/humming verfügbar.
Warum quantisierte Kernel wichtig sind
Die Autoren weisen darauf hin, dass Speicherkapazität, Speicherbandbreite und Rechenkosten den Einsatz mit wachsender Modellgröße zunehmend begrenzen. Besonders sichtbar ist das bei MoE-Modellen, bei denen jedes Token nur einen Teil der Experten aktiviert, aber alle Gewichte gespeichert werden müssen. DeepSeek-V3 etwa hat 671 Milliarden Parameter, von denen pro Token 37 Milliarden aktiviert werden.
Die Quantisierung senkt die Präzision von Gewichten und Aktivierungen, um Speicherbedarf und Datenbewegungen zu verringern. Die Konfigurationen unterscheiden sich stark: Gängig sind WNA16, W8A8, W4A8 und W4A4, und selbst bei gleicher Präzision weichen Verfahren wie INT4 und NVFP4 in Zahlenformat und Skalierung voneinander ab. Gruppengröße, Darstellung der Skalen sowie symmetrische oder asymmetrische Quantisierung bringen weitere Varianten hinzu. Die Einsparungen werden nur mit effizienten Kerneln zu geringerer Latenz und höherem Durchsatz, und für jede Kombination einen eigenen Kernel zu schreiben, verursacht einen wachsenden Wartungsaufwand, von der Gewichtsvorverarbeitung über Framework-Adapter bis zu Tests.
Wie die Architektur funktioniert
Humming trennt die Beschreibung der Quantisierung von den Entscheidungen zur Ausführung und baut Kernel aus gemeinsamen Komponenten auf. Unterstützte Exportformate werden in ein gemeinsames Humming-Standardformat überführt, in dem Gewichte, Skalen, Nullpunkte und weitere Tensoren einheitlich organisiert sind. Die Vorverarbeitung prüft anschließend Parameter, füllt Dimensionen auf und packt Tensoren für den Ziel-Kernel neu.
Drei Konfigurationen beschreiben jeden Kernel: eine Layer Config für Shapes, Datentypen, Quantisierungsparameter und Zielarchitektur, eine Compute Config für den GEMM-Typ und Optionen wie Batch-Invarianz sowie eine Tuning Config für Tile-Shapes, Pipeline-Stufen, Warp-Spezialisierung, Speicherzugriff und MMA-Instruktionen. Standardmäßig wählen gerätespezifische Heuristiken die Tuning-Konfiguration, und Humming kann zur Laufzeit für unterschiedliche Eingabegrößenbereiche verschiedene Kernel auswählen.
Nach Angaben des Teams kann bei kleinen Batchgrößen eine mehrstufige Pipeline mit cp.async und MMA eine auf TMA und UMMA basierende übertreffen, während TMA und UMMA bei größeren Batchgrößen den besseren Durchsatz liefern können. Humming unterstützt beide Pfade in einem Framework. Die Kernel werden mit NVRTC oder NVCC kompiliert und zwischengespeichert.
Kompilierzeiten und gerätespezifisches Tuning
Die CUDA-Schicht ist in wiederverwendbare Komponenten für Scheduling, Datenbewegung, Dequantisierung und Skalierung, Tensor-Core-Berechnung und Ausgabeverarbeitung gegliedert. Ein neues Format oder eine neue Architektur lässt sich durch Erweiterung der jeweiligen Komponenten unterstützen, und Verbesserungen an einer gemeinsamen Komponente kommen kompatiblen Konfigurationen zugute.
Die Implementierung ist schlank und kommt ohne schwergewichtige Kernel-Framework-Abhängigkeiten aus. In einem Test mit der Kompilierung eines einzelnen W4A16-Kernels auf einem H200-Server mit CUDA 13.4 und deaktivierten Kompilier-Caches sank die Kompilierzeit von 23,35 Sekunden bei CUTLASS mit NVCC auf 1,82 Sekunden bei Humming mit NVCC beziehungsweise 1,88 Sekunden mit NVRTC. Das Kompilieren und Laden der Kernel für alle unterstützten M-Größen des GEMM einer Schicht dauert nach Tests des Teams etwa 2 bis 4 Sekunden.
Der Beitrag beschreibt außerdem W4A8-MXFP4-Inferenz auf GPUs vor Blackwell, denen die native MXFP4-Tensor-Core-Unterstützung fehlt. Humming nutzt dafür im Kernel einen schnellen Dequantisierungspfad von MXFP4 zu INT8/FP8. Nach Angaben der Autoren übertrifft dieser herkömmliche W4A8-Implementierungen bei kleinem M deutlich und nähert sich bei großem M der W8A8-Performance an, sodass GPUs wie die H200 W4A8-MXFP4 ausführen und zugleich die Speichervorteile von 4-Bit-Gewichten behalten können.
Was das für Inferenz-Teams bedeutet
Für Teams, die quantisierte Modelle betreiben, bietet Humming eine einheitliche Schnittstelle über Exportformate und GPU-Generationen hinweg, statt separater Kernel für jedes Verfahren. Die schnellere Kompilierung soll iteratives Tuning und die Vorbereitung spezialisierter Kernel vor der Inferenz praktikabler machen. Die Leistungsangaben stammen vom Projekt selbst.