Anyscale: Selbst gehostete Coding-Agenten mit Ray und vLLM kosten nur einen Bruchteil der API-Preise
Anyscale zufolge können Teams Coding-Agenten mit vLLM, Ray Serve LLM und der Anyscale-Plattform auf eigenen GPUs für einen Bruchteil der tokenbasierten API-Preise betreiben. In einem neuen Leitfaden beziffert das Unternehmen die Kosten für Self-Hosting auf etwa 17 bis 58 US-Dollar pro registriertem Entwickler und Monat. Dem stehen rund 800 US-Dollar API-Kosten für Claude Code bei einem aktiven Entwickler gegenüber.
- Anyscale beziffert das Self-Hosting von Coding-Agenten auf etwa 58 US-Dollar (Dauerbetrieb) oder 17 US-Dollar (nur zu Arbeitszeiten) pro registriertem Entwickler und Monat, gegenüber rund 800 US-Dollar vergleichbarer Claude-Code-API-Kosten.
- Die Kostenzahlen beruhen auf etwa 4 US-Dollar pro GPU-Node-Stunde für eine RTX PRO 6000 und 50 Entwicklern pro GPU und sind Planungsprognosen, keine TCO-Analyse.
- Der Stack kombiniert vLLM, Ray Serve LLM und die Anyscale Platform mit Endpunkten für Cursor, Claude Code und Codex.
- CPU-KV-Cache-Tiering erhöhte in einer GLM-5.2-Auswertung den Anteil gecachter Prompt-Tokens von 6,1 % auf 74,9 % und senkte die mediane Zeit bis zum ersten Token von 48,4 auf 9,2 Sekunden.
- Ein fünfteiliges Code-Repository deckt Bereitstellung, Client-Anbindung, Optimierung, Routing mit LiteLLM und den Team-Rollout ab.
Was Anyscale vorschlägt
Anyscale hat eine Schritt-für-Schritt-Anleitung veröffentlicht, wie sich Open-Weight-Modelle für Coding-Agenten wie Claude Code, Codex und Cursor bereitstellen lassen. Die Argumentation hat zwei Seiten. Coding-Agenten senden Repository-Kontext, Anweisungen, Tool-Ergebnisse und Gesprächsverlauf immer wieder an ein Modell, sodass mit jeder Anfrage Quellcode und interne Dokumente das Unternehmensnetz verlassen. Und wer Closed-Source-Anbieter pro Token bezahlt, erhält eine Rechnung, die linear mit jedem Entwickler und jeder Anfrage wächst.
Wer die Laufzeitumgebung selbst betreibt, behält laut Anyscale Code, Traces und Nutzungsdaten im Haus. Diese Daten ließen sich später nutzen, um Modelle gezielt für ein Team nachzutrainieren. Das Unternehmen verweist zudem auf BMW, das nach eigener Darstellung schon mit nur 8 Entwicklern ein günstiges Kosten-Nutzen-Verhältnis beim Wechsel von der API zu eigener Inferenz festgestellt habe.
Kostenmodell und Leistungszahlen
Das Kostenmodell von Anyscale geht von rund 4 US-Dollar pro GPU-Node-Stunde für eine RTX PRO 6000 aus, wobei sich 50 registrierte Entwickler eine GPU teilen. Unter diesen Annahmen ergibt sich:
- Dauerbetrieb: etwa 2.920 US-Dollar pro Monat, also rund 58 US-Dollar pro registriertem Entwickler.
- Betrieb nur zu Arbeitszeiten: etwa 840 US-Dollar pro Monat, also rund 17 US-Dollar pro registriertem Entwickler.
- API-Vergleichswert: Ein aktiver Entwickler verursacht regelmäßig rund 800 US-Dollar pro Monat an vergleichbaren Claude-Code-API-Kosten.
Das Unternehmen betont, dass es sich dabei um Planungsprognosen und nicht um eine Analyse der Gesamtbetriebskosten handelt.
Außerdem nennt Anyscale Ergebnisse aus eigenen Tests:
- 8,0-mal schnellere Kompilierung durch Wiederherstellung des Compile-Cache: von 48,5 auf 6,0 Sekunden in einem NVFP4-Setup ohne MTP.
- 3,79-mal höherer Anfragedurchsatz durch CPU-KV-Cache-Tiering. In einer Auswertung mit einem einzelnen GLM-5.2-Replikat steigerte eine 512-GiB-CPU-Ebene den Anteil gecachter Prompt-Tokens über 58 häufige Prompts von 6,1 % auf 74,9 % und senkte die mediane Zeit bis zum ersten Token von 48,4 auf 9,2 Sekunden.
- 1,86-mal höherer Ausgabedurchsatz durch Speculative Decoding: Multi-Token-Prediction steigerte die Ausgabe von 65 auf 121 Tokens pro Sekunde.
- 2,87-mal schnellere Ausgabegenerierung mit CUDA Graphs: Der auf Clientseite gemessene Durchsatz stieg gegenüber dem Eager-Modus von 15,9 auf 45,6 Tokens pro Sekunde.
Warum Coding-Agenten ein anderes Serving brauchen
Anyscale beschreibt den Datenverkehr von Coding-Agenten als Prefill-lastig. In jeder Runde werden Systemanweisungen, Repository-Kontext, Tool-Definitionen, Diagnosen und Verlauf erneut gesendet, oft nur, um einen kurzen Tool-Aufruf oder eine kleine Änderung zu erzeugen. Da sich der Großteil dieses Kontexts zwischen den Runden wiederholt, bringt die automatische Wiederverwendung des Prefix-KV-Cache große Vorteile. Korrelierte Lastspitzen im Team erhöhen den Druck. Eine Plattform müsse daher eine niedrige Zeit bis zum ersten Token, flüssiges Token-Streaming, hohe Cache-Wiederverwendung und elastische Kapazität in Einklang bringen, so das Unternehmen.
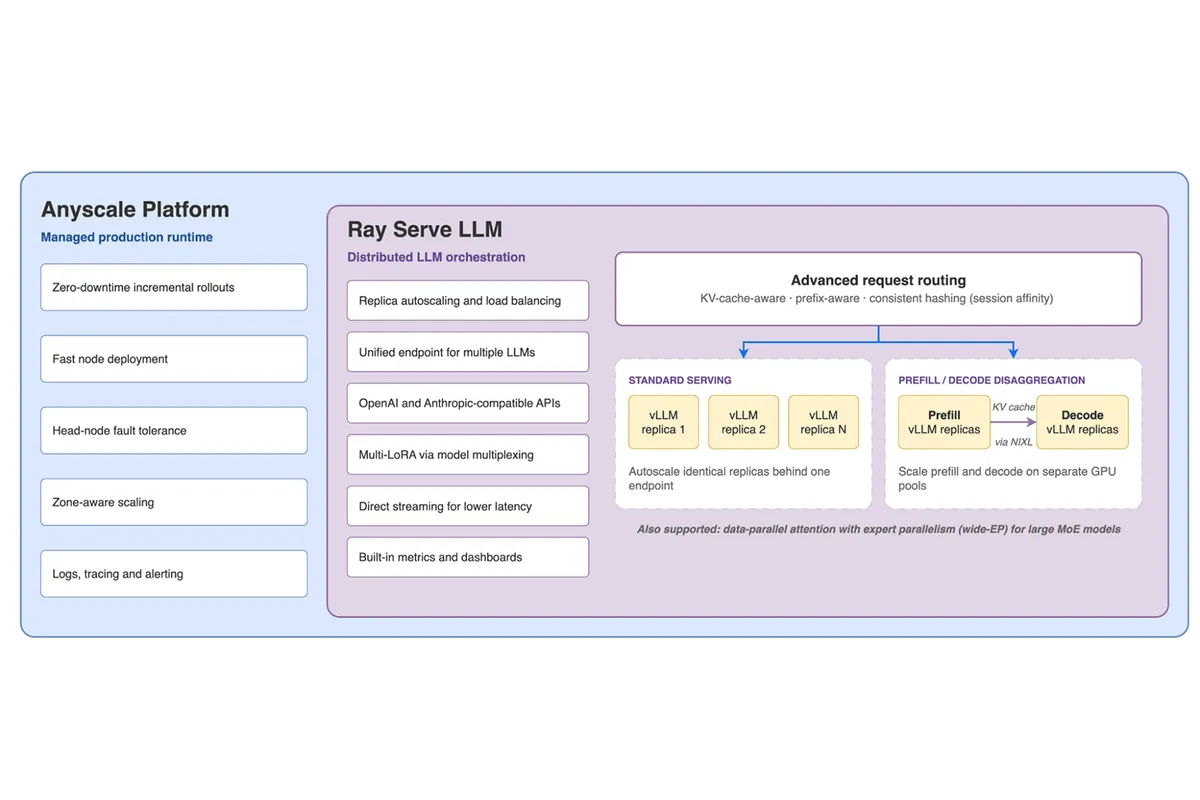
Der Stack besteht aus drei Schichten. vLLM ist die Inferenz-Engine, die das Modell auf die GPUs lädt und Tokens erzeugt. Ray Serve LLM skaliert, routet und verteilt Anfragen per Load Balancing auf vLLM-Replikate hinter einem einzigen, OpenAI- und Anthropic-kompatiblen Endpunkt. Die Anyscale Platform stellt GPUs bereit, skaliert Nodes automatisch bis hin zu Scale-to-Zero und ergänzt Rollouts ohne Ausfallzeit, Fehlertoleranz, Logs, Tracing und Alerting.
Jeder Client nutzt einen anderen API-Pfad, den die Serving-Schicht bereitstellen muss: Cursor verwendet /v1/chat/completions, Claude Code /v1/messages und Codex /v1/responses.
Bereitstellung und Bedeutung für Teams
Anyscale hat ein Code-Repository mit dem Titel LLM serving for coding agents veröffentlicht, das in fünf Teile gegliedert ist: Bereitstellung eines Basisdienstes, Anbindung von Claude Code, Codex und Cursor, Optimierung von GPU-Nutzung, Caching, Decoding und Autoscaling, Routing zwischen dem offenen Modell und Claude mit LiteLLM sowie Konfiguration eines Zero-Touch-Deployments für ein Team.
Die empfohlene Bereitstellung umfasst vier Schritte: Modell auswählen, Hardware und Parallelisierungsstrategie festlegen, die vLLM-Engine und das Ray-Serve-Deployment konfigurieren, anschließend bereitstellen und jeden Client validieren. Bei der Modellwahl nennt Anyscale die Familien Qwen, DeepSeek, Kimi und GLM, die zunehmend auf Coding und Tool-Nutzung ausgerichtet seien. Öffentliche Rankings seien nur ein Ausgangspunkt, warnt das Unternehmen. Benchmark-Werte spiegelten oft das gesamte Agentensystem und nicht allein das Modell wider, weshalb Ergebnisse nur bei übereinstimmenden Versionen und Setups verglichen werden sollten.
Für Engineering-Teams, die API-Ausgaben gegen Datenkontrolle abwägen, lautet das Argument des Unternehmens: Gemeinsam genutzte GPUs können die Grenzkosten pro Token senken, wenn die Auslastung hoch genug ist, um die fixen Infrastrukturkosten auszugleichen. Die Zahlen stammen aus dem eigenen Modell von Anyscale und hängen von den genannten Annahmen ab.