Anyscale nutzt Ray und einen Physik-Zwilling, um zu ergründen, worauf eine Roboter-Policy achtet
Anyscale hat beschrieben, wie das Unternehmen mit Ray kontrollierte Experimente an einer eingefrorenen Vision-Language-Action-Policy in einem Physik-Zwilling seines eigenen Roboters durchführte. Laut Unternehmen verortete der Ansatz die Entscheidung der Policy, etwas anzuheben oder loszulassen, in wenigen hundert Pixeln an den Greiferspitzen ihrer Handgelenkkameras.
- Anyscale führte kontrollierte Experimente an LeRobots eingefrorener pi0.5-Policy zum Wäschefalten in einem Isaac-Lab-3.0-Physikzwilling seines eigenen Roboteraufbaus durch.
- Der Austausch eines von drei Eingabebildern durch ein echtes Bild verortete die Entscheidung zwischen Anheben und Loslassen in wenigen hundert Pixeln an den Greiferspitzen der Handgelenkkameras.
- Das Unternehmen meldet seine ersten Zero-Shot-Faltungen eines Stoffshirts durch ein eingefrorenes VLA in der Simulation, ohne echte Pixel und ohne Feinabstimmung.
- Die Studie ist ein einziges Ray-Programm, und das Notebook reproduziert ihren Kern in sechs Minuten auf vier L4.
- Ein Greif-Proxy befestigt Stoffknoten am Greifer, der Zwilling validiert daher nicht die Robustheit des Griffs.
Eine eingefrorene Policy im Zwilling des eigenen Aufbaus
In einem Blogbeitrag vom 9. Oktober 2026 beschreibt Ian Jordan, PhD, eine Studie auf Basis des pi0.5-Checkpoints von LeRobot zum Wäschefalten, veröffentlicht als lerobot/folding_latest. Laut dem Beitrag handelt es sich um pi0.5, von LeRobot auf dem realen beidarmigen Falten von T-Shirts mit OpenArm feinabgestimmt. Die Policy kombiniert ein PaliGemma-VLM mit 3 Milliarden Parametern und einen Flow-Matching-Action-Expert mit 300 Millionen Parametern. Sie liest drei Kameras (eine Kopfkamera mit 640 x 480 und zwei Handgelenkkameras mit 1280 x 720), einen 16-dimensionalen Gelenkzustand und die Anweisung „Fold the T-shirt properly“.
Anyscale gibt an, die Policy nie verändert oder feinabgestimmt zu haben. Jeder Aufruf nutzte den öffentlichen Checkpoint in bf16. Der Zwilling läuft auf Isaac Lab 3.0 mit dem Physik-Backend Newton, das Shirt ist ein Newton-VBD-Stoff mit 25.610 Knoten. Die Policy läuft im geschlossenen Regelkreis mit 30 Hz auf den gerenderten Bildern und dem Gelenkzustand des Zwillings. Laut dem Beitrag gelangt nie ein echtes Pixel in eine Beobachtung, die ein Rollout verarbeitet.
Das Experiment: ein Bild austauschen, zählen, was die Policy plant
Die Methode ist einfach. Das Team nimmt eine Beobachtung, die die Policy im Zwilling gesehen hat, und ersetzt eines der drei Bilder durch ein echtes Bild aus derselben Aufgabenphase. Alles andere bleibt identisch, und das Team zählt, was die Policy plant. Anyscale argumentiert, ein realer Roboter könne einen solchen Test nicht bieten, da keine zwei Resets gleich seien, ein Physik-Zwilling dagegen schon.
Das Unternehmen nennt drei Ergebnisse:
- Die Entscheidung der Policy, etwas anzuheben oder loszulassen, sitzt in wenigen hundert Pixeln an den Greiferspitzen ihrer Handgelenkkameras.
- Der Befund zeigte, wie der Griff des Zwillings aussehen musste.
- Er führte zu dem, was Anyscale als seine ersten Zero-Shot-Faltungen eines Stoffshirts durch ein eingefrorenes VLA in der Simulation bezeichnet, ohne echte Pixel und ohne Feinabstimmung.
Der Beitrag beschreibt das Problem als blinde Datensammlung. Wenn ein VLA, das an einem realen Aufbau funktioniert, nach einer Kameraverschiebung oder dem Wechsel in die Simulation scheitert, lautet die übliche Antwort Feinabstimmung mit mehr Daten, doch sie sagt nicht, was gesammelt werden soll. Als Benchmark, der das Scheitern zeigt, aber nicht dessen Ursache, nennt der Beitrag LIBERO-Plus, wo Änderungen von Blickwinkel oder Anfangszustand die Erfolgsquote von 95 % auf unter 30 % drücken.
Wie Ray das umsetzt
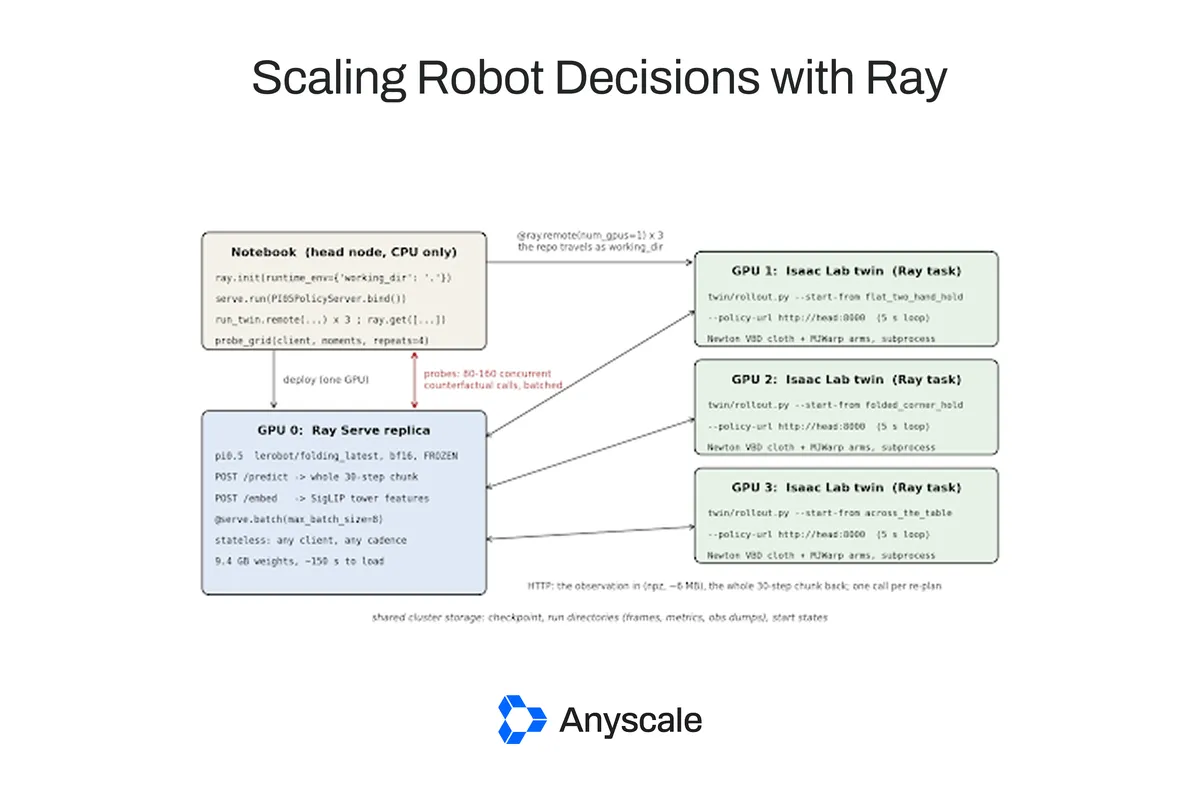
Die gesamte Studie ist ein einziges Ray-Programm. Ein Policy-Dienst läuft auf einer GPU, drei Zwillinge laufen auf drei GPUs, und die Sonden agieren als nebenläufige Clients desselben Dienstes. Die Policy wird mit Ray Serve bereitgestellt und liefert pro Anfrage einen vollständigen Action-Chunk mit 30 Schritten, ohne Zustand pro Client zu speichern. Diese Zustandslosigkeit erlaubt es vielen Clients, sich ein Replikat zu teilen, und nebenläufige Aufrufe, darunter eine Sonde, die achtzig auf einmal absetzt, werden in einem einzigen Forward-Pass gebündelt.
Das Teilen ist wichtig, denn laut dem Beitrag müssten drei Simulatoren sonst jeweils 3 Milliarden Parameter auf ihrer eigenen GPU laden, und eine einzelne L4 mit 24 GB kann Isaac Sim, den Stoff-Solver und die Policy nicht gemeinsam aufnehmen. Jeder Zwilling ist ein Ray-Task, der eine GPU belegt und als Subprozess läuft, da die Kit-Event-Loop von Isaac Sim nicht in einem Ray-Worker leben darf. Wiederholungsversuche sind bewusst deaktiviert, weil ein stillschweigend wiederholter Zwilling von vorn beginnen und dabei seine eigenen Frames überschreiben würde.
Da ein Zwillingsstart ein bis drei Minuten kostet und ein zur Ruhe gekommenes Shirt weitere zweihundert Simulationsschritte, startet das Notebook Zwillinge aus gespeicherten Haltezuständen. Anyscale zufolge reproduziert das Notebook den Kern der Studie in sechs Minuten auf vier L4.
Grenzen des Greif-Proxys
Der Beitrag ist offen bei einem Proxy. Ein Reibungsgriff auf simuliertem Stoff dieser Dicke hält nicht. Wenn der Greifer schließt, werden daher Stoffknoten zwischen den Backen am Greiferrahmen befestigt und mitgeführt. Anyscale ergänzt eine Kneiffaltung, bei der der Stoff zwischen den Backen gebündelt wird, weil genau das die Handgelenkkamera sehen muss. Wie es im Beitrag heißt, hält ein fixierter Griff immer, der Zwilling validiert also Greifbewegung, Faltstrategie und visuomotorische Kontrolle, nicht aber die Robustheit des Griffs.
Ein strengerer Test prüft zudem, ob sich die Backe beim Schließen tatsächlich über dem Stoff befand. In den mitgelieferten Zuständen besteht nur die linke Backe. Die Fixierung der rechten Hand band Knoten aus mehreren Zentimetern Entfernung an, was der Proxy erlaubt, ein echter Greifer aber nicht kann. Die gespeicherten Segmente üben daher den Wiederherstellungspfad und das gemeinsame Replikat, sind aber kein Beleg für einen Zweihandgriff.
Was das bedeutet
Anyscales Argument lautet: Sobald die Evaluation im geschlossenen Regelkreis günstig ist, wird ein Simulator zum Instrument, um zu fragen, wovon eine Policy abhängt. Laut dem Beitrag können solche Antworten Hinweise darauf geben, wo eine Kamera platziert werden sollte und was ein Simulator oder eine Pipeline für synthetische Daten leisten muss, damit eine eingefrorene Policy weiter funktioniert. Außerdem merkt der Beitrag an, dass Werkzeuge auf Aktivierungsebene, mit denen sich finden lässt, wo im Netzwerk eine Entscheidung liegt, der nächste Schritt seien, sobald der Zwilling existiert. Die Ergebnisse stammen von einer Policy und einem Aufbau, und der Greif-Proxy begrenzt ihre Aussagekraft für reales Greifen.
Anyscale: Scaling the Science of Robot Decisions with Ray on Anyscale