ARPA-H fördert mit 28,6 Millionen US-Dollar KI, die schädliche Proteinveränderungen vorhersagen soll
Ein Forschungsteam mehrerer Institutionen erhält bis zu 28,6 Millionen US-Dollar, um künstliche Intelligenz darauf zu trainieren, vorherzusagen, wann Proteine, die mit neurodegenerativen Erkrankungen in Verbindung stehen, wahrscheinlich fehlgehen. Randal Halfmann, Ph.D., Investigator am Stowers Institute, wird laut Institut die experimentellen Daten erzeugen, die die Modelle benötigen.
- Ein Team aus mehreren Institutionen erhält von ARPA-H bis zu 28,6 Millionen US-Dollar, um KI darauf zu trainieren, schädliche Proteinveränderungen vorherzusagen.
- Das Halfmann-Labor am Stowers Institute bekommt über zwei Jahre rund 4,1 Millionen US-Dollar.
- Das Labor plant mehr als 10 Milliarden Aggregationsmessungen an 50.000 Proteinen mithilfe von DAmFRET in Hefe.
- Das Projekt NATIVE-ID wird vom Innovative Genomics Institute der UC Berkeley geleitet und ist Teil des ARPA-H-Programms BIOGAMI.
- Der anfängliche Fokus liegt auf der frontotemporalen Lobärdegeneration; Phase 2 soll mögliche Therapeutika validieren.
Eine Lücke bei den KI-Vorhersagen
Neurodegenerative Erkrankungen wie Alzheimer, Parkinson, ALS und Chorea Huntington werden mit Proteinen in Verbindung gebracht, die ihre Form verändern, verklumpen und schließlich Zellen schädigen. Wenn Forschende diese Veränderungen deutlich erkennen können, ist ein Großteil des Schadens unter Umständen bereits entstanden. Das neue Vorhaben soll klären, was früher geschieht, und diese Erkenntnisse nutzen, um KI zu trainieren.
Das Projekt setzt an einer konkreten Grenze heutiger KI an. Zwar hat KI die Möglichkeiten der Forschung, die Strukturen vieler Proteine vorherzusagen, grundlegend verändert, doch etwa ein Drittel aller Proteine besitzt keine stabile Struktur. Diese intrinsisch ungeordneten Proteine (intrinsically disordered proteins, IDPs) können zwischen vielen Formen wechseln und an schädlichen Verklumpungen, der sogenannten Aggregation, beteiligt sein, die mit neurodegenerativen Erkrankungen zusammenhängt.
Auch ohne feste Struktur wird das Verhalten von IDPs weiterhin von ihrer Aminosäuresequenz beeinflusst. Genau diesen Zusammenhang soll die KI lesen lernen.
Was das Halfmann-Labor leisten wird
Das Halfmann-Labor am Stowers Institute for Medical Research in Kansas City, Missouri, erhält von der Advanced Research Projects Agency for Health (ARPA-H) über zwei Jahre rund 4,1 Millionen US-Dollar. Seine Aufgabe ist es, umfangreiche experimentelle Daten zur Proteinaggregation zu erzeugen.
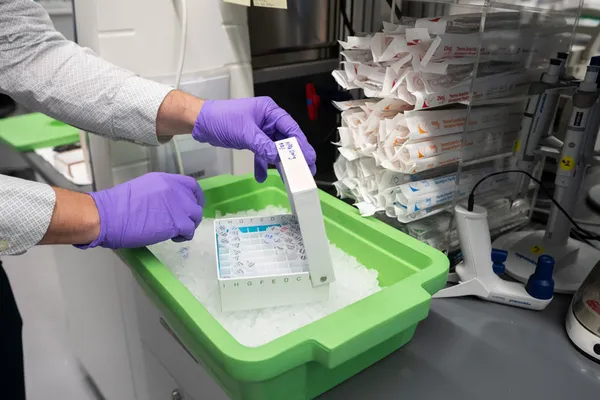
Das Labor will die Aggregationsneigung von 50.000 Proteinen messen, die jeweils einzeln in Hefezellen exprimiert werden, und zwar unter verschiedenen Bedingungen, die nachbilden sollen, was in menschlichen Zellen im Alter schiefläuft. Über mehr als 1 Million Proben hinweg erwartet das Team mehr als 10 Milliarden Messwerte. Zum Einsatz kommt Distributed Amphifluoric FRET (DAmFRET), eine Technologie, die sein Team 2018 entwickelt hat und die die Selbstorganisation von Proteinen in einzelnen lebenden Zellen misst.
„Direkte Messungen der Proteinaggregation in zellulärer Auflösung wurden bisher noch nicht in diesem Umfang durchgeführt“, sagte Halfmann. Laut der Mitteilung zeigten frühere Studien seines Labors, dass sich krankheitsrelevantes Proteinverhalten, das in Hefe beobachtet wird, auch auf das Verhalten dieser Proteine in menschlichen Zellen übertragen lässt.
Das Projekt baut auf früheren Arbeiten auf. 2023 bestimmte das Labor als erstes experimentell die Struktur des initiierenden Schritts der Amyloidbildung, die mit Chorea Huntington in Verbindung steht. Außerdem stützt es sich auf Studien zu TDP-43, einem Protein, das eng mit ALS und FTLD assoziiert ist. „In diesen Studien haben wir uns Hunderte Proteinsequenzen angesehen. Jetzt werden wir 50.000 untersuchen“, sagte Halfmann.
Das NATIVE-ID-Team und seine Struktur
Das Projekt mit dem Namen NATIVE-ID wird vom Innovative Genomics Institute der University of California, Berkeley, geleitet und ist Teil des ARPA-H-Programms BIOGAMI, das von ARPA-H-Programmmanagerin Shannon Greene, Ph.D., geführt wird. Neben Stowers und UC Berkeley gehören Wissenschaftlerinnen und Wissenschaftler der Brown University, der Emory University, der Johns Hopkins University, des Parallel Squared Technology Institute und der Texas A&M University zum Team.
Die Teammitglieder bringen sich ergänzende Fähigkeiten ein: die Erzeugung menschlicher Neuronen aus unterschiedlichen genetischen Hintergründen, die Messung von Proteininteraktionen in Neuronen, die Entwicklung fortschrittlicher Deep-Learning-Frameworks, die Bestimmung von Proteinstrukturen im Reagenzglas sowie umfangreiche Computersimulationen des Proteinverhaltens.
Alejandro Sánchez Alvarado, Ph.D., Präsident und Chief Scientific Officer von Stowers, sagte, die Kolleginnen und Kollegen in Berkeley würden „die menschlichen Neuronen liefern, in denen die Vorhersagen des Modells letztlich Bestand haben müssen“.
Die Gruppe wird sich zunächst auf die frontotemporale Lobärdegeneration (FTLD) konzentrieren, eine Erkrankung, die erhebliche genetische und biologische Merkmale mit ALS teilt. Das übergeordnete Ziel sind Ansätze, die sich auch auf andere Krankheiten mit Proteinfehlfaltung übertragen lassen.
Wie es weitergeht
Die aktuelle Förderung finanziert eine erste, zweijährige Phase. BIOGAMI ist in zwei Phasen von jeweils 24 Monaten gegliedert: In Phase 1 entstehen die grundlegenden Datensätze und Modelle, Phase 2 konzentriert sich darauf, mögliche Therapeutika zu validieren und Wege zu finden, Proteinfehlfunktionen früher zu erkennen.
Halfmann sagte, eine bessere Vorhersage von Erkrankungswahrscheinlichkeiten und Erkrankungsalter „könnte es vielen weiteren Menschen ermöglichen, vorbeugende oder frühzeitige Behandlungen in Anspruch zu nehmen oder an klinischen Studien teilzunehmen“. Zudem könne die Entschlüsselung von IDP-Interaktionen es Forschenden ermöglichen, therapeutische IDPs zu entwickeln, die problematische Interaktionen, die Krankheiten wie Alzheimer antreiben, „abfangen“. Dies sind Ziele der Forschung; Ergebnisse nennt die Mitteilung noch nicht.