Azure Content Understanding: Vorgefertigte Analyzer bringen Fachwissen für Dokumente mit
Microsoft versteht die vorgefertigten Analyzer in Azure Content Understanding als mehr als ein bloßes Schema: Sie bündeln ein gepflegtes Schema mit erlerntem Wissen über eine Dokumentenfamilie. In einem Benchmark über 19 US-Steuerformular-Kategorien übertraf Azure Content Understanding 2.0 Preview mit Advanced Contextualization nach Angaben von Microsoft sowohl die Version 1.0 GA als auch Azure Document Intelligence beim mittleren F1-Wert.
- Laut Microsoft bündeln die vorgefertigten Analyzer in Azure Content Understanding ein gepflegtes Schema mit erlerntem Wissen über eine Dokumentenfamilie.
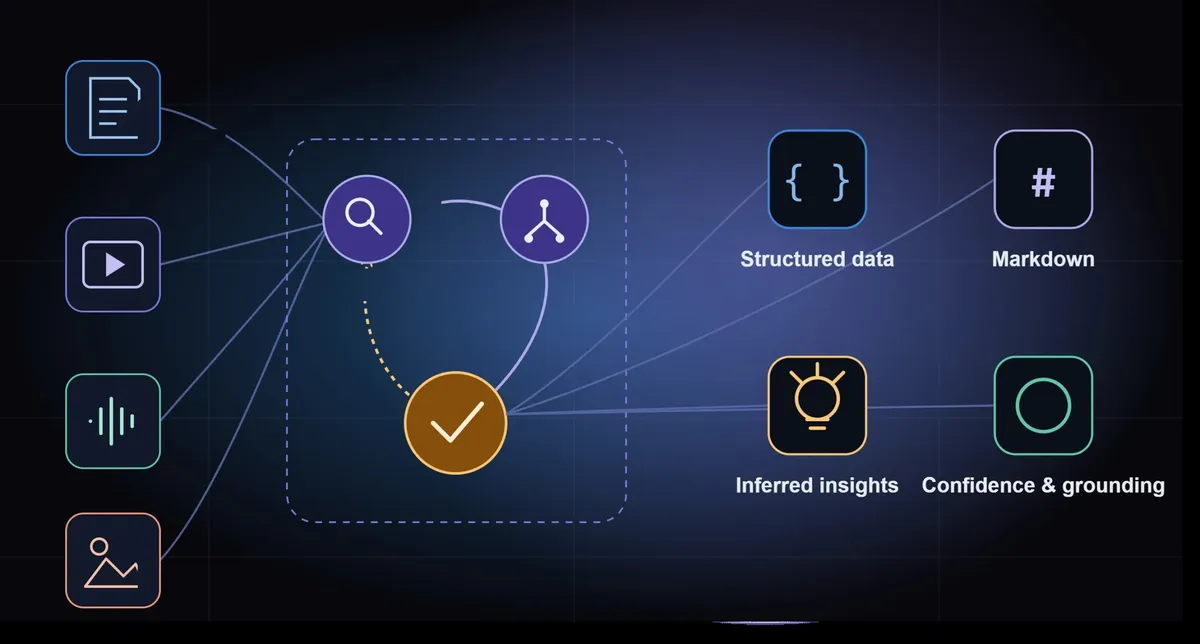
- Unterstützte Felder liefern einen normalisierten Wert, einen Konfidenzwert und Grounding auf Quellstelle, Seite und Koordinaten.
- Kombinierte Analyzer für Beschaffung, US-Steuern und US-Hypothekenaufnahme klassifizieren und routen Dokumente vor der Extraktion.
- Bei 19 US-Steuerformular-Kategorien erreichte die 2.0 Preview einen mittleren F1-Wert von 99,32 %, gegenüber 97,41 % bei 1.0 GA und 96,71 % bei Azure Document Intelligence.
- Microsoft zufolge sanken die modellierten Kosten gegenüber 1.0 GA um 51 % auf 8 $ pro 1.000 Seiten, betont aber, dass es sich um Schätzungen handelt.
Warum ein Schema allein nicht genügt
Nach Angaben von Microsoft ist das Extrahieren von Text bei vielen Workflows zur intelligenten Dokumentenverarbeitung und bei agentenbasierten Abläufen nur der Anfang. Anwendungen müssen die Struktur eines Dokuments und seine implizite geschäftliche Bedeutung erfassen, damit Agenten und nachgelagerte Systeme zuverlässig darauf aufbauen können.
Ein Schema legt den Ausgabevertrag fest: Feldnamen, Typen, Pflichteigenschaften, verschachtelte Objekte und zulässige Werte. Microsoft verweist jedoch auf die Grenzen. Ein Schema kann verlangen, dass totalAmount eine Zahl ist, verrät aber nicht, ob ein Minuszeichen verloren ging, ein Datum mit der falschen Locale gelesen wurde oder ein Wert aus der falschen Position stammt. Ein Ergebnis kann das Schema erfüllen und trotzdem teure Fehler im Geschäftsprozess verursachen.
Mit Custom Analyzern können Entwickler jedes Feld in natürlicher Sprache beschreiben, was Microsoft als flexiblen Zero-Shot-Ausgangspunkt bezeichnet. Für spezialisierte Anwendungen müssen Teams womöglich dennoch repräsentative Dokumente testen, annotierte Beispiele ergänzen und Felddefinitionen verfeinern. Die Plattform erleichtere diese Arbeit, mache sie aber nicht überflüssig, so das Unternehmen.
Was ein vorgefertigter Analyzer liefert
Ein domänenspezifischer vorgefertigter Analyzer bündelt ein gepflegtes Schema mit Wissen darüber, wie Felder ausgedrückt werden, wo sie typischerweise stehen, wie zusammengehörige Werte verknüpft sind und welche Mehrdeutigkeiten häufig zu Fehlern führen. Microsoft erklärt, die Analyzer anhand repräsentativer Beispiele für jede unterstützte Dokumentenfamilie zu entwickeln, einschließlich Variationen bei Regionen, Layouts und Geschäftsszenarien.
Für unterstützte Felder kann ein vorgefertigter Analyzer drei Dinge zurückgeben:
- Wert: das typisierte, strukturierte Ergebnis, wobei unterstützte Datums- und Zahlenangaben in ein kanonisches Format normalisiert werden.
- Konfidenz: ein Score, der Schwellenwerte für die automatisierte Durchlaufverarbeitung oder die manuelle Prüfung informieren kann.
- Grounding: die Quellstelle, Seite und Koordinaten, die das Ergebnis mit dem Beleg im Dokument verknüpfen.
In einem Workflow der Kreditorenbuchhaltung extrahiert der Analyzer prebuilt-invoice Bestellnummern und einzelne Positionsbeträge samt Konfidenzwerten und Grounding. Der Workflow kann die Ergebnisse anschließend gegen Geschäftsregeln prüfen, die Quelle eines strittigen Werts hervorheben und unsichere Ergebnisse an einen Prüfer weiterleiten.
Microsoft beschreibt mehrere Fälle, in denen Domänenwissen den Unterschied macht. Eine Rechnung kann Zwischensumme, Steuer, Rechnungsbetrag und offenen Saldo enthalten, und der gesuchte Betrag lässt sich leicht mit einer anderen Summe verwechseln. Ersetzt die OCR das Tausendertrennzeichen Komma durch einen Punkt, wird aus $1,000 womöglich $1.000, und wer das als Dezimalzahl parst, verändert den Wert um den Faktor 1.000. Bei einem W-2 trennt der vorgefertigte Analyzer Name und Adresse des Arbeitgebers in Feld c selbst dann, wenn sich der Text über mehrere Zeilen erstreckt. Bei einer tschechischen Rechnung kann ein einfacheres Werkzeug Schwierigkeiten haben, im Kundenblock Číslo účtu (Kontonummer) von IČO (Identifikationsnummer) zu unterscheiden.
Kombinierte Lösungen für gemischte Dokumentensätze
Der Katalog umfasst außerdem kombinierte Lösungen für Beschaffung, US-Steuern und US-Hypothekenaufnahme. Sie verbinden Klassifizierung und Routing mit spezialisierter Extraktion. Eine Anwendung schickt jedes Dokument an einen Analyzer auf Familienebene, der die Dokumentabschnitte klassifiziert und an den passenden Extraktor und das passende Schema weiterleitet. Microsoft nennt als Beispiel einen Dienst zur Hypothekenaufnahme, der Dateien an den Analyzer prebuilt-mortgage.us übergibt, statt sich auf Dateinamen zu verlassen oder einen eigenen Formularklassifikator zu pflegen.
Der Benchmark mit Steuerformularen
Advanced Contextualization ist laut Microsoft der jüngste Ansatz, dieses Domänenwissen zur Laufzeit wirtschaftlich anzuwenden und dabei Qualität, Kosten und Latenz auszubalancieren. Das Unternehmen bewertete seine neuesten vorgefertigten Steueranalyzer über 19 US-Steuerformular-Kategorien und verglich Azure Document Intelligence, Azure Content Understanding 1.0 GA und Azure Content Understanding 2.0 Preview mit Advanced Contextualization. Die folgenden Zahlen sind gleichgewichtete Mittelwerte der 19 Kategoriewerte.
- Azure Document Intelligence: 96,71 % mittlerer F1-Wert, 10 $ mittlere modellierte Kosten pro 1.000 Seiten, Latenzindex 4,4.
- Azure Content Understanding 1.0 GA: 97,41 % mittlerer F1-Wert, 16,23 $, Latenzindex 10.
- Azure Content Understanding 2.0 Preview: 99,32 % mittlerer F1-Wert, 8 $, Latenzindex 4,9.
Gegenüber 1.0 GA verbesserte die 2.0 Preview den mittleren F1-Wert um 1,91 Prozentpunkte, senkte die mittleren modellierten Kosten um 51 % und die mittlere Latenz um 51 %. Gegenüber Azure Document Intelligence lag ihr mittlerer F1-Wert um 2,61 Prozentpunkte höher und die modellierten Kosten um 20 % niedriger, während die mittlere Latenz um 10 % höher ausfiel. Nach Kategorien betrachtet erzielte die 2.0 Preview in 17 Kategorien einen höheren F1-Wert als 1.0 GA, war in 18 schneller und hatte in allen 19 niedrigere modellierte Kosten.
Was das für Entwickler bedeutet
Microsofts Argument lautet, dass Entwickler von einer gepflegten Basis ausgehen können, statt selbst Dokumentvarianten zu sammeln, gängige Felder zu annotieren und Extraktionskonventionen zu entwickeln. Sie können sich dann darauf konzentrieren, welche Felder wichtig sind, welche Geschäftsregeln gelten und welche Fälle geprüft werden müssen.
Das Unternehmen weist darauf hin, dass es sich bei den Kostenangaben um modellierte Benchmark-Schätzungen handelt. Die tatsächlichen Kosten hängen von den jeweils geltenden Zählern für Inhaltsextraktion und Contextualization, der Nutzung von Foundry-Modellen und den aktuellen Preisen ab. Microsoft rät, die Nutzungswerte der API zusammen mit den aktuellen Preisinformationen heranzuziehen, um die Kosten einer Workload abzuschätzen. Die Ergebnisse der Version 2.0 beziehen sich zudem auf eine Preview-Version.
Microsoft Foundry: Azure Content Understanding Prebuilt Analyzers: packaging domain knowledge for document AI