Cartesia: Pretokenisierung ist ein verborgener Prior, der die Lernqualität von Modellen prägt
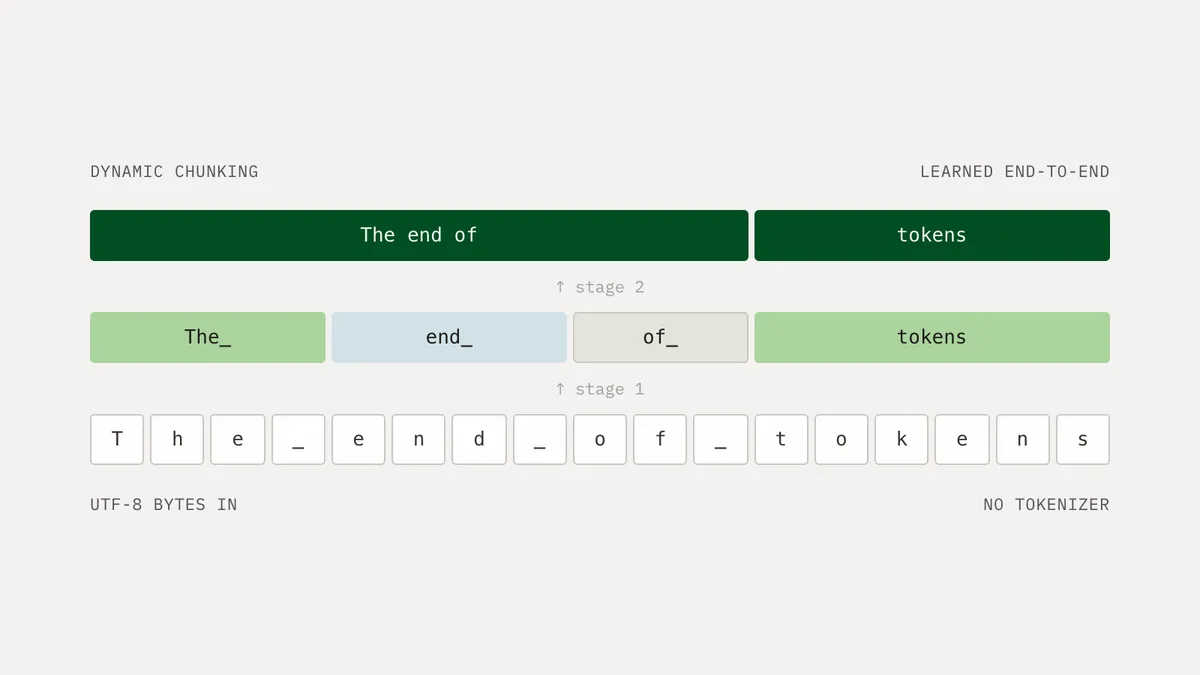
Cartesia hat den zweiten Teil seiner Reihe "From Tokens to Bytes" veröffentlicht. Darin argumentiert das Unternehmen, dass die Art, wie ein Sprachmodell seine Eingaben verarbeitet, sei es durch Tokenisierung oder Chunking, eng damit zusammenhängt, wie gut es Daten versteht. Hierarchische H-Nets verbänden die Recheneffizienz tokenisierter Modelle mit der Generalisierungsfähigkeit von Modellen auf Byte-Ebene, so das Unternehmen.
- Cartesias zweiter Beitrag zu Tokens to Bytes vergleicht Byte Transformer, BPE mit und ohne Pretokenisierung, H-Net und BLT.
- Laut dem Unternehmen sind tokenisierte Modelle recheneffizienter, Modelle auf Byte-Ebene generalisieren besser, und H-Nets erreichen beides.
- Cartesia bezeichnet die Annahme, Tokenizer beeinflussten Loss-to-Loss-Gesetze nicht, als Mythos.
- Pretokenisierungs-Regexes sind laut Cartesia handgebaute Priors, die nicht aus Daten gelernt werden.
- Genannte H-Net-Compute-Multiplikatoren: 1,3x steigend auf 2x bei einer vielfältigen Mischung sowie 2x steigend auf 5x bei Sprachen außerhalb der Trainingsdomäne.
Die Frage: Was bringen handgebaute Priors?
Der Beitrag fragt, welche Zielkonflikte zwischen verschiedenen Ansätzen bestehen, wenn das Ziel darin besteht, das bestmögliche Sprachmodell ohne Priors zu trainieren, und wie viel diese Priors derzeit beitragen. Um das zu beantworten, untersucht Cartesia zwei Arten von Skalierungsgesetzen. Das erste ist Compute-to-Loss, das gängige Maß dafür, wie effizient ein Modell vortrainiert wird. Das zweite ist Loss-to-Loss: Es setzt die Stärke des Pretrainings (gemessen in Loss oder Bits-per-Byte) in Beziehung zur Leistung bei nachgelagerten Aufgaben. Die Loss-to-Loss-Beziehung nutzt Cartesia als Indikator dafür, wie gut ein vortrainiertes Modell seine Daten tatsächlich versteht.
Das Unternehmen vergleicht eine Reihe kontrollierter Modelle: einen Byte Transformer, BPE ohne Pretokenisierung, BPE mit Pretokenisierung, H-Net und BLT (Byte Latent Transformer). Ziel ist es zu sehen, wie sich Entscheidungen bei der Verarbeitung der Eingabedaten auf die Leistung auswirken.
Ein Spannungsfeld zwischen Effizienz und Generalisierung
Laut Cartesia zeigt sich ein zentrales Spannungsfeld. Gängige Sprachmodelle, die komprimierte Eingaben verarbeiten, sind recheneffizienter, während Modelle mit Zugriff auf feinkörnigere Daten wie Bytes besser generalisieren. H-Nets vereinten die Vorteile beider Welten, und das Unternehmen legt nach eigenen Angaben Belege dafür vor, dass ihre Ende-zu-Ende-Natur dafür entscheidend ist. Zudem beschreibt es ein Muster: Die Qualität der Eingabeverarbeitung eines Modells scheint stark mit seiner Fähigkeit zu korrelieren, die Daten zu verstehen.
Der Beitrag erinnert an Ergebnisse aus dem ersten Teil der Reihe: Der relative Rechenvorteil eines H-Nets wächst vom Pretraining-Loss auf der Trainingsverteilung hin zu nachgelagerten Verteilungen. Cartesia nennt einen Compute-Multiplikator von 1,3x bei einer vielfältigen Datenmischung, der bei nachgelagerten Evaluierungen auf 2x steigt, sowie einen Multiplikator von 2x auf dem Code-Teilsplit, der bei Sprachen außerhalb der Trainingsdomäne auf 5x steigt.
Außerdem widerspricht Cartesia früheren Arbeiten, die festgestellt hatten, dass der Tokenizer keinen großen Einfluss auf Loss-to-Loss-Gesetze hat (zitiert wird LLMs on the Line, Abbildung 5). Das Unternehmen kündigt an, empirische Belege dafür zu liefern, dass diese Annahme ein Mythos ist.
Pretokenisierung als verborgener Prior
Ausführlich widmet sich der Beitrag der Pretokenisierung, einem Schritt, der das Korpus vor der Tokenisierung mit einem handgeschriebenen regulären Ausdruck vorab segmentiert. Cartesia weist darauf hin, dass diese Regexes immer komplexer geworden sind, und nennt vier Beispiele: das GPT-2-Muster (auch in GPT-3, Falcon, StarCoder2 und EXAONE verwendet), cl100k (GPT-3.5 und GPT-4), o200k (GPT-4o, auch in gpt-oss und MiniMax-M1 im Einsatz) und das Muster von DeepSeek-V3.
Zu den Änderungen zwischen ihnen zählen Kontraktionen ohne Beachtung der Groß- und Kleinschreibung, Zahlen, die alle drei Ziffern getrennt werden, Wörter, die an Groß- und Kleinschreibung getrennt werden, sodass aus CamelCase Camel und Case wird, und bei DeepSeek-V3 ein fest codierter CJK-Bereich, der Ideogramme und Kana abdeckt, nicht aber Koreanisch.
Der offensichtlichste Effekt sei, so Cartesia, die Zerlegung englischen Texts in durch Leerzeichen getrennte Wörter. Ohne sie füllt sich das Vokabular mit Tokens, die wenig Bedeutung tragen, etwa Bruchstücke von Eigennamen wie "North Kore" und "New Yor" oder Tokens, die Satzzeichen, Zeilenumbrüche und Einrückungen überspannen. Das Unternehmen argumentiert, Pretokenizer würden nicht aus Daten gelernt, was der Bitter Lesson zuwiderlaufe, und das Erlernen grundlegender Konzepte wie Wörter aus Bytes sei ein nicht triviales Problem.
BPE ohne Pretokenisierung im Test
Um den Effekt zu isolieren, trainierte Cartesia einen BPE-Tokenizer ohne Pretokenisierung, genannt BPE-NP, im Korpus mit der üblichen Methodik und trainierte eine Skalierungsleiter neu. Für den Byte Transformer trainierte das Unternehmen neue Leitern von Grund auf, jeweils mit eigener Hyperparameter-Abstimmung. Für jeden Lauf, auch für solche abseits der Compute-optimalen Grenze, trug es die Validierungs-Bits-per-Byte gegen die Bits-per-Byte auf der Evaluierungssuite OLMES ab. Die Läufe liegen auf einer glatten Kurve, die das Loss-to-Loss-Gesetz der Leiter bildet.
Cartesia zufolge zeigt BPE-NP einen interessanten Zielkonflikt zwischen Compute-to-Loss- und Loss-to-Loss-Verhalten, und die BPE-Tokenisierung verbessere gegenüber Modellen auf Byte-Ebene beim Compute-to-Loss spürbar. Der vorliegende Text endet an dieser Stelle, die vollständigen Ergebnisse sind daher hier nicht abgedeckt.
Was das bedeutet
Der Beitrag legt nahe, dass Entscheidungen, die meist als Vorverarbeitung gelten, etwa das Tokenizer-Design und Pretokenisierungs-Regexes, beeinflussen könnten, wie gut ein Modell generalisiert, und nicht nur, wie günstig es sich trainieren lässt. Wer Architekturen anhand von Skalierungsgesetzen vergleicht, muss laut Cartesias Argumentation damit rechnen, dass sich Loss-to-Loss-Beziehungen zwischen Methoden der Eingabeverarbeitung unterscheiden und nicht ohne Weiteres zwischen Modellfamilien übertragbar sind.
Cartesia: From Tokens to Bytes II: Learning from Raw Data | Cartesia