Cartesia zeigt: Hierarchische H-Nets können den Rechenbedarf von Sprachmodellen auf Byte-Ebene senken
Cartesia zufolge kann die hierarchische Netzwerkarchitektur H-Net die Tokenisierung in Sprachmodellen ersetzen und in kontrollierten Tests bis zu 3-5x mehr Recheneffizienz liefern. Im ersten von zwei Beiträgen berichtet das Unternehmen außerdem, dass ein zweistufiges H-Net ein vergleichbares Open-Source-Modell mit 10x weniger Rechenaufwand und Daten übertrifft.
- Cartesia zufolge liefern einstufige H-Nets durch gelernte Tokenisierung bis zu 3-5x mehr Recheneffizienz.
- Ein zweistufiges H-Net übertrifft Berichten zufolge ein vergleichbares Open-Source-Modell mit 10x weniger Rechenaufwand und Daten.
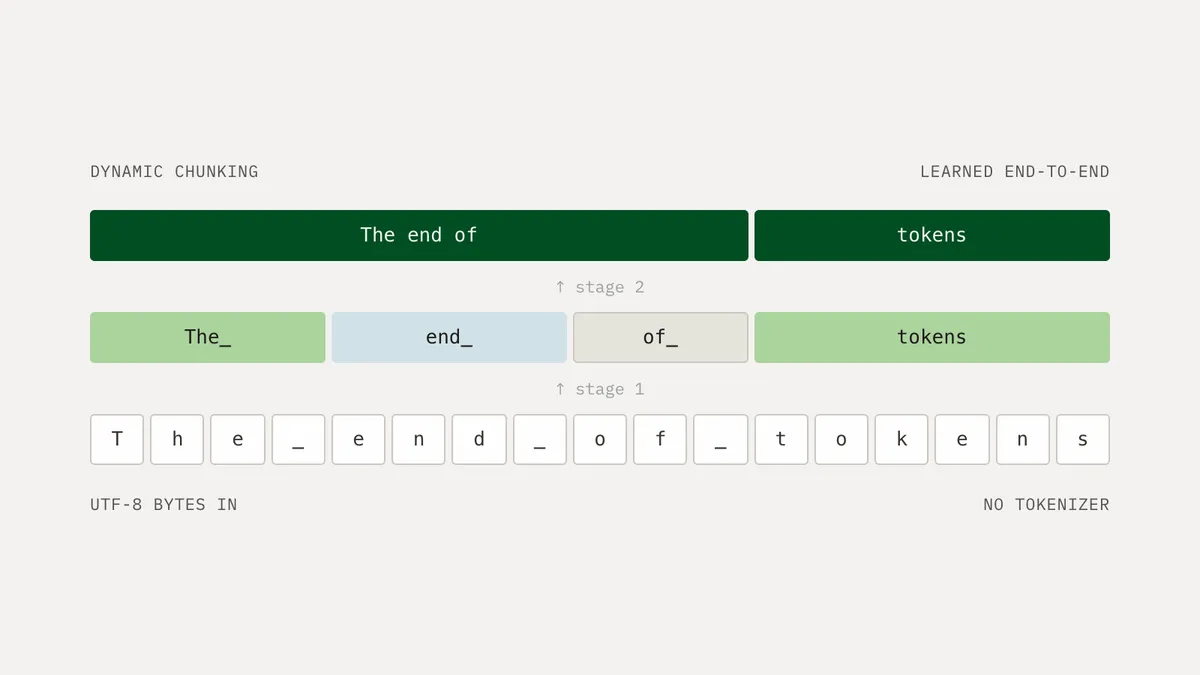
- H-Nets fassen Bytes dynamisch im Modell zusammen, statt Offline-Tokenizer wie BPE zu nutzen.
- Cartesia plant die Veröffentlichung der verbesserten H-Net-Version und erforscht Anwendungen in Biologie und Bildverarbeitung.
- Ein zweiter Beitrag soll klären, warum H-Nets für die Sprachmodellierung so effizient sind.
Was H-Nets leisten
Hierarchische Netzwerke, kurz H-Nets, hat Cartesia 2025 als durchgängige Architektur vorgestellt, die mehrere Abstraktionsebenen in Daten modelliert. Laut dem Unternehmen soll ein Modell Daten auf niedriger Ebene rekursiv zu Einheiten mit höherer Bedeutung zusammenfassen: Zeichen zu Wörtern, Wörter zu Phrasen, Phrasen zu Konzepten.
Für die Sprachmodellierung bedeutet das in der Praxis: H-Nets ersetzen die Tokenisierung. Standardmodelle setzen auf einen Vorverarbeitungsschritt, der Bytes in Tokens umwandelt, also in Blöcke fester Bytefolgen. H-Nets nehmen dieses Chunking stattdessen dynamisch innerhalb des Modells vor. Cartesia betont, das Entscheidende sei, dass dies hierarchisch und durchgängig geschehe, während tokenisierte Modelle und andere Alternativen mehrere Trainingsphasen nutzten und das Chunking komplett offline erledigten.
Die Architektur besteht aus fünf Modulen: Ein Encoder liest die Eingaben, ein gelernter Chunking-Schritt komprimiert sie, ein Hauptnetz arbeitet auf den groben Chunks, die Chunks werden wieder auf die Auflösung der Eingabe dekomprimiert und mit einem Residual summiert, und ein Decoder schließt die Verarbeitung ab. Ein einstufiges H-Net führt eine Chunking-Ebene aus, das Hauptnetz kann selbst wieder ein H-Net sein, wodurch sich Stufen verschachteln lassen.
Warum die Tokenisierung im Fokus steht
Cartesia ordnet die Arbeit in den Kontext der „bitteren Lektion“ ein, der These aus Richard Suttons Essay von 2019, wonach allgemeine, mit der Rechenleistung skalierende Methoden handgebauten Vorannahmen überlegen sind. Sprachmodelle folgten diesem Prinzip weitgehend, hingen aber weiterhin von handgefertigten Schritten wie Tokenizern ab, die nach Ansicht des Unternehmens das End-to-End-Lernen aus den zugrunde liegenden Daten behindern.
Modelle können Text nicht direkt lesen und verarbeiten Tokens aus einem festen Vokabular. Mit den 256 Bytewerten ergibt sich ein Token pro UTF-8-Byte, doch solche Sequenzen sind lang und teuer in der Verarbeitung. Byte Pair Encoding (BPE) begegnet dem, indem es auf einem festen Korpus wiederholt das häufigste Paar benachbarter Tokens zusammenführt, bis das Vokabular eine festgelegte Größe erreicht, etwa 128k bei Llama-3.2. Bei Cartesias Datenmix deckt jedes BPE-Token rund 4,57 Bytes ab. Das Unternehmen weist darauf hin, dass diese Kompression fest vorgegeben ist und die Tokenisierung einer der letzten handgestalteten Teile der Pipeline bleibt.
Skalierungsleiter und berichtete Ergebnisse
Die ursprüngliche H-Net-Arbeit konzentrierte sich auf Sprachmodelle bestimmter fester Größen und Datenmengen, etwa Modelle mit rund 1,3 Mrd. Parametern, trainiert auf 100 Mrd. Tokens aus FineWeb-Edu. Cartesia zufolge fehlten compute-optimale Skalierungsgesetze, die inzwischen ein Standardmaß für Innovationen im Pretraining sind. Als Referenz nennt das Unternehmen die Arbeiten von Kimi zu Kimi Delta Attention (KDA) und Attention Residuals, bei denen Compute-Multiplikatoren von 1,16x und 1,25x gemessen wurden.
Um die verbesserte Architektur zu testen, baute Cartesia eine Skalierungsleiter für einen BPE-Transformer als Baseline, nach gängigen Standards und unter Reproduktion von Ergebnissen aus der Literatur. Das Unternehmen glich die Trainingsmischung an und trainierte für die Baseline einen BPE-Tokenizer neu. Anschließend wandelte es jede Stufe als Drop-in-Ersatz in ein H-Net auf Byte-Ebene um und übernahm dabei Architektur und Hyperparameter des BPE-Backbones. Laut Cartesia zeigte dieses Vorgehen einen besseren Validierungsverlust (1,3x).
Cartesia berichtet, dass sorgfältig kontrollierte einstufige H-Nets allein durch gelernte Tokenisierung Recheneffizienzgewinne von bis zu 3-5x bringen. Ein flexibleres zweistufiges H-Net übertreffe zudem ein vergleichbares Open-Source-Modell mit 10x weniger Rechenaufwand und Daten.
Jenseits von Text und wie es weitergeht
Das Unternehmen gibt an, die von H-Nets gelernten Muster analysiert und dabei Verhaltensweisen gefunden zu haben, die bei Sprachmodellen bislang nicht beobachtet wurden, etwa In-Context-Tokenisierung. Zudem verweist es auf laufende Forschung in Biologie und Bildverarbeitung und argumentiert, H-Nets könnten mit jeder Art von Daten arbeiten, auch mit kontinuierlichen, bei denen die Tokenisierung eine große Herausforderung darstellt.
Cartesia zufolge ist die für diese Ergebnisse genutzte H-Net-Version deutlich besser als die frühere, und das Unternehmen plant, sie zu veröffentlichen. Ein zweiter Beitrag soll ein größeres Spektrum an Modellen untersuchen und erklären, warum H-Nets für die Sprachmodellierung so viel effizienter sein können. Alle genannten Zahlen sind Angaben von Cartesia aus dem eigenen Blogbeitrag; der vorliegende Quelltext enthält keine vollständigen Benchmark-Details.
Cartesia: From Tokens to Bytes I: Scaling Hierarchical Networks | Cartesia