CodeRabbit Security führt Schwachstellen-Benchmark an und lässt Devin und Codex hinter sich
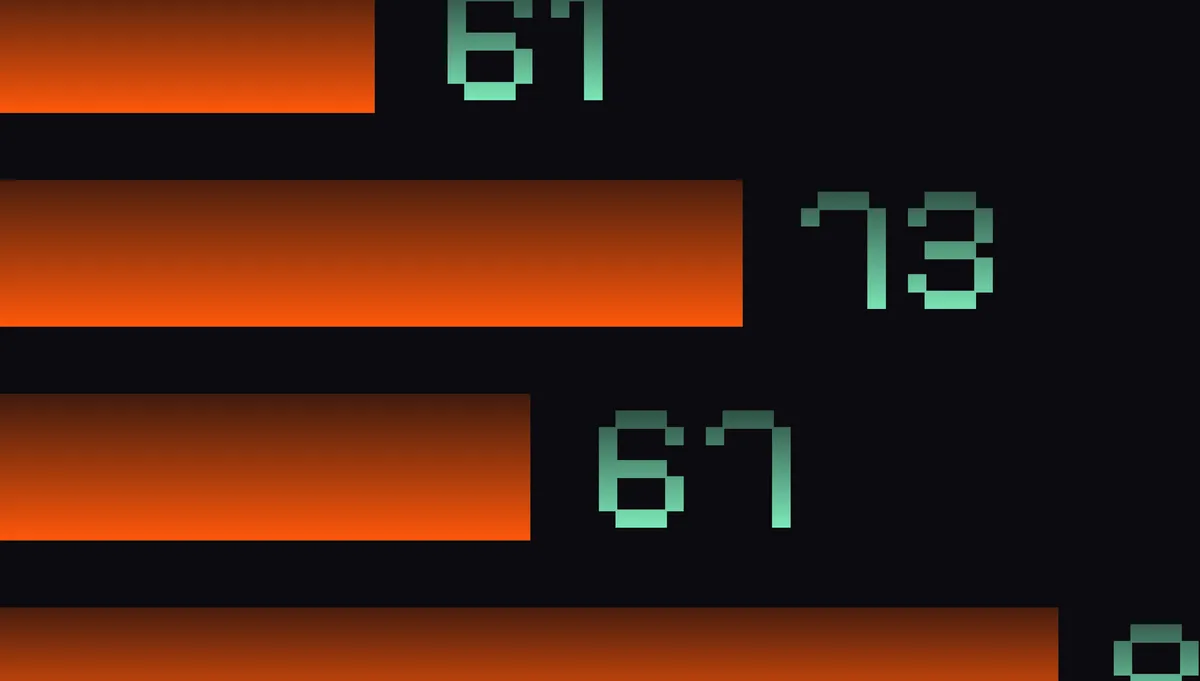
CodeRabbit zufolge hat der hauseigene Agent CodeRabbit Security in einem internen Benchmark mit Open-Source-Code 86,7 % der bekannten Schwachstellen erkannt. Dahinter folgen Devin (73,3 %), Codex Security Plugin (62,0 %) und Claude Security (40,0 %). Das Unternehmen hat die Ergebnisse selbst veröffentlicht und beschreibt sie als Resultat eines internen vergleichenden Entwicklungsausschnitts.
- CodeRabbit meldet eine Schwachstellenerkennung von 86,7 %, gegenüber Devin mit 73,3 %, Codex Security Plugin mit 62,0 % und Claude Security mit 40,0 %.
- Das Testfeld umfasst 100 Schwachstellen aus 94 Repositories, 11 Sprachen und 11 Schwachstellenfamilien, entnommen aus der GitHub Advisory Database und OSV.
- Die Ergebnisse stammen aus einem internen vergleichenden Entwicklungsausschnitt und messen nur die Erkennung, nicht die Qualität von Korrekturen.
- CodeRabbit Security arbeitet in den Stufen Map, Hunt, Verify und einem optionalen Fix.
- Das Unternehmen räumt ein, dass eine mögliche frühere Kenntnis öffentlicher Schwachstellen aus dem Training eine Einschränkung bleibt.
Was der Benchmark ergeben hat
CodeRabbit hat sein eigenes Produkt und drei weitere Systeme darauf getestet, wie gut sie bekannte Schwachstellen in Open-Source-Repositories finden. Laut Unternehmen lauten die Erkennungsraten: CodeRabbit 86,7 %, Devin 73,3 %, Codex Security Plugin 62,0 % und Claude Security 40,0 %.
CodeRabbit Security hat das Unternehmen vor einigen Monaten auf den Markt gebracht. Es basiert nach Angaben von CodeRabbit auf KI-gestütztem Reasoning und kann tiefliegende, komplexe Schwachstellen im Code aufspüren. Der Benchmark misst ausschließlich die Erkennung. Die Qualität von Korrekturen fließt nicht in die berichtete Bewertung ein.
Außerdem sagt CodeRabbit, der Benchmark erlaube es, nachzuvollziehen, an welcher Stelle die Analyse scheitert, wenn eine Schwachstelle übersehen wird. Ein Einstiegspunkt bleibt womöglich unentdeckt, eine nützliche Hypothese geht zwischen den Stufen verloren, oder ein berechtigter Fund wird bei der Verifikation verworfen. Jeder dieser Fehler zeige, so das Unternehmen, konkrete Ansatzpunkte, an denen sich die Pipeline weiter verbessern lasse.
So wurde der Test aufgebaut
Die Fälle stammen aus der GitHub Advisory Database und der OSV-Datenbank. Das Testfeld umfasst 100 Schwachstellen in 94 Repositories, 11 Programmiersprachen und 11 Schwachstellenfamilien. Nach Schweregrad sind es 12 kritische, 50 hohe und 38 mittlere Fälle. Sie reichen von Authentifizierung, Autorisierung, Injection, Deserialisierung, SSRF, XSS und Kryptografie über Datenpreisgabe, Pfadbehandlung und Protokollintegrität bis zu Denial of Service.
Für jeden Fall ermittelt CodeRabbit den Commit, der die Schwachstelle behoben hat, sowie dessen direkten Vorgänger und prüft, ob dieser den verwundbaren Code enthält. Jedes System erhielt den verwundbaren Quellcode, wobei Advisory und Patch zurückgehalten wurden. Git-Verlauf und Remotes wurden entfernt, die Scans liefen ohne Netzwerkzugriff. Auch Advisory, GHSA- oder CVE-Kennung, CWE-Klassifizierung, Schweregrad, Repository-Identität, verwundbare Datei, Zielzeilen, Fix-Commit und gepatchter Quellcode blieben aus den Benchmark-Anweisungen heraus.
CodeRabbit räumt eine Einschränkung ein: Da die Schwachstellen und Repositories öffentlich sind, bleibt eine mögliche frühere Kenntnis aus dem Modelltraining ein eigenes Thema. Das Unternehmen betrachtet den Aufbau vor diesem Hintergrund als kontrollierten Test der Wiederauffindung von Schwachstellen.
Um gewertet zu werden, muss ein Fund den zugrunde liegenden Mechanismus der gelabelten Schwachstelle an einer akzeptierten Quellcodestelle treffen. Eine andere Schwachstelle in derselben Datei bringt keine Punkte, und eine übereinstimmende CWE-Klassifizierung genügt nicht, wenn der Bericht einen anderen Angriffsweg beschreibt. Duplikate zählen einmal, Infrastrukturfehler werden getrennt von Fehlern der Modelle erfasst.
Die vierstufige Pipeline
CodeRabbit Security arbeitet in Stufen: Map, Hunt, Verify und ein optionaler Fix.
- Map: KI-Agenten erkunden das Repository in einer sicheren Sandbox und erstellen eine Karte des Gesamtsystems. Sie identifizieren Einstiegspunkte, Vertrauensgrenzen, Authentifizierungs- und Autorisierungsprüfungen sowie einen Erreichbarkeitsgraphen, der von außen zugängliche Eingaben mit dem Code verknüpft, den sie beeinflussen können.
- Hunt: Spezialisierte Agenten untersuchen Risikobereiche parallel, darunter Autorisierung, Injection, Geschäftslogik, Datenpreisgabe und KI-spezifische Bedrohungen. Sie verfolgen vom Angreifer kontrollierte Eingaben vom Einstiegspunkt bis zur Senke.
- Verify: Ein unabhängiger Verifizierer öffnet die genannten Pfade erneut und prüft Erreichbarkeit, Schutzmaßnahmen an anderer Stelle der Anwendung, Ausnutzungsbedingungen und ob die Belege die behauptete Auswirkung stützen. Kandidaten, die auf reinem Testcode oder unerreichbarem Code beruhen, bestehende Schutzmechanismen ignorieren oder auf unbelegten Annahmen fußen, werden verworfen.
- Fix: Für geeignete Funde erstellt Fix with AI auf einem Security-Branch einen eng gefassten Korrekturvorschlag und eröffnet einen prüfbaren Pull Request oder Merge Request.
Wenn die Belege in keine Richtung eine Schlussfolgerung stützen, sagt das System nach Angaben von CodeRabbit genau das, statt eine unvollständige Analyse als Beweis für Ausnutzbarkeit oder für ein sicheres Repository zu werten.
Modellmix und die Rolle des Harness
CodeRabbit sagt, es habe Konfigurationen mit gemischten Modellen mit Setups aus einem einzigen Modell verglichen und beide danach beurteilt, wie viele bekannte Schwachstellen sie wiederfinden und wie gut die Funde Untersuchung, Verifikation und Berichterstattung überstehen. Ein günstigeres Modell in einer Stufe kann die Kosten senken, verringert aber möglicherweise auch die Zahl korrekter Funde, die den Abschlussbericht erreichen. Änderungen wurden deshalb über die gesamte Pipeline hinweg bewertet.
Das Unternehmen argumentiert, ein starkes Harness lasse ein gutes Modell sein Potenzial ausschöpfen, während sich ein schwaches Modell auch durch das beste Harness nicht retten lasse. Es investiere in das Harness ebenso stark wie in die Modellauswahl und passe Modellauswahl und Routing weiter an, sobald neue Modelle verfügbar werden.
Was das bedeutet
Die Zahlen stammen vom Anbieter selbst und beruhen auf einem internen Entwicklungsausschnitt, sind also kein unabhängiger Vergleich. CodeRabbit weist darauf hin, dass die Bewertung nur misst, wie oft ein System das bekannte Ziel erkennt, und dass zusätzliche Funde gesondert bewertet werden müssen. Für Teams, die Security-Scanner evaluieren, zeigt die veröffentlichte Methode, was das Unternehmen als gültige Erkennung zählt: den richtigen Mechanismus, einen erklärten Ausnutzungspfad und eine belegende Quellcodestelle.