Cognition ist erster Kunde auf CoreWeaves NVIDIA Vera Rubin NVL72
CoreWeave hat die Plattform NVIDIA Vera Rubin NVL72 in begrenzter Verfügbarkeit auf CoreWeave Cloud bereitgestellt. Erster Produktivkunde ist Cognition, der Entwickler des KI-Softwareingenieurs Devin. Laut CoreWeave hat Cognition beim Gesamt-Token-Durchsatz für SWE-2-Inferenz eine Steigerung um das 4,8-Fache gegenüber GB200 NVL72 gemessen.
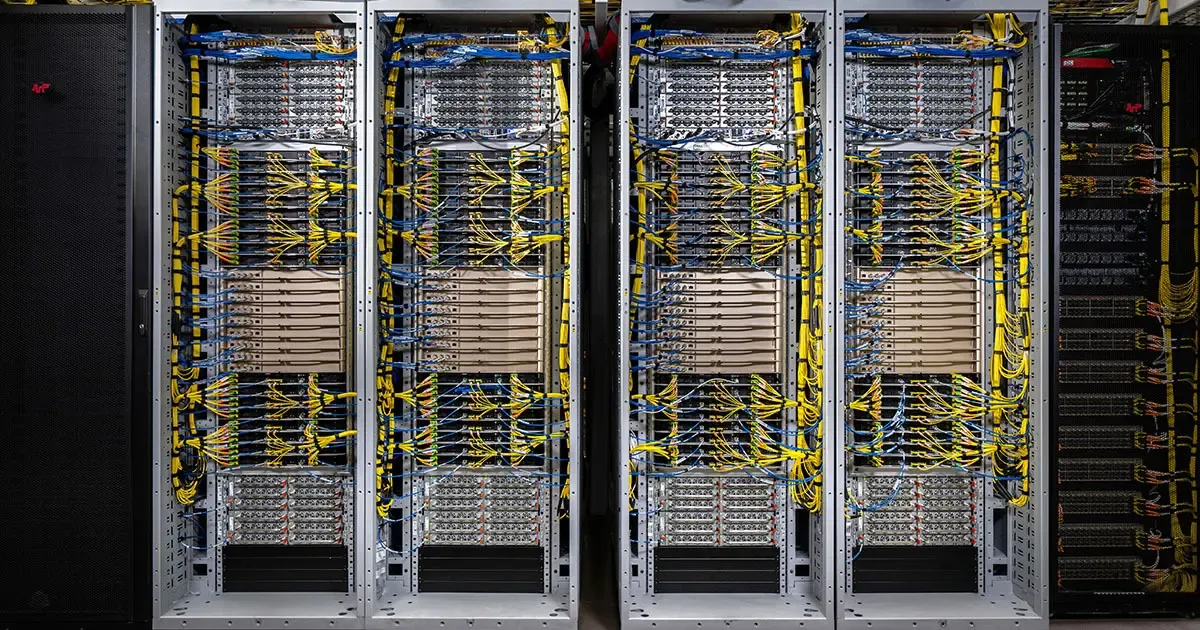
- CoreWeave hat NVIDIA Vera Rubin NVL72 in begrenzter Verfügbarkeit auf CoreWeave Cloud bereitgestellt, mit Hunderten Rubin-GPUs in mehreren Regionen.
- Cognition, der Entwickler von Devin, ist der erste Kunde, der produktive agentische KI-Workloads auf der Plattform betreibt.
- Cognition meldet gegenüber GB200 NVL72 einen 4,8-fachen Gesamt-Token-Durchsatz bei SWE-2-Inferenz und einen 3,8-fachen Output-Token-Durchsatz beim RL.
- Laut CoreWeave führte Cognition bereits wenige Tage nach der Rack-Übergabe Produktiv-Workloads aus.
- Interessierte Teams können ein Briefing oder einen ARENA Pass anfragen, um eigene Workloads zu testen.
Begrenzte Verfügbarkeit und erster Produktivkunde
Nach Angaben von CoreWeave sind Hunderte NVIDIA-Rubin-GPUs in mehreren Regionen im Einsatz, und das Unternehmen hat begonnen, Kunden-Workloads im Produktivbetrieb aufzunehmen. Cognition ist der erste Kunde, der produktive agentische KI-Workloads auf die Plattform bringt.
Der Zugang ist an CoreWeaves breiteren Stack gekoppelt. Laut dem Unternehmen können Kunden Vera-Rubin-NVL72-Kapazitäten über CoreWeave Kubernetes Service (CKS), CoreWeave Inference, CoreWeave SUNK, CoreWeave AI Object Storage und CoreWeave Mission Control nutzen. CoreWeave richtet das Angebot auf rechenintensives Training, agentische Inferenz mit hohem Durchsatz und niedriger Latenz sowie die Steuerung durchgängiger KI-Pipelines aus.
Außerdem gibt das Unternehmen an, dass die Ingenieure von Cognition bereits wenige Tage nach der Rack-Übergabe Produktiv-Workloads ausgeführt haben, ohne eigene, individuelle Inbetriebnahmearbeiten leisten zu müssen. CoreWeave wertet das als Beleg für die Produktionsreife.
Wie Cognition die Plattform nutzt
Devin wird als autonomer KI-Softwareingenieur beschrieben, der gemeinsam mit Entwicklungsteams komplexe, durchgängige Aufgaben übernimmt. Die Arbeit kann sich über ganze Code-Repositories erstrecken und lange Ketten aus Schlussfolgern, Codegenerierung, Debugging, Ausführung, Bewertung und Iteration umfassen.
Cognition betreibt sowohl das Modelltraining als auch die Inferenz im Produktivbetrieb auf derselben Bare-Metal-Plattform von CoreWeave Cloud. CoreWeave nennt vier Bereiche:
- Inferenz im Produktivbetrieb: agentische Anfragen in Echtzeit, weltweit bereitgestellt über CoreWeave Inference.
- Inferenz-Optimierung: Zusammenarbeit mit CoreWeave-Performance-Ingenieuren bei KV-Cache-Management, Serving-Parametern und Laufzeitkonfigurationen.
- Experiment-Tracking: Weights & Biases Models zur Überwachung und Auswertung von Experimenten über Trainingsläufe hinweg.
- Training und Reinforcement Learning: Pre-Training im großen Maßstab, Fine-Tuning, RL-Post-Training und Test-Time-Scaling für Devin-Modelle.
CoreWeave ergänzt, Cognition sei von anfänglicher Überbrückungskapazität auf Tausende GPUs für Training und dedizierte Inferenz in seiner Cloud gewachsen.
Benchmark-Ergebnisse und Hardware-Daten
Das Engineering-Team von Cognition hat auf CoreWeave eigene, unabhängige Benchmarks durchgeführt und dabei Vera Rubin NVL72 mit den Vorgängerreferenzen GB200 NVL72 verglichen. Als Grundlage diente SWE-2, das laut Quelle jüngste Generation des autonomen KI-Softwareingenieurs des Unternehmens.
- Inferenz: 4,8-fache Steigerung beim Gesamt-Token-Durchsatz. CoreWeave gibt an, dass Vera Rubin NVL72 bei gleicher Interaktivität bis zum 4,8-Fachen des Gesamt-Token-Durchsatzes pro GPU von GB200 NVL72 erreicht.
- Reinforcement Learning: 3,8-fache Steigerung beim Output-Token-Durchsatz, laut CoreWeave pro GPU bei gleicher Interaktivität. Cognition erzeugt im Post-Training große Mengen an Trial-and-Error-Denkpfaden, sodass höhere Ausgabegeschwindigkeit die Iteration neuer Modellgewichte beschleunigt.
Silas Alberti, SVP Research and Founding Team bei Cognition, sagte, bei einem agentischen Workload, in dem jeder Schritt auf den vorherigen wartet, summiere sich der Gewinn zu "echter Arbeit, die Devin erledigt".
Bei der Hardware beschreibt CoreWeave Vera Rubin NVL72 als einheitliche, flüssigkeitsgekühlte Plattform, die als eine einzige logische GPU konzipiert ist. Sie vereint 72 Rubin-GPUs, verbunden über NVIDIA NVLink 6, sowie 36 Vera-CPUs. Die Quelle nennt 1.400 TB/s HBM4-Speicherbandbreite und 216 TB/s NVLink-Bandbreite und gibt an, die Plattform könne Modelle mit Billionen Parametern verarbeiten und Rollouts bei 45-fach niedrigeren Token-Kosten gegenüber Blackwell skalieren.
Was das für Kunden bedeutet
Für Teams, die Agenten entwickeln, lautet die zentrale Aussage: Schnellere Verarbeitung in jedem Schritt einer Schleife aus Schlussfolgern, Abrufen, Ausführen und Wiederholen summiert sich über den gesamten Workflow. Agenten erledigen so mehr Arbeit in kürzerer Zeit und zu geringeren Kosten. Die Zahlen stammen aus Cognitions eigenen SWE-2-Workloads und von CoreWeave, bei anderen Workloads können die Ergebnisse abweichen.
Die Verfügbarkeit ist begrenzt und richtet sich an ausgewählte Kunden. CoreWeave lädt interessierte Teams ein, ein Briefing zu Kapazitätsplanung, Onboarding-Zeitplan und Eignung des Workloads anzufragen oder einen ARENA Pass zu beantragen, um den eigenen Workload auf Vera Rubin NVL72 auszuführen.